監督たちの甲子園(v1.3.5) 新規ユーザー分析

私は運営するゲームの分析を日常的に行い、機能の改善を行っています。
元々ゲーム運営のアナリスト(コンサルタント)をしていたので、ゲームの分析はチョットワカルかもしれません。

今回は、ゲームの状況をかんたんに確認するために、新規ユーザーの継続率を分析していきます。

前提

・Unity Analyticsで分析した結果です。
Unity Analytics > SQL データエクスプローラーを利用しています。
SQLの種類はPostgreSQLベースに見えます。

・全ユーザーは含んでいないログです。
(上手く取れないユーザーがかなりいる模様…)

・SQLコードを公開します。
自身のゲームの分析などにご自由にお使いください。

分析したゲームはこちら

監督たちの甲子園 世紀の逆転劇

新規ユーザーの分析

まず、分析するにあたって対象ユーザーと指標を確認しましょう。

対象ユーザー

新規ユーザーとは、ゲームを開始してすぐのユーザーのことです。
※対して、既存ユーザーはゲームを開始して何日か経過して継続しているユーザーのことを言います。

指標:継続率

継続率は、対象となるユーザーが、対象となる経過日(24時間以内)にログインしている割合を確認します。

継続とは、
DAY1であれば、新規登録後24~48時間にログインしている人をいいます。
DAY3であれば、新規登録24*3~24*(1+3)時間にログインしている人、
DAY7であれば、新規登録24*7~24*(1+7)時間にログインしている人、
DAY14であれば、新規登録24*28~24*(1+14)時間にログインしている人、
DAY28であれば、新規登録24*28~24*(1+28)時間にログインしている人です。
※DAY1, 3, 7, 14, 28の日の区切りはゲームや会社によって変わります。

この指標は「毎日ログインすることが当たり前のゲーム」で採用されやすいです。
毎日プレイすることが必須ではない場合、以下の継続率(Week版)のような指標を入れてみることがあります。

指標:継続率(Week版)

継続率(Wide版)は、継続の判定幅を広くした継続率のことです。

継続(Week版)とは、
DAY1であれば、新規登録後24~24*(1+7)時間にログインしている人をいいます。
つまり、1日後から1週間以内にログインしている人を示します。

この指標は「毎日ログインすることが当たり前ではないゲーム」で採用されます。
「1週間に1回は触ってもらえるよね」ってことです。
これは分析の都合上、「ユーザーがゲームから離脱したかどうか」を厳密に判定できないため、かなり幅を持たせて分析をしています。
分析するサービスによって変わるので、調整して使ってみてください。

分析:バージョン別継続率

それでは、ゲームの分析を行ってみます。

ゲームはバージョンアップにより内容が様変わりするため、「継続率を取るにはバージョン別が良いだろう」ということでバージョン別に分析を行います。
加えて、特定のプラットフォーム(iOS/Android/PCなど)に異常がないことを確認するために、プラットフォーム別にも分析します。「プラットフォームの継続率が大きく違う」ことは、異常があると判断できます。

分析からわかること1

では、継続率を見ていきましょう。
初期バージョン(v1.0、v1.1、v1.2)はそれほど指標が変わりません。

テコ入れしたv1.3_1は指標が大きく改善しています。これは良いアップデートだったと言えるでしょう。
ただ、さらにテコ入れしたv1.3_2は初期バージョンより下がっています。これはよろしくないので、元に戻しましょう。

という、数字からゲーム内に何が起こっているかを想像しながら見ていく必要があります。

分析からわかること2

では、プラットフォーム別に見ていきましょう。

・iOSが良さげかも?
・Androidは要改善
・PCは人がいない
※加えて、完全オフラインではログが取れない仕組みなので実態が不明なユーザーもいます。

こちらの数値と外部データを見比べてみると面白いことがわかります。
・App Store(iOS)とGoogle Play(Android)の登録数から、ログが取れないユーザーがいそう。
・App Storeのアプリ保持数は200超だが、Google Playは100いくかどうか。
Google Playユーザーのほうがアプリを消す傾向にあると言えるでしょう。このゲームは400MB近く容量ありますからね…。

分析からわかること3

1日後継続しない人は、1週間にわたって観察してもほぼ継続しないことが読み取れます。DAY1とDAY1(WEEK版)の数値がほぼ同じですし。

ただ、3日後以降はユーザーは思い思いにログインしているようです。なぜなら、DAY3の1日間だけログイン割合より、DAY3~10の間のログイン割合が大きく伸びているからです。
つまり、平均的なユーザーはこのゲームに対してどのような接し方をしているか推察できます。

このデータから追加で、深掘りとして「毎日ログインしているひと」「たまにログインしているひと」の人数を確認して、それぞれに合わせた施策を打つ等を考えていけますね。

分析コード

当ゲームはバージョンの記載方法にCLIENT_VERSION=「X.X.X」を採用しているため、複数バージョンをVERSION_GROUPにまとめています。
ある程度ユーザー数がいないと分析できないので、複数バージョンをまとめるようにしてください。

-- ユーザーIDごとのゲーム開始時間
WITH user_first_start AS (
  SELECT 
    USER_ID
    ,time_start
    ,PLATFORM
    -- バージョンごとに切り分け
    ,CASE
        WHEN CLIENT_VERSION LIKE '1.0.%' THEN 'v1.0.X'
        WHEN CLIENT_VERSION LIKE '1.1.%' THEN 'v1.1.X'
        WHEN CLIENT_VERSION LIKE '1.2.%' THEN 'v1.2.X'
        WHEN CLIENT_VERSION LIKE '1.3.%' THEN 
            CASE
                WHEN CLIENT_VERSION <= '1.3.3' THEN 'v1.3_1'
                WHEN CLIENT_VERSION <= '1.3.5' THEN 'v1.3_2'
                ELSE 'v3_3'
                END
        ELSE 'others'
    END AS VERSION_GROUP
  FROM
    (
        SELECT 
            USER_ID
            ,EVENT_TIMESTAMP AS time_start
            ,PLATFORM
            ,CLIENT_VERSION
            ,ROW_NUMBER() OVER (PARTITION BY USER_ID ORDER BY EVENT_TIMESTAMP ASC) AS rn
        FROM
            EVENTS
    ) AS t
  WHERE
    rn = 1

)
-- 継続率
, user_retention AS (
  SELECT
    fs.USER_ID
    ,fs.time_start
    ,fs.PLATFORM
    ,fs.VERSION_GROUP
    -- 通常判定版(1day内)
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 1, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (1 + 1), fs.time_start)
         THEN 1 ELSE 0 END) AS day1
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 3, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (1 + 3), fs.time_start)
         THEN 1 ELSE 0 END) AS day3
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 7, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (1 + 7), fs.time_start)
         THEN 1 ELSE 0 END) AS day7
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 14, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (1 + 14), fs.time_start)
         THEN 1 ELSE 0 END) AS day14
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 28, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (1 + 28), fs.time_start)
         THEN 1 ELSE 0 END) AS day28
    -- 判定広め版(1week内)
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 1, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (7 + 1), fs.time_start)
         THEN 1 ELSE 0 END) AS day1_w
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 3, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (7 + 3), fs.time_start)
         THEN 1 ELSE 0 END) AS day3_w
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 7, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (7 + 7), fs.time_start)
         THEN 1 ELSE 0 END) AS day7_w
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 14, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (7 + 14), fs.time_start)
         THEN 1 ELSE 0 END) AS day14_w
    ,MAX(CASE WHEN
          e.EVENT_TIMESTAMP > TIMESTAMPADD(HOUR, 24 * 28, fs.time_start)
          AND e.EVENT_TIMESTAMP <= TIMESTAMPADD(HOUR, 24 * (7 + 28), fs.time_start)
         THEN 1 ELSE 0 END) AS day28_w
  FROM
    user_first_start AS fs
  INNER JOIN
    EVENTS AS e
  ON
    fs.USER_ID = e.USER_ID
  GROUP BY
    1, 2, 3, 4
)

-- 日別分析
SELECT
  VERSION_GROUP
  ,PLATFORM
  ,DATE(MIN(time_start)) AS date_min
  ,DATE(MAX(time_start)) AS date_max
  ,COUNT(*) AS count_uu
  ,SUM(day1) / COUNT(*) AS rate_day1
  ,SUM(day3) / COUNT(*) AS rate_day3
  ,SUM(day7) / COUNT(*) AS rate_day7
  ,SUM(day14) / COUNT(*) AS rate_day14
  ,SUM(day28) / COUNT(*) AS rate_day28
  ,SUM(day1_w) / COUNT(*) AS rate_day1_w
  ,SUM(day3_w) / COUNT(*) AS rate_day3_w
  ,SUM(day7_w) / COUNT(*) AS rate_day7_w
  ,SUM(day14_w) / COUNT(*) AS rate_day14_w
  ,SUM(day28_w) / COUNT(*) AS rate_day28_w
FROM
  user_retention
GROUP BY
  1, 2
ORDER BY
  1, 2;

さいごに

今日はかんたんに、新規ユーザーの継続率からゲームの現状を分析しました。
「もっと知りたい」「○○ってどう分析すればいいの?」というコメントをいただければ、記事を書いていきたいと思います。
ぜひコメントくださいませ。( ^^)/
ゲームアプリ運営の分析ノウハウ vol.3 この状態のアプリはやべえ編

はじめに

皆さんお久しぶりです。れいです。
近しい友人(アプリ運営を長年経験)が転職することになり、色々話してみましたがやべえ状態ってあるんやなと思ったので共有します。
これは…他山の石としてください。

この記事はゲームアプリ運営の分析ノウハウ vol.2 新規登録者編の続き…?です。

お題目

特に気になった2論点(組織、アプリ)、それぞれ3点について共有します。

組織目線

・売り上げ目標が昨年度より高い(実績は前年度比でもちろん下がっている)
・収益と給与が連動しない(インセンティブがない)
・広告運用が別組織

アプリ目線

・「いつか終わること」を考えない
・遊びの軸を増やすことをしない
・必殺技(笑)

胃が痛い…(>_<) こうなるとサービス終了しか見えてこないんですよね

売り上げ目標が昨年度より高い(実績は前年度比でもちろん下がっている)

ソーシャルゲームバブル、アプリゲームバブルは終了しました。
アプリゲーム自体、昨年度の売上より今年の売り上げが下がるのは当たり前すぎます。

もし、維持・向上するには?

今売れているタイトルのパターンは、以下4つです。
・超巨大・ハイクオリティ(原神、ウマ娘、鳴潮等)
・覇権(モンスト、パズドラ等)
・ライト系…?(キノコ伝説、異世界のんびりライフ等)
・ハイパーカジュアル
ハイパーカジュアル、これは1つのゲームでの順位は高くないものの大量生産をし、売上の総合力で戦います

超巨大・ハイクオリティを作るにはふつーの会社には無理です。体力(資金力)が足りません。
ライト系、ハイパーカジュアルはゲームらしいゲームじゃないので、そちらに寄せるのは厳しいです。今あるゲームのそのシステムに(多分)合いません。

\(^o^)/オワタ・・・やんけ?
そうです。基本は撤退戦です。
今までが異常だったと言えばそうなんですが、目標を作っている人たちは正常な判断が出来なくなっています。

もしですよ・・・できるならですが、遊び方を変える必要がありますね。
ただし、今よくあるアプリゲームは、作り込みすぎて遊びの幅をほぼ使い尽くしているんですよね。
初期に構想されていた内容を使い切っちゃってる、または度重なるインフレで初期のシステムがオワコンになってることが多く、拡張性がありません。

収益と給与が連動しない(インセンティブがない)

売上向上に強いインセンティブがなく、かつ売上向上の寄与度の分析や、その評価の仕組みもないと厳しいですね。
売れたゲームの保守・運用を行っていればドル箱になっていました。
その際、中の人たちの貢献度を評価しているゲーム会社って相当少なかったです。

ただ、頑張ればアイデアが出て売上が上がるというよりも、ガチャのシステムに売上が依存しているのでこれも厳しいのは厳しいんですが。

ガチャが強すぎて、売上を立てる方法論が開発されてこなかったのもあるでしょう。
最近よく見るのは広告削除だったり、ゲーム内の利便性向上で1,000円~の商品も見かけるようになりましたが、ガチャだと課金者の月平均で15,000円~ですからねえ…。
売上が立つのでそれに合わせて大きくなりすぎました。

商品を新しく作っても支出が大きい場合は焼け石に水なので、撤退戦と位置づけて方法論を考える必要があるかと思います。
売上額ではなく利益率でみるプロジェクトはほぼなかった気がしますね…。

「利益率高く撤退戦ができる人」← 大事

ふつう、プロジェクトを終わらせないように頑張らせるので、いつこの実質:撤退戦が終わるのかもわからない。
それではモチベーションも上がりません。

広告運用が別組織

こちらは割と真面目に、アプリゲームって「広告費を売上にいかに変えるか」がルールです。
特にハイパーカジュアルはその気が強いです。

ゲーム以外の他サービスを運営している会社では結構あるんですが、ゲーム開発と広告運用が別部門って死亡待ったなしなんですよね。
長期目線で顧客との信頼関係を醸成する必要があるようなサービスとは違い、短期スパンでゲーム内・ゲーム外のモノゴトが移り変わるんですよ…。

広告運用の思考がめちゃくちゃ違うんで分けたほうが絶対ええんやけど。
しかも、ゲームタイトルによっても挙動が大きく違うので、ゲーム部門独立かつゲーム別での広告運用をしないと厳しいでしょう。。

「いつか終わること」を考えない

「売上を継続させるためにインフレさせる」という場当たり的な方針が取られることが多いです。
その結果、ゲームが壊れていきます。

遊びの深さ、やり込み度合いはそれで増えるかというと…「その時にプレイしている人」以外には増えないと考えられます。

何故かというと、インフレすることはゲームとして10段階あったはず階段を最上段まで一気に飛ばせるキャラが出てくることと同等です。
「強さ」の軸が少ないと、その間のゲームシステムは死んだも同然です。
何もしなくてもクリアできますから。

新しく出たキャラでもそれらの階段を何等かの創意や工夫があって乗り越えていく(ゲームできる)なら良いですが、そんなにうまくゲームバランスを取れるゲームは稀です。
インフレさせつつ、全体の整合性をもって・・・そんなに考える時間はありません。

つまり、新しく始めた人は実質的に別ゲーをプレイしている状況になります。
ゲームシステムは同じで、どこかバランスがおかしものをプレイすることになります。
それが積み重なっていく。

継続している人も、資産が積み重なっていくことにより、自分の取れる行動に制限がかかっていきます。
ゲームだったものがいつしか作業になります。

その解決策として、「いつか終わらせること」「次につなげること」を提案します。

遊びの軸を増やすことをしない

インフレにも幅があり、遊びの軸・幅を増やすことをしているゲームはほとんどありません。
例えるなら、これまで力が100だったものを1000にして、1万にして…のように直線状に強くしていくだけです。
ボスのHP、防御力だけが増えるとかあるあるですよね。

モンストやパズドラのように「ギミックが増えていく」方向性もありますが、その場合も軸はそれほど増えません。
「ギミックをクリアする」という一定の方向性は変わりません。

遊びの軸を増やす例としては、例えば、モンストであれば、マップに高低差の概念を入れたり、それに関連してキャラクターが地面に居るか一時的に浮遊しているか、のようなものです。

現実のおはじきやピンボールなら、球はふつうに一瞬浮きますからね。
そのように、軸を増やすことによって「考えてクリアする」パターンが増えていきます。

その結果、ルールが複雑化していくので・・・ある程度までで打ち止めしないと理解が追い付かないゲームになってしまい、一般受けしなくなっていきます。
そのため、バランスがいいうちに終わらせることも必要でしょう。

必殺技(笑)

リリース当初であると「必殺技」扱いだった技が、アップデートやインフレを重ねることで無意味な技になりやすいです。
必殺技(笑)ですね。

例えば、敵のインフレに合わせて、各キャラクター固有の技や通常攻撃を強くしていくとします。
必殺技は、キャラ×キャラでの組み合わせで発動すると仮定すると、キャラが増えれば増えるほどアップデートが難しくなります。
組み合わせが爆発するので。
10キャラ10キャラ×10キャラ=100通りですが、100キャラなら1万通りです。

その結果、ある時点からキャラクターの技や通常攻撃のほうが強くなってしまいます。
使いませんよね。

「その必殺技を消す」という方法を取ることができればよいのですが、ゲームシステムの根幹に位置していたりするので消せない、消したら不具合が出る…とかあるあるなんですよね。

これも終わらないからこそ起こる良くない現象です。
ゲーム以外のサービスなら、別に切り出して作るよね?というところで作りません。
全ては延命のためです。

まとめ

これまでの言及をまとめて言うと、

サービスの提供ではなくゲーム、遊びの提供をしてるんやぞ

ってことですね。
そこには、ストーリーがあり、終わりもあります。
便利さで選んでいるわけではないんです。

以上。

ゲームアプリ運営の分析ノウハウ vol.2 新規登録者編

はじめに

アプリ開発者によくある悩み・・・登録者がゲームを続けてくれません!!。
続けてくれないをより細かく言うと、(1)コンテンツを一通りプレイしてもらいたいのか、(2)毎日プレイしてほしいのかによって分析方法が変わります。

どちらかというと(2)の方が難しいので、そちらを新規登録を増やすという観点から解説していきます。
この記事はゲームアプリ運営の分析ノウハウ vol.1 概要編の続きです。

おまけ:(1)コンテンツを一通りプレイしてもらいたいの分析方法

分析するゲームのコンテンツを「一本道のストーリーとする」と、分析をイメージしやすいと思いますのでそちらで解説します。

前提として、ストーリー1~5まで一本道でゲームが進むとします。
分析すべきは、以下の3です。
1・ストーリー1のプレイ人数
2・ストーリー2のプレイ人数
3・ストーリー1→2の移行割合(=分析2の人数/分析1の人数)

ストーリー1~5まで、移行割合が低くなるポイントはどこか?を特定することが重要です。

ちなみに、例えばストーリー3の移行割合が低かったとしても、ストーリー3自体が悪いとは限らないことに注意してください。

想像してみてください。
「つまんねーなコレ」ってなってすぐに離脱します(ゲームやめます)か?

買い切りゲーだと特に、ちょっと違和感があっても買った手前勿体ないので続けるでしょうし、それをやめるような区切りを感じさせたポイントがストーリー3の可能性があります。原因ではないかもしれません。

そのように、離脱ポイントがわかってもすぐに結論に至れず、対策を打ちづらいことが分析の難しさを顕著に表しているでしょう。
そもそも買い切りゲーを分析して意味があるのか議論はあると思います。
アップデートができるならいいですし、次回作が決まっているなら参考になりますね。参考になるって言っても、買い切りゲーは前作とシステムやUIが全く同じでは出しづらい(売れない、目新しさがない)のでなかなか難しかったりする…。某連番ゲームの分析結果を見ましたが、結果は出たものの中身にはなかなか反映されずとかも…。

(2)毎日プレイしてくれません!!

「毎日プレイしてくれません」・・・確かに言いたいことはわかります。ただ、ユーザーがプレイを続けるようになるまでのステップを考えてみましょう。はじめはそうですね・・・アプリストアで見つけるところから始めてみましょうか。

アプリストアで見つける
→インストール(するか迷う。見た目で楽しそうか、競合アプリはどうか、容量との戦いは・・・。)
→新規登録(登録画面がないアプリも多いですね)
→チュートリアル開始(ないアプリも多いですね)
→チュートリアル終了
(高い壁)
→続けたい理由を見つける
(高い壁)
→プレイを続ける

vol.1にソーシャルゲームなら新規登録からの1日後継続率が25%を超えると書きましたが、この(めっちゃ多い)ステップを通して25%・・・?嘘やろって思います。分析するのは、このそれぞれのステップから離脱せず、かつ毎日続けたいようなコンテンツとなっているかどうかです。なんか文字で書くとめっちゃ厳しそう・・・

この目標値を超えてるアプリはすごいと思います。特に、広告経由のユーザーの継続率は酷いものです。
なぜなら、広告で移るようなユーザー≒広告媒体でアプリを探す(が、定着せず移行し続けていることが多い)ユーザーなので、目新しい高品質のゲームを探しています。ゲームを求めているのに、流動している・・・つまり定着しづらい。飽きっぽい人とかが多いイメージです。

そのため、継続率のカウントを行うユーザーは精査した方が良いと思います。検索経由で来た人とユーザー層が本当に大きく違いますので。
分析するユーザー層を定義する・・・とても重要なことです。
ちなみに、運営しているMeisyo+では検索経由ユーザーの1日後継続率は20~40%程度です。広告ユーザーになると10%を切ったりします。アドフラウド(偽広告、広告クリックBot)的なものもあるだろうけどつらい。

では、具体的な分析指標を羅列していきます。
・N日後継続率
・各コンテンツプレイ率(1日目にどのコンテンツをプレイしてなければならないか?)
・プレイ時間別UU数(1日目にどのくらいプレイしていないとならないか?)
・
・
・

ここで情報を整理します。まとめると、ここで考えるべきは4W2Hです。誰が(WHO)何を(WHAT)いつ(WHEN)どのように(HOW)どれくらい(HOW MUCH)・・・と。
どこで(WHERE)はアプリの想定利用用途によっては重要になる場合がありますが、スマートフォンゲームでは・・・そこまでかなと。データを取りにくいので。

そのように、どのようなプレイをされているかを把握する準備をしましょう。
なぜ準備するかって・・・?準備だけでいいです。もっと重要なことがあるので。

ゲーム内を分析する前にやりたいこと

プレイヤーを増やすために重要なのは、アプリストアで見つけられる、認知されることです。ゲーム内容をブラッシュアップするよりも大事です。

結局、インストール人数=認知人数×インストール確率です

インストール確率を上げる努力をするよりも、認知する人数を増やす方が効果的なことが多いです。アプリ制作者が普通に出したアプリは、本当に認知されていないので・・・。

ここも分析の考え方(A/Bテスト)を使います。
アプリストアに訪問するユーザーに見つけてもらうために、キーワードや各種画像をいろいろなパターンで試します。期間を分けて出し分けて、どのパターンが良いのか記録します。

ちなみに、(1)アプリ検索で見つけてもらいやすくするには文字情報が重要で、その検索の中で(2)(競合の中から)選んでもらうには画像や動画が重要です。

(1)は検索はいまだに文字情報が重要です。
最新AIモデルであっても画像を読み取って正しく解釈することにしのぎを削っています。検索内容に反映はまだ難しいのではないでしょうか。
※2025年になりましたが、直近の生成AI(画像等対応)でもゲームバナーのような整理されていない情報では意味のある読み取りはほとんどできません。請求書のような整理された情報ならかなり精度が高くなりましたが、整理されてないとまだまだ厳しいですね…。

(2)は私のこれまでの経験からです。
画像を変えるだけでコンバージョン率(見た人のうち、インストールする人の割合)が変わる≒(インストールを)選ぶかどうかは画像に影響を受ける≒競合アプリとの比較もする人はするだろうから、競合アプリの中からインストールされるには画像は意味があるはずである、という話の流れです。
ただ注意したいことは、説明画像は置けばいいってものじゃないですし、読まれるのはごく一部だと思ってください。説明画像をGoogle Playで最高8枚並べられるのですが、最初しか見てもらえないと思った方が良いと思います。検索が1ページ目の上位3つくらいしか見られない事実のように、ユーザーはサクッと意思決定しちゃいます。そのため、売り文句は1枚目に入れましょう。

そのように、インストールまでの各ステップで落とし穴になりそうなところをくまなく分析・改善していきます。
ざっくり書いてもインストールまででこの文量・・・;つД`)

結局何が重要かというと、ステップのはじめの方を対策しましょうってことです。ゲーム内よりインストール時点、その前・・・。

ゲーム内を分析する際にやりたいこと

ここもはじめの方を対策しましょう

特に新規登録は離脱ポイントになります。
・新規登録しないで良いゲームは新規登録させない
・新規登録ページを作らない(ワンクリック登録で済ませる)
・多くのデバイスでプレイすべきであるゲームはガンバレ…(メールアドレス登録、外部サイト連携)
ユーザー候補は面倒なことがあれば離脱します。

新規登録をした後はデータが取得可能になるため、細かいステップで分析できるようになります。

(ゲーム制作をしている中では数は少ないですが)事前ダウンロードが必要なゲームは、事前ダウンロードが離脱ポイントになりやすいので以下の対応を検討します。
・離脱率は許容できる値か
・許容できない場合は、下記対応ができるか
 ・チュートリアルを進めることができるようにする(のウラでダウンロード)
 ・PVを流す
 ・説明動画を流す

チュートリアルは上記の「おまけ:(1)コンテンツを一通りプレイしてもらいたいの分析方法」と同じように分析可能です。
チュートリアルは基本一本道ですし、移行割合(離脱率)も出せます。
ちなみによく聞かれるのはチュートリアル離脱ユーザーへの対策です。基本無理です。初日にそこでプレイ離脱するようなユーザーは何日待っても戻ってきませんし、毎日プレイするユーザーにはなりえませんでした…。

上記の通り、分析すべき所と打ち手は無数にあります。
そのため、分析しようと思えば何年でも分析し続けることが可能なので、ある程度やることを絞って重要なポイントだけ分析していきたいですね。

以降はよく使う考え方を紹介します。

汎用的な考え方

ファネル分析

「おまけ:(1)コンテンツを一通りプレイしてもらいたいの分析方法」の通り、ユーザーはステップを追うごとにどんどん離脱していきます。
この考え方をファネル分析・・・上流が大きくて下流が小さくなるファネルを参考にした分析方法です。イメージはググってみてください。

この考え方で、アプリ分析でやりたいことはだいたいが可能です。この考え方で対応が不可能なものは、できることが複数パターンあるなかで、どれが一番効果があるかです。それは次の決定木分析で分析できます。

決定木分析

決定木分析は、できることが複数パターンあるなかで、どれが一番効果があるかを分析する手法です。

継続率が高くなるユーザーはどのような行動をしているのかなんてことを分析してくれます。
・・・コンセプトはすごいんですよ?数理的にもしっかりできている。

否定的に書いている理由としては、そういうことを専門にしているコンサル(ワイも含む)がですね・・・継続率が高くなるユーザーはログインを良くしているみたいな当たり前の結果を示唆と言ったり、継続率が高くなるユーザーは課金額が多いなんてことも言われたことがあります。ワイはそ奴らに「課金をガッツリするような人間がすぐ離脱するわけないやろーが。無課金と比べんな」というツッコミを送ります。

そのように、決定木分析は当たり前の結果や異常値なユーザーを取ってきやすい分析です。それは要因でも何でもありません。
モデルや計算ロジックは悪くないんです。使い方がおかしいだけです。

使い方を正しくするには、仮説を持つ必要があります。
育成カードゲームであれば、「カード獲得」→「カード強化」や「装備獲得」→「装備強化」のようにどちらもプレイしておいてほしいコンテンツの流れがあると思います。それらが要因に出てくる必要がありますし、装備強化をノーマル武器からレアまでするなら5回必要みたいなレベルデザインが機能していることも決定木で確認できます。細かい手法はググってね。

そういえば分析記事(決定木分析)を書いてた→決定木分析(Python CHAID)を解釈する

そのように、少し高度な分析になると使い方がめっちゃ難しいので、基礎的な分析で対応した方が良いです…ホンマ(‘A`)
ちなみに、上記で出した例は決定木分析を使わずとも、「新規登録者のうちカード獲得枚数別の継続率」のような形で分析することが可能です。

なお、私の決定木分析の結果の読み方は、「最低限(要因A)を〇回プレイしていないと、ここまでしか継続率が上がらないのか…」です。決定木分析(継続要因分析)の要因は継続要因というより、離脱要因としてとらえています。最低限しきい値とでも言いましょうか。そうしないと希望的観測で語る人がいるので。

おわりに

今回は、毎日プレイするユーザーが増えないよというお悩みに、新規登録の面から解説を行いました。
疑問点や質問、リクエストがあればコメント等いただけるとありがたいです。

ゲームアプリ運営の分析ノウハウ vol.1 概要編

はじめに

以前から、Twitterなどでこんな悩みを見聞きしていました。
「ゲームアプリを運営する際に、どのような視点で、どのような指標を分析すべきかわからない」というものです。今回はそちらのお悩みに対して、仕事で使っている分析ノウハウをお伝えできればと思います。

確かに、指標だけでもたくさんあるし、専門用語もよくわからない。
私も初めて見た時思いました。「わけわかんねぇ・・・」と。
KGI、KPI、新規継続率、既存継続率・・・

初めて見る方ははじめまして。
総合コンサルティング会社でデータ分析を担当しているれいです。新卒から製薬企業品質管理、データコンサル、総合コンサル(分析メイン)など、データサイエンティスト、プロジェクトマネージャーなど職種の違いはありますが、データ分析メインでやってきました。

ゲームはソーシャルゲーム中心に受け持ちましたが、コンシューマーやプラットフォーム系、筐体系の分析も経験があります。それらの経験のエッセンスを抽出してお伝えできればと思います。

今回は、ゲームアプリ(特にソーシャルゲーム)でよく使っていた分析とその考え方をお伝えします。そのため、買い切りアプリなどには適用できない考え方も多くあると思います。

1. 基礎的な考え方

まずは、大きな視点からロジックツリーを使い、問題になっていそうな指標を発見します。コンサルティングの現場ではよくありますが、全体観がない状況で分析して目標数値を最適化も、結局全体でみると何も変わらなかったみたいなことになりがちです。

そのため、大きい視点からまず分析していきます。

以下のように、売上から見ることが多いです。
売上 → プレイ人数 × 一人あたり売上

出てきた指標をさらに分解します。
プレイ人数 → 新規ユーザー + 既存ユーザー
一人あたり売上 → 広告売上 + 課金売上

そして、時間軸を設定します。
(月別)売上 → (月別)プレイ人数 × (月別)一人あたり売上
(日別)売上 → (日別)プレイ人数 × (日別)一人あたり売上

あなたのアプリはどこに問題がありそうでしょうか?
売上がそこまで多くないアプリでは、プレイ人数、一人当たりの売上どちらも低いです。

そもそも売上がゼロ(0)!という方は登録ユーザー、プレイユーザーを増やしましょう。

これまで私が経験したソーシャルゲームを指標とすると、プレイ人数は数万~数百万の単位です。少なくとも1万人はいないとサービス終了ラインに入ってくると思います。
課金額は、新規ユーザーに限定すると、開始30日以内の一人当たり課金売上が1,000円あると「まあいけるかな」という感じです。

既存ユーザーの課金額はゲームやイベントによってかなり大きく変化します。課金者一人当たり1か月の課金売上で1万5,000円程度はあるアプリが多かったですね。

・・・自分のアプリとスケールが違いすぎる・・・!と思われた方も多いかもしれません。
そのため、次のステップでは、いかに1円でも収益を増やすかを考えるための視点を提示します。

2. 小さく始めるための視点(ユーザー増加)

色々な指標はありますが、まずはユーザー(プレイ人数)を増やすことが重要です。

プレイ人数は下記のように分解できます。
プレイ人数 → 新規ユーザー + 既存ユーザー

かつ、新規ユーザーが既存ユーザーになるので、まずは新規をきちんと取れるか(既存ユーザーに移行させられるか)ということを考えましょう。

ここで定義の確認です。
新規:登録初日のユーザー
既存:登録初日ではないユーザー
ちなみに初心者は定義をおろそかにしがちですが、定義を固めないと正しい事後比較ができません。思ってたんと違う・・・みたいな指標を分析していたりします。

登録初日から次の日以降に、いかにプレイしてもらうかが重要になってきます。
そのため、指標は新規ユーザーの新規登録1日後継続率を見ます。

新規登録1日後継続率とは読んで字の通りですが、1日と継続の定義を加味すると、
「登録の次の日(1日後)にログイン(継続)しているかどうか」を判定します。
計算式は、新規ユーザー1日後継続ユーザー数 ÷ 新規ユーザー総数です。

1日後・・・新規登録の24-48時間の中にログインしていた人とします。

ソーシャルゲームでは最低25%、良いゲームだと50%を超えます。
それ以下になるとユーザーが定着しづらいゲームとなるので、一人当たり課金額がかなり高くないとサービス終了秒読みになります。

そのため、目標値は最低30%としましょう。

指標が決まったら、カスタマージャーニーマップや、ユーザーの遷移図を使って問題点を発見→対処していきます。
そういったものがなければ、自分で新しくゲーム内アカウントを作って、新規登録1日以内に触れられそうな部分をリストアップし、イケてなさそうな部分を改修していきます。

ここで重要なのは、最初に触れるものが一番大事というファネル思考です。
ユーザーはゲーム内のコンテンツに触れるたびに、「もういいかな」となって離脱していきます。
そのため、初期のコンテンツであればあるほどユーザーの離脱に影響します。

そこ辺りを注意して問題点に対処していってください。

新規1日後継続率が改善したとしましょう。
次は3日後継続率、7日後、14日後・・・と少しずつ確認のポイントを後ろにずらして、離脱していないことを確認します。

前提としてソーシャルゲームは毎日プレイしてもらうことを想定しているため、そのような日数で判定しています。
もう少しタイムスパンが長いようなゲームだと、月間プレイ人数で分析することが多かったです。

継続ユーザーについては、月間ユーザーの次の月の継続率が8割を下回らなければ問題ないです。
下回っているようであれば、下記のような観点で分析します。
・継続しなかったユーザーはそれ以降復帰していないか?
・ログインしてもコンテンツをプレイしない人はどれくらいいるか?(ログボ勢)
・いつ、どれくらいの人数がログインしているか?減っているタイミングはないか?
・毎日のプレイ回数は想定より少なくないか?少なくなっていないか?

単純に人数が減っているように見えても、理由によっては対応可能です。
・飽きてプレイしない → 離脱
・その他

飽きてプレイしないのが一番対応しづらいので、プレイ回数がどんどん減っているなどがあれば対応が必要でしょう。

3. 小さく始めるための視点(一人当たり売上増加)

続いて重要な視点は、一人当たりの売上を増やすことです。

一人あたり売上 → 広告売上 + 課金売上

広告売上については、下記のように分解しましょう。
広告売上 → 広告単価 × エンゲージメント回数

エンゲージメント回数(表示、クリック等を達成した回数)を増やすか、広告単価を増やすかが考えられます。

エンゲージメント回数を増やすには、以下のように分解するとよいでしょう。
エンゲージメント回数 → 広告表示回数 × エンゲージメント確率

確率は増やせませんが、表示回数は増減することができます。

広告の表示回数を増やしたらユーザーが離脱しそう・・・?大丈夫です。
とある実験では、表示回数を現実的な範囲内で増減する場合は、継続率は変わらなかったそうです。
実体験でも、広告を減らしたところで継続率変わらず、収益だけ減ったという・・・orz
人の行動は意外と直感的ではないのです。

課金売上では、分析するポイントは複数あります。
・商品軸:売上 → 商品単価 × 購入数
・人軸:売上 → 課金額 × 課金者数

施策で注意してほしい点は少ないです。
・商品数を増やしても、売上が上がるとは限らない
(ユーザーは欲しいものしか買わない…別視点では選択肢が増えすぎると、逆に売上が下がるようなことも起こり得ます)
・安売りをすると、後々売り上げが下がる
(利益の先食いになってしまうようです…)
・限定商品はマジで売れる
(きちんと他商品と差別化していれば、不思議と売れます)

おわりに

今回は「ゲームアプリを運営する際に、どのような視点で、どのような指標を分析すべきかわからない」について、ざっと確認しました。
ざっと確認というテイでブログを書いてみましたが、凄く・・・長いですね。

まずは、一つでも分析してみると、温度感や難易度が分かってくるかと思います。
ぜひお試しください(^^)/~

○○をどう分析すればいいかわからない、もっと深い分析(要因分析、需要予測など)がしたいなどがあれば、Twitter Rei_FarmsにDMいただければと思います。
お仕事の依頼も受け付けていますので、お気軽にお問い合わせください。

Pandas DataFrameでの表示列・行をすべて表示する(表示制限を解除する)

Jupyter NotebookでPandasのDataFrameを表示する際、行数・列数が多すぎると省略されてしまう場合があります。

制限を解除しましょう。

pd.set_option('display.max_rows', None)
pd.set_option('display.max_columns', None)

Noneに設定するだけで、すべての行・列を表示可能です。

ただし、行・列数が多すぎる場合、読み込みに時間がかかる場合がありますのでご注意ください!

自然言語処理×教師なし学習での温故知新 PythonでBERT-MaskedLM実装

はじめに

自然言語処理(BERT、GPT-3)および画像認識(ViT)等で以前のState of The Artモデルを超える精度を発揮したTransformer(元論文:Attention Is All You Need)を元にしたモデルたちが存在します。

その中で、BERT: Pre-training of Deep Bidirectional Transformers for Language Understandingという、2022年現在では自然言語処理ベーシックとなった手法が存在します。

ベーシックになった一端として、MaskedLMと呼ばれる学習方法があると私は考えました。

なぜMaskedLMが重要なのか

大規模なデータセットから、モデルを用いて表現学習する際に、教師ラベルを付与する必要がなくても問題がないことを示したからです。

例えば、Deep Learningが注目されるきっかけとなったImageNet Large Scale Visual Recognition Challenge(ILSVRC)は、画像に物体のラベルを1:1で付与したデータセットImageNetを利用しています。

そこで問題となるのは、教師ラベルを付ける工数やその整合性です。

工数は、AIアノテーションの意味とは?タグ付け自動化ツール17選を比較のような製品群ランキングが出てくるように喫緊の課題とされています。
整合性については、現実問題、データ量があまりにも多すぎて検証しようがない状況ですが、近年、AIの専門誌ではないテック系メディアのWiredにAIの基盤となるデータに「ラベル付けの間違い」が蔓延、その影響の深刻度が掲載されるような状態です。

そのように、ラベルを付与する手間や正しさが分からないまま教師あり学習を行うとノイズが含まれる結果となり、ノイズなしのデータと比べてどうしても精度が落ちる(A Chat with Andrew on MLOps: From Model-centric to Data-centric AI)ということが分かっています。

その点、教師なし学習で表現学習ができるMaskedLMは、もともとのデータ(文章)が膨大なメンテナンスコストをかけて整備され続けてきたもの(例:Wikipedia)であれば、ノイズはほぼ含まれていないであろうと考えられます。以前は、教師なし学習でそのような大規模な学習は不可能でした。

そのため、MaskedLMは画期的であろうと私は考えました。しかも、画像処理より難易度の高いと考えられている自然言語処理て、事前の表現学習が可能となりました。

もちろん、画像処理においても、現在ではさまざまな教師なし学習(例:Contrastive Learningの2大手法SimCLR・MoCo、それぞれの進化 (画像の表現学習2020夏特集2))が提案されていることは忘れてはならないかと思います。それは、MaskedLMが提案された後です。

では、実装したコードを示します。

MaskedLMの実装

R2002/NLP_MaskedLM
・Pytorchでの実装です。
・利用される場合はrequirements.txtをpipでインストールしてください。
・学習用テキストは太宰治「走れメロス」を利用しています。

学習方法は、マスクしたトークンを周辺のトークンから推測します。
トークンとは、与えられた文を形態素解析し、1つ1つの意味(チャンク)に分けられた後の語のことを示します。

例えば、文をメロスは激怒したとすると、

形態素解析後にメロス/は/激怒/したのように分けられます。

そのうち、メロス、は、激怒、したというそれぞれの語をトークンと呼びます。

MaskedLMは、そのトークンをランダムにマスクし、下記のようなデータを生成します。

説明変数:
メロス は [MASK] した

目的変数:
激怒

そのため、教師データが必要ありません。学習用データを自分自身から作ることができます。

そのため、膨大でかつ品質が担保されたデータがあれば、人に比肩するような精度を持つモデルが作れた理由の一端として、私はMaskedLMが非常に重要なのではないかと考えています。

※正確な説明はBERTによる自然言語処理入門 ―Transformersを使った実践プログラミング―など専門書をご覧ください。

さいごに

今回はBERTでのMaskedLMの学習方法となぜ重要なのかを確認しました。

BERTの提案は2019年ですので、2022年まででまた大きく技術が進歩したと考えています。

ただ、MaskedLMをはじめとした学習方法が持ち込んだ問題点としては、膨大なデータがあれば、良いモデルは学習できる・・・が学習できる環境は整っているのだろうか?ということです。巨大な計算リソースがなければ大本となるモデルは作れない、つまり、大企業や潤沢な研究資金・資材が得られない環境であれば、新しいことができなくなるのではないかということです。その分、転移学習などで利用は簡単になりましたが・・・。

今回、GitHubで示したコードの条件下(CPU利用)でも、走れメロスのみで30分近くの学習時間がかかりました。計算資源がディープラーニングの制約にのような記事も散見されます。

研究の流れとして、精度がある程度満たされれば計算速度が追及され、計算速度が要求以上になれば精度を求める・・・のような揺り戻しは来ると思います。

機械学習系のコンサルタントとして、今後もBERTを追っていきたいと思います。

以上、れいでした。

おまけ

MaskedLMの手法改善

私が思うに、MaskedLMの改善手法として下記がありそうだなと考えていました。
1・Mask割合を変動させる
2・復元抽出を行って再度Maskしなおす
今回は、(1)が論文において実証されたようです。

【Meisyo】ステータスバランス調整

はじめに

Meisyo+ お知らせ ステータスバランス調整予定のお知らせの詳細を記載します。

下記の順番で対処を行いました。
②本塁打率が高すぎる。
①打率平均が低すぎる。
③長打(二塁打・三塁打)が少なすぎる。

問題対処

まずは②本塁打率が多すぎる問題に対処しました。

スイングスピード

一律に低下させました。
y = ax + bで定義しており、x=パワーです。
係数のaも下げましたが、切片のbも低下させました。その分、パワーが高い選手も低い選手も打球速度が下がり、打球が飛びにくくなりました。

球場

現在3球場あり(大きさは公式戦>練習試合リーグ用>その他)ます。
その他球場が小さかった(=本塁打が出やすい)ので、練習試合リーグ用に準ずる程度まで大きくしました。

守備速度

打球速度が下がると何が起こるか。

ヒットが出なくなります。(Meisyo+でも)統一球問題ですね。

お知らせの内容の通り、Meisyo+は①打率低い問題も抱えているので、これは困った・・・。そのため、守備速度を低下させました。

以前は外野手・内野手が同じ守備速度でした。
今回から全体的に速度を落とし、相対速度は外野手>内野手としました。内野手の方が守備範囲が比較的狭いため、そのようにしました。

その結果、打率が仕様調整以前より10%UPすることとなりました。
また、③長打(二塁打・三塁打)が少なすぎる。については、ある程度調整できたので大きく補正はしていません。

調整結果

変更後も三塁打は少ないものの、二塁打・本塁打はある程度順当に設定できたと思われます。

こうしてみてみると、甲子園はかなり打高なんですね・・・。

データ集計について

変更を行う際はデータ集計を行っています。

その方法は、オフライン上で、総合力上位のある高校 vs その他選択された高校たちを使った練習試合の繰り返しで求めています。

そのため、今回の調整は総合力B~Sのユーザーへの影響はある程度わかりますが、それ以外への影響は未知数です。

ただ、実験していて面白いなと思うことは、勝敗は総合力に相関すると考えられる結果ですが、個別では組み合わせによって全然違う結果となりました。総合力が高くても勝てない不思議です。実現したかった内容がある程度実現できていると思います。

※特にトップレベルのチームでは3または4すくみの状況となっていて、同等のあるチームには9割勝てるけど、他のあるチームには9割負けるみたいなことが観測されています。

おまけ

リアル表示の改善


チャンス時に表示速度低下を追加しました。

高速で飛ばしてみていても、チャンス時だけはちゃんと見たいという人がいるはずだということで実装しました。

併せて、リアル表示の関連ログを取得するようにしました。リアル表示のボタンをクリックしたか、どういう設定で見ているか等をログにとることで、さらなる改善を目指します。

ケガ状態の仕様変更

ケガ状態では、やる気と体力が自動的に0になっていました。

改善後は、やる気がケガ前の数値で保持されるようになります、

打球分析βの実装


打球分析データを取得するようにしました。

そのデータ(打球の1バウンド目のみ表示)を元に、守備位置(全体設定・対チーム・対個人)を設定できるようにする予定です。いつになるかわかりませんが。

とはいえ、試しで取得した全体の打球分布(上記画像)はかなり一様分布なので、パワーが低い選手では前に守らせるくらいしかなさそうな気もしますが…。

※捕手・一塁・三塁付近で打球が多くなっているのは、カットミスでの打球だと思われます。

ストーリーの追記

5章、7章にストーリー進行上重要な追記を行いました。

さいごに

今回のように仕様変更する際は、データを元に意思決定しています。
とはいえ、調整部分は多分に個人の意見や思い込みが入る余地がありますが…。

また、今回のアップデートはユーザー数増加のために、SEO(Search Engine Optimization)のためにも行いました。ログインしていなくても見れるページ数を多くしたため、検索クローラーに対する情報量が多くなり、検索のより上位に表示されることを試みました。

その他の方法を考えると、多くの人に、ブログやSNSで紹介してもらえれば知名度が上がるので、よりユーザー数(戦略の数)が増えて、攻略が楽しいです。ぜひ一言でもSNSなどにコメントいただきたいですね~。プラス・マイナスどちらでも歓迎です!

その他、変更してほしい点があればご連絡ください。

2022年 プログラミング初心者におすすめのPCと備品

はじめに

プログラミング始めてみたい(始めてる)けど、パソコン用意したいなあと思った時、ググってみるといろいろ情報がありすぎて困ったあなた。

PC・プログラミング歴20年以上私が見るに、アフィリエイト(個人で行う企業広告)に毒された記事群が散見されました。困りますよね。。

これ・・・初心者は判断できないのでは?ということでアフィリエイトなしの記事を書きました。

用意したい金額の前提として、下記のように読者を想定しています。

リーズナブルにプログラミングの初歩を学びたいなら。新品価格であれば3万円程度で十分です。

プログラミング楽しいな!プログラミングをより詳しく学びたいという方は、5万円くらいで十分です。10万円程度のPCも紹介していますが、ガッツリやりたい、趣味になってしまった人向けです。

注意点としては、皆が知っているような日系大手メーカーのPCは残念成分(価格、性能、ソフト他)が多分に含まれています。最近の店頭に出ている商品でも、不要なソフトがてんこ盛りなので買う意味を個人的には感じません。

話は少し変わりますが、PCには備品が必要です。なぜなら、備品によって作業効率が段違いになります。備品はソフトとデバイスを紹介します。

ソフトは、私の専門でデータサイエンス(統計・機械学習)で必要なものをピックアップしました。ふつうにプログラミングをする分には不要です。Excel(エクセルやCSVファイルに対応)、PowerPoint(分析では使わないが報告には必要)があればOKです。

デバイスは、作業や学習効率アップのために必要であれば購入ください。

それでは紹介します。

PC

まとめ
・OS:Windows
・大きさ:14型
・性能:要注意

OS

Windowsが実用上良いです。日本のITの現場において、利用環境がWindows準拠が多いからです。

バージョンとしてはWindows10でOKで、Windows11である必要はないです。

本格的なプログラミングをする場合は、MacやUbuntu等になる可能性もありますが、その際は知識がついているので判断が可能になります。

大きさ

14型かそれ以下がおすすめです。

14型はノートPCとしては個人の感想ですが大きめに感じます。17型は大きすぎる可能性があります。カバンによく入れるなら13型以下にすべきでしょう。

ここは特に、家電量販店で見て触れて決めてほしいところです。

性能

最重要ポイントです。高性能と銘打って売られているPCも実は・・・ということは多くあります。

CPU(処理装置)、メモリ(作業台の大きさ)、HDD(記憶装置)、グラフィックカード(画面描写の速さ)の視点で解説します。

CPU

インテルの第10世代i5で十分です。インテルHPに記載があれば問題ありません。比較サイトもありますので、よさそうなPCまたはCPUがあれば自分で調べてみてください。

メモリ

最低8GBは欲しいです。16GBはそこまで必要に感じません。ただし、4GBだとWindowsの動作だけでカクカクになる場合があります。

HDD(記憶装置)

最低250GB欲しいです。Windowsの場合、OSち基礎ソフトで150GBくらいは使います。

より読み込み・書き込みが高速な種類(SSD)もあり、立ち上げが早いなどのメリットがあります。ただ、プログラミング初心者がそこまでこだわる必要あるか?とは感じますね。筆者はこだわっているのでSSDですが。

グラフィックカード

ノートPCで一般的に採用されているオンボード型で問題ありません。
動画編集、深層学習のモデル作成、ゲームをしないのであればGPUは不要です。

おすすめPC(例)

IdeaPad Slim 350i 14

64,130円

上記に書いてある条件はほぼすべて満たしています。
詳しくは、レノボのHPをご覧ください。

THIRDWAVE DX-T7

96,580円

ちょっとハイエンドよりでプログラミングをガッツリする人向け。これ以上ははっきり言って不要です。よりローエンドのPCもあります。
詳しくは、ドスパラのHPをご覧ください。

より見た目重視なら、下記がおすすめです。ただ、値段が高いですね・・・。
Microsoft Surface
Huawei matebook X Pro

ソフト

基本的にMicrosoft Officeで良いですが、PCによって同梱品が変わります。基準価格を知ってお得に購入したいですね。

Microsoft Office Home

買い切り:38,284円
高い・・・。Word、Excel、PowerPointが含まれています。

Microsoft 365 Personal

サブスク:1,284円/月(12,840円/年)
Word、Excel、PowerPointが含まれています。

高いなあと思う方は、下記ソフトをお勧めします。

KING SOFT WPS Office 2

買い切り:5,690円
Word、Excel、PowerPointの代用アプリ。操作性は少し違いますが、機能は十分です。

Apache Open Office

はっきり言ってお勧めしません。
Officeと(互換性があると言っているが)互換性がなく使いづらい。エクセルやパワポをOffice純正からOpenOfficeに変換すると元に戻せないことも・・・。

デバイス

モニタ

デュアルモニタに利用します。作業効率UPならこれが一番です。作業机における大きさで安いモノで十分OK。

マウス

ノートPCにもあった方が良いです。キーボードのコマンドで高速に操作できる人はごくわずかです。

キーボード

不要です。気に入ったキーボードがついてるノートPCを買うべし。

こだわるならデスクトップPCにした方が安上がりかもしれません。

さいごに

PCのスペックはいろいろあって困りますよね。今回は最低限、プログラミングができる内容で設定しました。

最後は、店頭に行き、フィーリングが合ったものを買うといいと思います。長い時間使うので、「おすすめと言われていたから」では続かない可能性が高いです。ストレスも減りますし。

それでは皆様、良いプログラミングライフを!

【教材紹介】Python ゼロからはじめるプログラミング

概要

「プログラミング、興味はあるけどどう始めたらいいのかわからない。」というあなた!まずは、丁寧な説明と図、問題集までついたこの1冊(無料PDFあり)で入門してみませんか?

内容を確認しましたが、ここまで丁寧にわかりやすく、網羅的に説明した書籍はなかなかないと思います。自社の未経験者の教科書にしてもいいくらいです。

気に入ったら本の購入をお勧めします。

名称


Python ゼロからはじめるプログラミング

著者

三谷純

必要知識

なし

得られるスキル

Pythonの基礎的知識
プログラミングの基礎

その他の教材紹介ページはこちら → Skill Stacks

Pandasに行を追加する時はappendを使わず、コレを使おう

はじめに

筆者は仕事柄Pythonのコードレビューをすることが多いのですが、まれにPandasに行を追加する最適な方法で相談されることがあるので、今回書きました。

まず言えることは、Pandasの標準的なappendは使わない方がいいです。

では、何を使えばいいのか?ということで、今回主要な方法で実験してみました。

実験方法

2カラム(どちらもランダムな数値)を追加していく。
1万回繰り返した時に、どの方法が一番早いか平均値で比較する。

結果

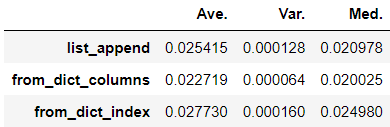
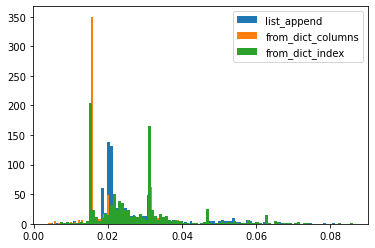
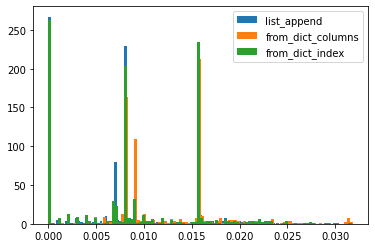
比較した7つの方法のうち、比較的早い3つの方法をピックアップして処理時間の統計情報(n=1000)を取得しました。

統計的に判断した結果、最速はPandas from_dict key=’columns’でした。
次点はList Appendで、3位はPandas from_dict key=’index’でした。
各々、使いどころが違うのでご注意ください。

Pandas from_dict key=’columns’

記法が他と比べ少々独特で、列思考でプログラミングする場合はこちらが良いでしょう。実行時間のばらつきも少なく、処理が他に比べて安定して早いです。

dict_col = {'input_a': [], 'input_b': []}
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    dict_col['input_a'].append(a)
    dict_col['input_b'].append(b)

df = pd.DataFrame.from_dict(dict_col, orient='columns')

ただし、実務において列思考でプログラミングすることはあまりなく、コード1行で1列を指定しなければならない面倒さはあります。書く量が増えることによってバグの温床になりえるので注意が必要です。

何度も繰り返し、今後変更がない部分であれば導入してよいと思われます。

List Append

一番シンプルで書きやすく、変更しやすいです。筆者も実務でのPoC(概念検証)や、MVP(最低限の機能を実装したプロダクト)作成の際にはこちらを使っています。

list_temp = []
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    list_temp.append([a, b])

df = pd.DataFrame(list_temp, columns=['input_a', 'input_b'])

ただ、計算時間が1位に比べ20%増加するため、PoC以降で採用し続けるかどうかは不明です。

Pandas from_dict key=’index’

こちらもシンプルな記法です。

dict_idx = {}
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    dict_idx[i] = [a, b]

df = pd.DataFrame.from_dict(dict_idx, orient='index', columns=['input_a', 'input_b'])

ただし、index(コード中i)を定義できない場合は使用できません。データにIDが割り振れる場合は、データの意図しない複製が出ないことは評価できるポイントです。

比較した方法と実行秒数

結果詳細はhttps://github.com/R2002/Pandas-Appendをご覧ください。

1. List Append

0.028s

2. Numpy Append

0.063s
「Numpyは早い」というのは行列計算が早い。Appendは遅め。

3. Pandas Append

5.349s
純正のAppendは使うのをやめときたいですね。

4. Pandas Concat

3.368s
Concatの方がAppendより早いの何でだろう。

5. Pandas Loc

7.459s
Locで行指定すると一番遅いのね。

6. Pandas from_dict key=’index’

0.026s

7. Pandas from_dict key=’columns’

0.023s

さいごに

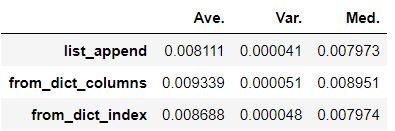
いろいろな手法がある中で、今回の実験条件での最速はPandas from_dict key=’columns’でした。ただし、おまけで比較した結果、カラム数が増えるとList Appendが最速です。

このように、実験して比較すること(実験計画法の利用)で、さまざまな条件下での結論を出すことが可能となります。いろいろ試してみてください!

おまけ

変更: 3カラム追加

カラムを増やして比較たが、結果的に傾向は変わらず。

「今回は行を増やす方法を比較したが、列が増えると極端に遅くなる手法があるのではないか」という仮説でしたが、そんなに大きく変わらない可能性がありますね。
※結果は、https://github.com/R2002/Pandas-Append/blob/main/AppendTest(AddColums).ipynbを参照してください。利用環境によっても変化する可能性があります。

変更: 100カラム追加

追加で、ループ数を1万から100に変更した。

List Appendが処理速度1位になりました。つまり、ある程度カラム数が少ない場合は、Pandas from_dict key=’columns’が最速で、カラム数が多くなるとList Appendが最速になります。

※結果は、https://github.com/R2002/Pandas-Append/blob/main/AppendTest(AddColums2).ipynbを参照してください。利用環境によっても変化する可能性があります。