[Meisyo]投手交代アルゴリズムの変更

要望

作者の考え

確かに・・・。
野手が登板して試合壊れるとツマランしね。

1・交代投手がいるか?→いれば交代(代打・代走)可能
2・野手が登板しそう!→とりあえず普通の登板を実施。居なければ誰でもいいから投手出せい。
1、2はそれぞれ補完関係にあるから、どっちかだけの実装はマズいね。

解決策

投手交代のアルゴリズムを変更しました。
この変更で、野手が登板することは基本的になくなりました。
[詳細]
・投手への代打・代走は、投手の交代要員が一人以上居る場合のみ可能に。
・打者(type=B)が投手として登板しようとするとき、もし継投設定上誰も登板しない場合は、ベンチ登録済みで登板していない投手をランダムで登板させる。

コメント

実装しました。

はまったのは、投手の交代要員数の出力。
表と裏の選手Arrayを勘違いして同じように扱ってました。/(^o^)\
動くわけがない。

野球ゲームデータで遊ぶデータサイエンス(正規分布の検定編)

名将と呼ばれた者達のデータを使って、データサイエンスを学んでみましょう!

生きた&整えられたデータは中々公開されていないので、今回の野球ゲームのデータは分析に適していると思われます。もちろん、Kaggle等のデータもありだと思います!

今回やること

野球ゲームの選手について、能力のミートが正規分布であるか(排出設定通りか)確認します。その理由としては、運営の観点から、バグなどの問題がなく、うまく選手が生成できているか?を答えたいと思います。

ゲームデータ(試合結果)

野手データ 20190204.csv
投手データ 20190204.csv

実施内容

はじめに

Jypyter Notebookで分析を進めていきたいと思います。

まずは、コマンドプロンプトを開いて、基本的なパッケージをインポートしておきましょう。

import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

次に、ゲームデータがあるディレクトリ直下まで行って、データを読み込ませておきます。

dfB = pd.read_csv('meisyo_b_20190204.csv', encoding='utf-16')
dfP = pd.read_csv('meisyo_p_20190204.csv', encoding='utf-16')

* 文字化け防止のためcsvはutf-16で出力しています。

データの確認

データの状況把握のためにdf.info()を表示します。

dfB.info()
dfP.info()

つづいて、野手(dfB)のデータをメインで見ていきましょう。
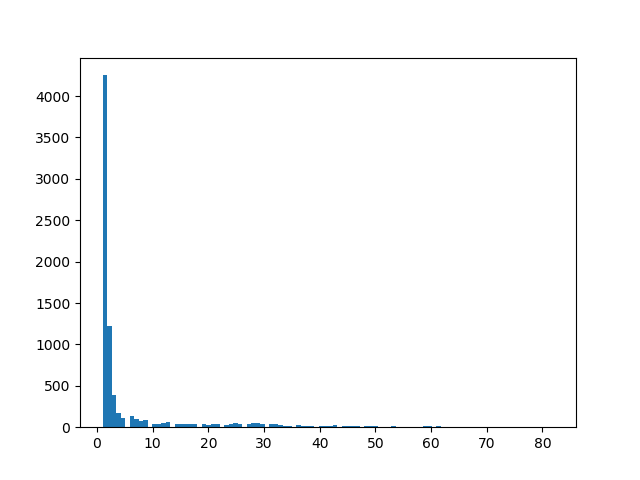
Lvのデータをグラフ化しましょう。

plt.hist(dfB['lv'], bins=100)
plt.show()

* bins=100にしているのは、Lvが1~100の100分割で設定されているからです。
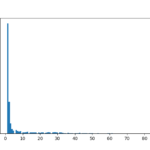
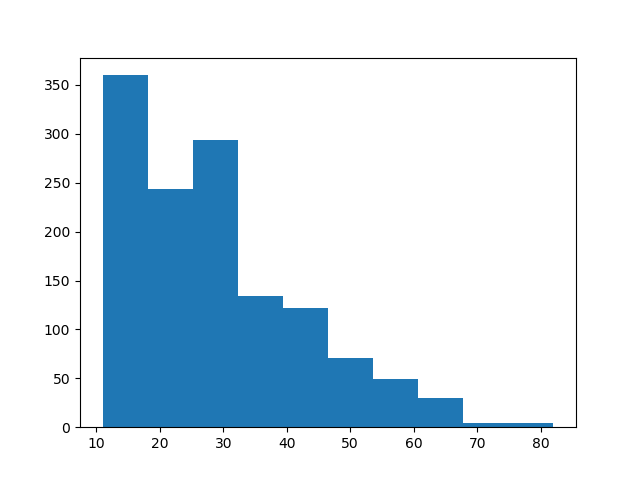
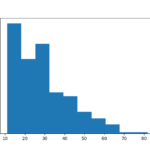
Lv0が多すぎるので、クエリでLv > 10と制限しちゃいます。

plt.hist(dfB.query('lv > 10')['lv'], bins=10)
plt.show()

dfは「Lv > 10 & Lv <= 100」などSQLみたいに書けるので、応用がいろいろできそうですね。 * 次回以降、plt.show()を省略します。
能力値の確認

それでは、ミート(b_mt)を解析します。
まずはshape(データの行数・列数)とmean(平均値)、std(標準偏差)を表示します。

dfB.shape
dfB['b_mt'].mean()
dfB['b_mt'].std()
(7893, 96)
32.214493855314835
11.483961920286394

7893データ(n = 7893)、96カラムがありました。これだけでは、ミートがどのようなデータ分布をしているのかいまいちわかりませんね。

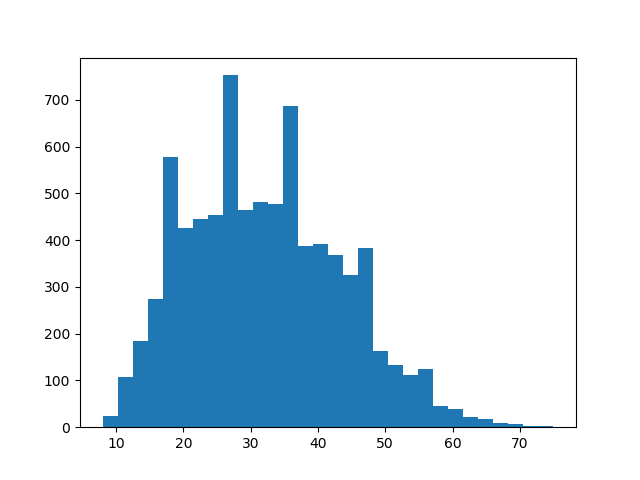
今回は(設定通り)正規分布してるのか?ということが気になるので、b_mtをヒストグラムにしてみます。

plt.hist(dfB['b_mt'], bins=30)
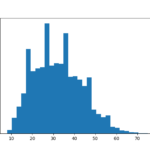
右と左のバランス感から、これは見た限りでは正規分布していないですね。

正規分布の検定

見た限りという主観的な意見ではなく、正規分布であるかどうか判断できる方法論である検定を行います。

正規Q-Qプロット

正規分布の検定によく使われる手法です。こちらは可視化の方法論となります。

import scipy.stats as stats
stats.probplot(dfB['b_mt'], dist="norm", plot=plt)
plt.show()

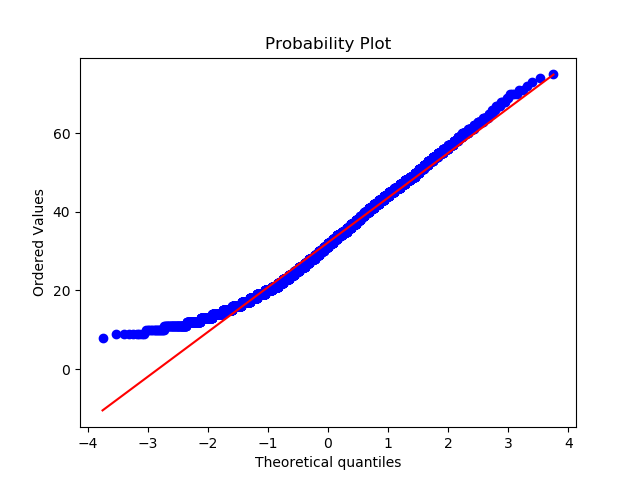
直線上に乗ってることが正規分布を示すと考えてください。

低い値の範囲が正規分布していないようですね。

シャピロウィルク検定

他にも正規分布の検定方法はあります。定量化できるので、数値での比較が可能となります。

stats.shapiro(dfB['b_mt'])
C:\Users\saito\AppData\Local\Programs\Python\Python37-32\lib\site-packages\scipy\stats\morestats.py:1653: UserWarning: p-value may not be accurate for N > 5000.
  warnings.warn("p-value may not be accurate for N > 5000.")
(0.9833155870437622, 1.85650483425366e-29)

N>5000は正確でないよとアラートが出ていますね。データ量が多すぎたのかもしれません。

結果は、(検定統計量(W), p値)と出力されます。

今回は、p値 < 0.05のため、正規分布であることが棄却(≒正規分布ではない)されています。

歪度と尖度の確認

歪度と尖度が正規分布に近い値か確認します。0になると正規分布ですが・・・

>>> pd.Series(dfB['b_mt']).skew() #歪度
0.364141699620992
>>> pd.Series(dfB['b_mt']).kurtosis() #尖度
-0.3620100293286428

今回は正規分布でないですね。

その他データ加工方法を試す

能力値をある条件下で区切って、正規分布であるかどうかを確認します。

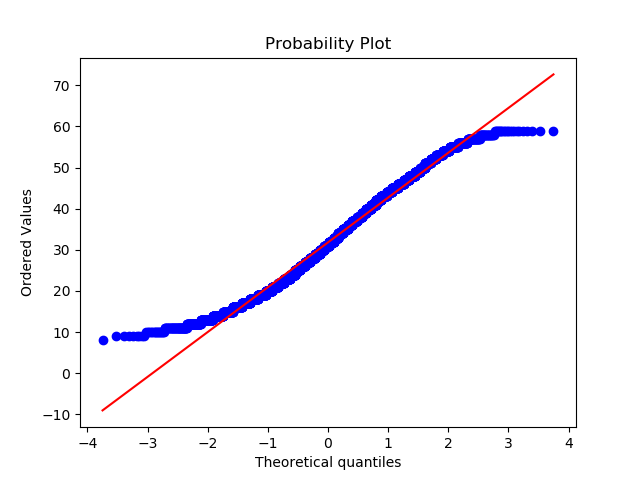
stats.probplot(dfB.query('b_mt > 0 & b_mt < 60')['b_mt'], dist="norm", plot=plt)


加工したほうが直線への乗りが悪くなってますね。

他のステータスb_pw(パワー)も見てみましょう。

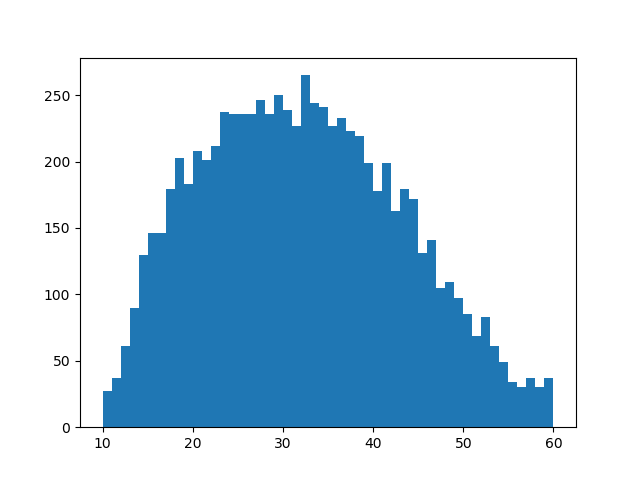
 plt.hist(dfB.query('b_pw >= 10 & b_pw <= 60')['b_pw'], bins=50)
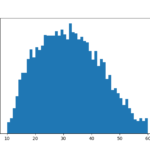

これは・・・ダメかもしれません。左すそは分布が急減していて、右すそは謎の山ができている。

上記を検定してみましょう!

>>> stats.shapiro(dfB['b_pw'])
(0.9832108020782471, 1.5380268896554336e-29)

だめですね!正規分布ではない。(‘A`)ンアー

検証結果

正規分布していないという結論になりました。

なぜ正規分布していないかというと3点理由があります。
1・投手と野手では計算式が違うから
2・能力値値が低い選手は削除されるから
3・生成した結果のデータではなく、選手データをそのまま使っているから

1点目については、ミートもパワーも(結果的に打力が)高い投手が出現するなら、野手が要らなくなるよね?それは阻止したい。ということで、「野手能力は野手>投手」、「投手能力は投手>野手」になるように生成の制限をかけています。
それは後述のヒストグラムで確認可能です。

2点目については、ゲームをプレイしているユーザー側の都合ですね。
相対的に弱い選手は淘汰される。ただそれだけです。

そのため、正規Q-Qプロットでミートが低い値の範囲が正規分布していなかったことが予想されます。

3点目については、分析すべき対象データを間違っていたという致命的な内容です。

つまり、今回のデータや分析では何も言えないということです。答えがこれでは出せませんというのが答えという・・・。

さて、頭を切り替えて、野手と投手データを分けると、どう分布してるのか?を見ていきましょう。

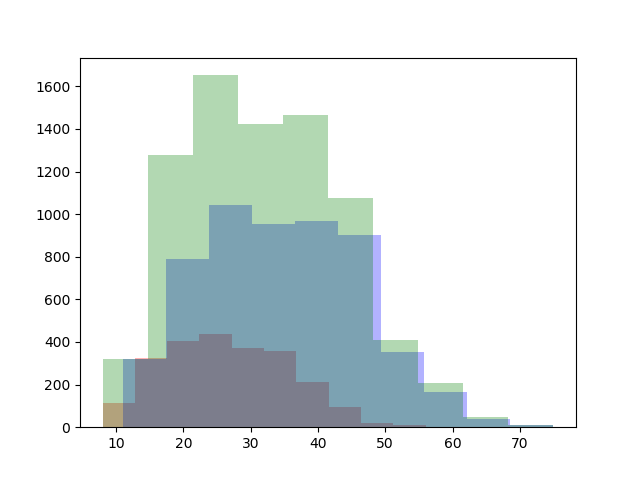
plt.hist(dfB.query('type == "P"')['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='r') # 投手
plt.hist(dfB.query('type == "B"')['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='b') # 野手
plt.hist(dfB['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='g') # 全体

ヒストグラムを半透明にして、緑=全体、青=野手、赤=投手で表示しています。
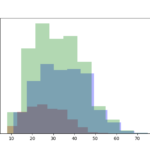
投手と野手の分布が違うことがわかりやすいのではないでしょうか。とはいえ、このように前提知識がないと効果的な洞察は得られません。

野手と投手の分布が違うことをさらに裏付けましょう。
マン・ホイットニーのU検定(中央値の検定)では、投手と野手ではやはり中央値は異なると出ますね。これこそ設定通りですね。

stats.mannwhitneyu(dfB.query('type == "P"')['b_mt'], dfB.query('type == "B"')['b_mt'])
MannwhitneyuResult(statistic=3865093.0, pvalue=4.898308872342808e-180)

加えて、one-way ANOVA(1元配置分散分析)を試します。それぞれの集団が正規分布であることを前提にする検定です。平均値が同じであるかどうか?を分散の違いで検定しています。

よくやりがちなんですが、2群間の検定であるt検定を3群に対してそれぞれ行う(A=B、A=C、B=CだからOK!)という暴挙はしてはなりません。こちらは、統計の適用ミスとして失敗例によく挙げられます。

まずは、3群(全体、野手群、投手群)が正規分布であるかどうかの検定を行います。

>>> stats.shapiro(dfB['b_mt'])
(0.9833155870437622, 1.85650483425366e-29)
>>> stats.shapiro(dfB.query('type == "P"')['b_mt'])
(0.984963059425354, 4.804016817054439e-15)
>>> stats.shapiro(dfB.query('type == "B"')['b_mt'])
(0.9849120378494263, 6.929926115617653e-24)

全然正規分布ではありませんでした。つまり、one-way ANOVAは使っちゃいけない分布です。

続いて、分散分析を行います。(使い方は間違っています)

>>> stats.f_oneway(dfB['b_mt'],dfB.query('type == "P"')['b_mt'],dfB.query('type == "B"')['b_mt'])
F_onewayResult(statistic=447.17232845769377, pvalue=1.25435911612848e-189)

一致するわけがないのでした・・・。

おまけ:追加検証

正規性を検定するシャピロウィルク検定(stats.shapiro())で、標準正規分布を生成するnumpy.random.randn()を検定してみましょう。正規分布を正規分布(正を正)と判断できるかをチェックしています。

>>> for i in range(1, 10):
...   temp = np.random.randn(10 ** i)
...   print("10^" + str(i) + ":" + str(stats.shapiro(temp)))
...
10^1:(0.9447452425956726, 0.6069143414497375)
10^2:(0.994074285030365, 0.9436165690422058)
10^3:(0.9983760118484497, 0.4763585329055786)
10^4:(0.9998458623886108, 0.7608375549316406)
10^5:(0.9999829530715942, 0.9663644433021545)
10^6:(0.999995768070221, 0.9852367043495178)
10^7:(0.9999997615814209, 1.0)
Traceback (most recent call last):
  File "<stdin>", line 3, in <module>
  File "C:\Users\saito\AppData\Local\Programs\Python\Python37-32\lib\site-packages\scipy\stats\morestats.py", line 1644, in shapiro
    a = zeros(N, 'f')
MemoryError

10^n個の標準正規分布を作らせて検定してみたところ、数が多くなればなるほどp値は1.0に近づきますね。

ただし、統計学では「正規分布していることを棄却できない(=判定を保留している)」だけであって、積極的に「正規分布している」とは言えないことに注意が必要です。

さいごに

今回はゲームデータを用いて正規分布の検定を試してみました。

今回の結論からしても、やはり分析技術の理解とドメイン知識の両輪が必要ですね。

よく読まれるようなら、また別の内容を投稿したいと思います。
Google Driveを使ってXAMPP+CakePHPのドキュメントルートを共有する in Windows

どこでも同じように作業がしたい。
デスクトップでも、ノートでも。

無論、サーバー(XAMPP)も同じように動かしたいな

・・・ということで、Google Driveを使って環境を構築していきます。
今回はXAMPPとCakePHPの組み合わせですが、ほかにも応用が利きそうですね。

きっかけ

MicroSoft Surface Laptop2を購入しました。

今まではデスクトップのみ(椅子に何時間も座りながら!)でプログラミングをしていたので、もっと楽したいと思いました。
ノートなら寝転びながらでも出来るし、負荷の高い演算はデスクトップで行えたら楽だなあと。

Google Driveのインストール

Google Driveをインストールします。

インストール先は、C直下の「C:\GoogleDrive」にしましょう。

* CakePHPを使う場合は、必ずこの設定を守ってください。
CakePHPではindex.phpにて、ルートディレクトリを設定しています。
もしこの設定をusers(ユーザー)ディレクトリ以下にすると、ユーザー名を統一しなければ、サーバー起動時にindex.phpを一々書き換えないと動きません。

index.php設定例

define('ROOT', DS.'GoogleDrive'.DS.'localhost'.DS.'home'.DS.'cake');

間違い例

PC1「C:\users\m.saito\GoogleDrive」
PC2「C:\users\saito\GoogleDrive」
CakePHP index.php<どっち選んでも片方エラー出るんだけど詰んでない?)

CakePHPのhtdocsの移動

「C:\GoogleDrive」ディレクトリにlocalhostディレクトリを作成しましょう。
ここにCakePHPのhtdocsディレクトリの中身を移します。

XAMPPの設定変更

C:\xampp\apache\confのhttpd.confを変更します。
251行目くらいにあるDocumentRootを下記の通りに変更してください。

DocumentRoot “C:/GoogleDrive/localhost”
<Directory “C:/GoogleDrive/localhost”>

CakePHPのindex.phpの変更

CakePHPのドキュメントルートにあるindex.phpのROOTを設定します。

通常は下記のようにしていると思いますが、

define('ROOT', DS.'xampp'.DS.'htdocs'.DS.'home'.DS.'cake');

下記の通りに変更してください。

define('ROOT', DS.'GoogleDrive'.DS.'localhost'.DS.'home'.DS.'cake');

XAMPPの再起動

XAMPPを再起動させてください。
それで問題なく動くと思います。

共有PCの設定

同じように作業したいPCには、今回の手順の「CakePHPのhtdocsの移動」以外を行ってください。
その後GoogleDriveが共有されれば、問題なく動きます。

動かない場合は・・・

エラー文をググりましょう。
特に多そうなのが以下のような状況でしょうか。
・MySQLのrootのパスワードが違う→一致させてね
・データベースに接続できない→cake/app/Config/database.phpの中身見てね
・文字コードが一致しない→MySQL 8 のデフォルト文字セット系をすべて utf8mb4 にする cnf の書き方メモ・・・おすすめはutf8mb4です。utf8でもいい感じ。統一しましょう!(ただしmy.cnfはmy.iniに名前変更されている)
引っかかるところがあれば聞いてくださいませ。

[Meisyo]SQLでバグ発掘

「監督の指導能力が上がらない」という情報が入ったので、
・バグの修正
・SQLでバグっているIDの方を検索→チケットプレゼント
を行います。

該当能力:
 指導能力(体力)
 ・・・ちなみに投手以外でも使ってます。試合でのHPもね(‘A`)
 上げると連戦でも疲れなくなる。強い。

コード:

SELECT
	team_name,
	PM
FROM (SELECT
	id,
	team_name,
    lv,
    point_st,
	(mn_b_mt+mn_b_pw+mn_b_sp+mn_b_sf+mn_b_df+mn_b_er+mn_b_ss+mn_p_sp+mn_p_co+mn_p_st+mn_p_bbn)/3 MN,
    (lv-1-(point_st+(mn_b_mt+mn_b_pw+mn_b_sp+mn_b_sf+mn_b_df+mn_b_er+mn_b_ss+mn_p_sp+mn_p_co+mn_p_st+mn_p_bbn)/3)) PM
FROM ids) AS account
WHERE PM > 0

lv = 監督lv
point_st = 指導P
mn_~ = 実際の指導能力追加(*3倍される)
MN = 指揮能力追加の合計値
PM = 正常なら0
バグってる人は「PM」が0以外になります。

さてやってみよー。

該当:
・私立双葉学園
・私立月虹学園高校
・国立らんらんるー魔苦怒亡流怒
・県立三本木第二高校
・私立ジャガ畑高校
・国立私立高校
・私立蒼天学園高校
・私立紫月高校
・国立品菜高校
・県立三本木高校
・県立ワンワン高校
・都立山の手高校
・国立帝都第一高校
・県立橋本高校

多い・・・!
対象者の方にはチケットをもう1枚お送りいたしました。

ご迷惑をおかけして申し訳ありません。
また何かあればご連絡ください!

[Meisyo]模擬戦の追加(テスト)vs 大阪桐蔭2018

模擬戦(NPC勝ち抜き戦)を追加しました!

模擬戦のコンセプトは「甲子園歴代優勝校と戦える場を」です。
経験値高め。もらえるアイテムも多いです。
挑戦には練習試合で7日に1回くらい拾える「試合チケット」が必要です。

・・・というわけで大阪桐蔭と戦ってみました!

勝てる気がしない!!


ファー/(^o^)\

1週間に1回くらいチケットが拾えるので再挑戦しますかね。

[Meisyo]野手起用法設定の導入

野手起用法設定の導入を行いました。

この変更で、
「勝ってる時だけ守備固めを出したい」
「負けてるから投手に代打してチャンスを作りたい」

という要望にお答えしました。

発想は野手起用法設定の導入検討のコメントより。
メールありがとうございました!

[Meisyo]アイテム3種類の追加

Meisyoのアップデートを行いました。
メインはアイテムの追加です。


監督画面でアイテムの所持数を確認できるようにしました。

下記アイテムを追加しました。
1・モード5(選手やる気5上昇)
2・プロキュア30(選手体力30回復)
3・スキル:チャンス○(選手にチャンス○を覚えさせることができる)
各アイテムの所持数は「監督情報」で見ることができます。

上記アイテムは実装時にプレゼントされます。個数は下記の通り。
・モード5:3
・プロキュア30:5
・チャンス○:1
試しに使ってみてね!

アイテム追加した理由
・今後の公式戦でやる気UP・HP回復を戦略的に使ってもらうため
 体力&やる気の調整が死活問題になりそうなので追加しておきました。
 やる気UPはその後の不調期間が長くなるデメリットがあります。
 体力回復はデメリットはありません。
・スキル付与で選手の個性をさらに強化できる
 今回はチャンス○(ランナーが2または3塁に存在する場合、ミート+5パワー+5)です。
 何かの大会orNPC勝ち抜きトーナメントの景品としてつけてもいいかもしれない。

練習・試合でのドロップ確率は未設定(0)です。
設定したらお知らせします。

[Meisyo]ビッグデータから学ぶ試合の基礎設計5

ここでは、「どのパラメータが打率等にどれくらい関係するのか」を理解することで強いチームを作る指針を記載しておきます。
[Meisyo]ビッグデータから学ぶ試合の基礎設計4の詳細版です。

今回は、右打と左打はパラメータの相関関係に違いがあるのか?という問いに答えたいと思います。
まずは「右打、左打で平均打率に違いがあるのか?」という問いですが、
R(73867打席):0.2428
L(39563打席):0.2468

左打席に+1.6%補正があるようです。
(とはいえ前回の論文(1割近く)と比べそんなに変わらない結果でした)

コードでは、左打席が右打席に比べ一塁ベースに1m近いです。
正しい結果ですね。

では、どのパラメータが打率に本当に相関しているのか?を単回帰分析で求め、
相関しているパラメータ群を重回帰分析して、各パラメータの相関度合いを確認します。

あとはOPS、HR率なども調査しておきました。改良した分析用コードも載せておきますね!

打率の各パラメータの相関関係

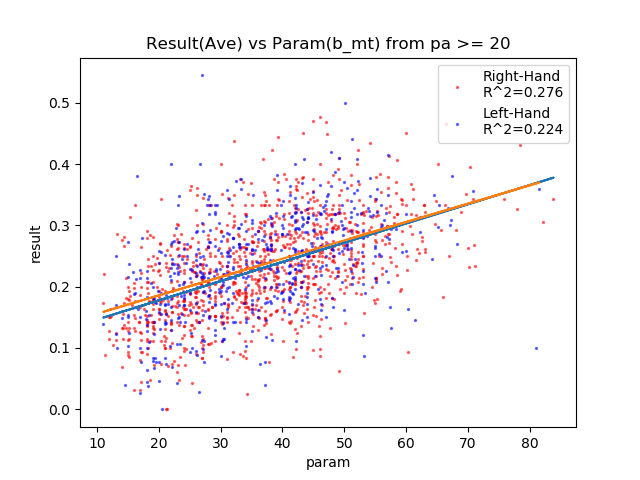
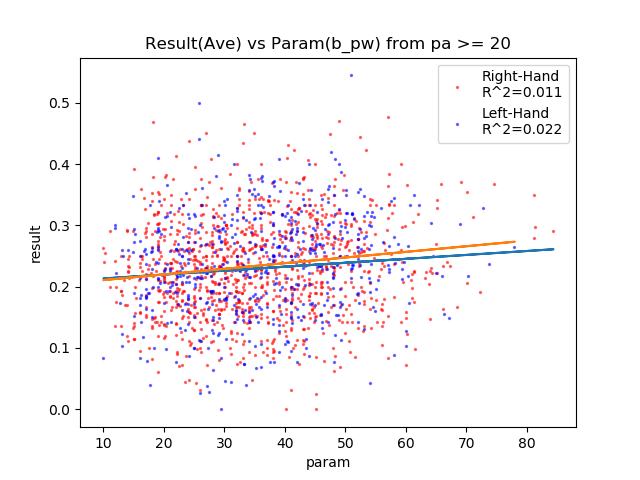
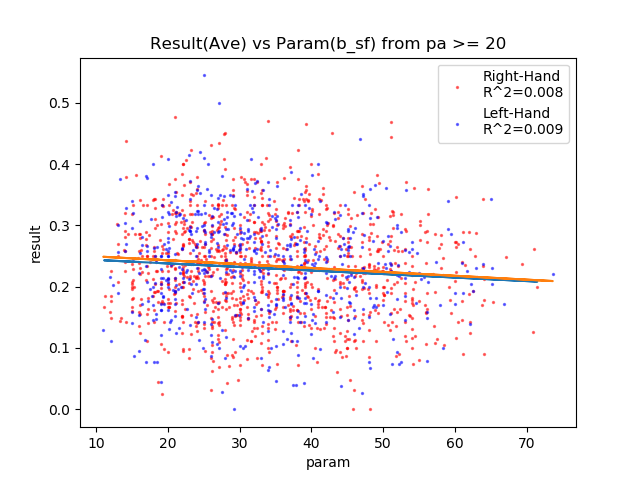
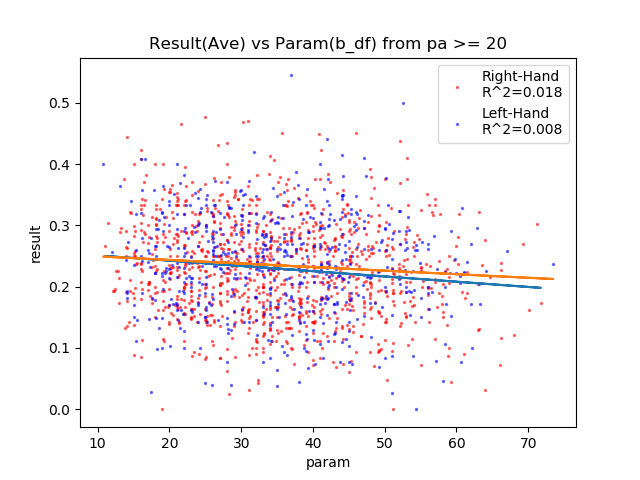
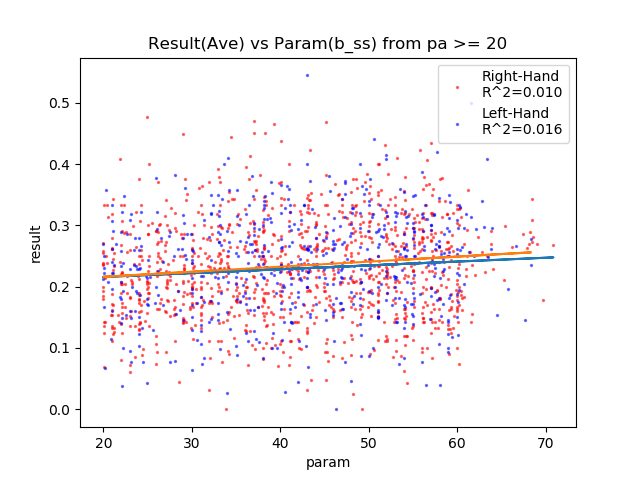
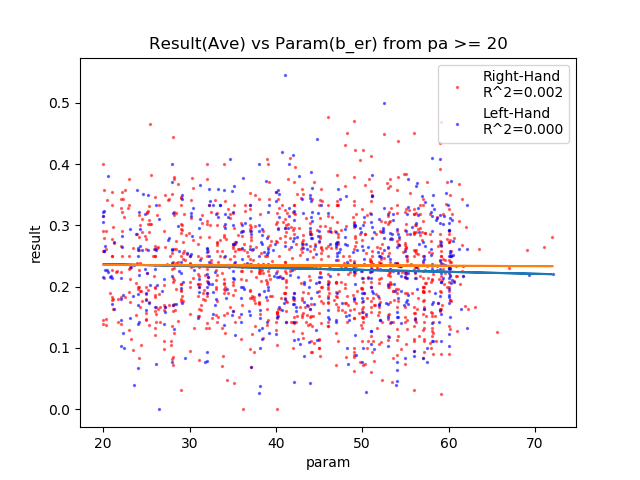
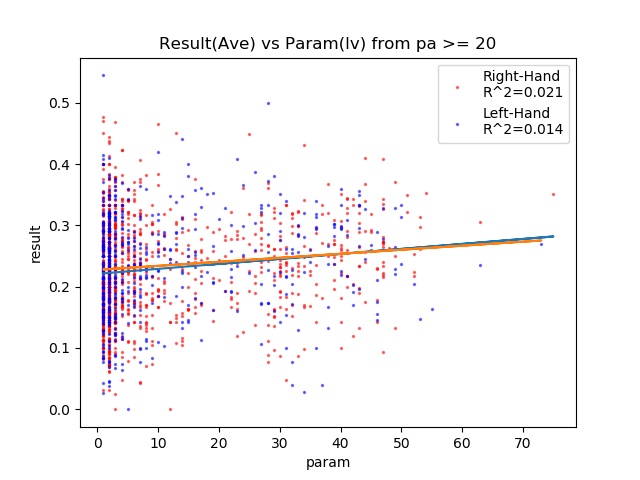
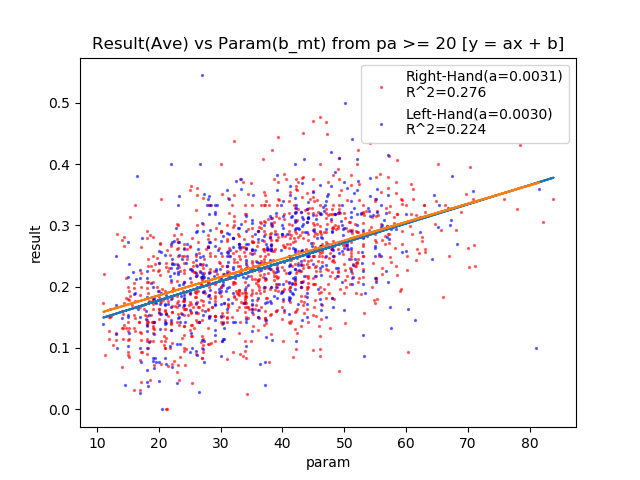
図の見方
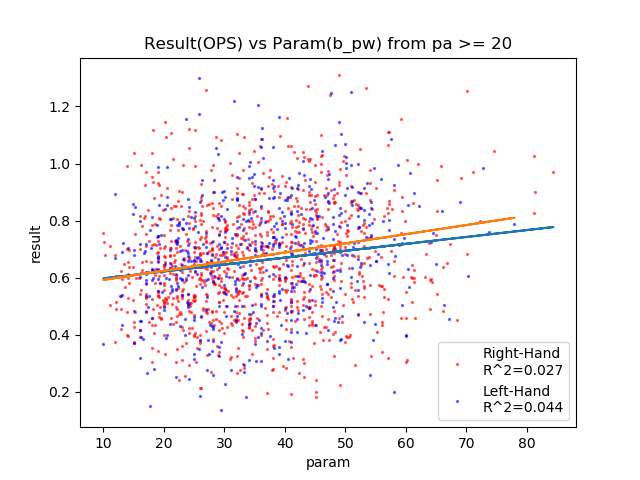
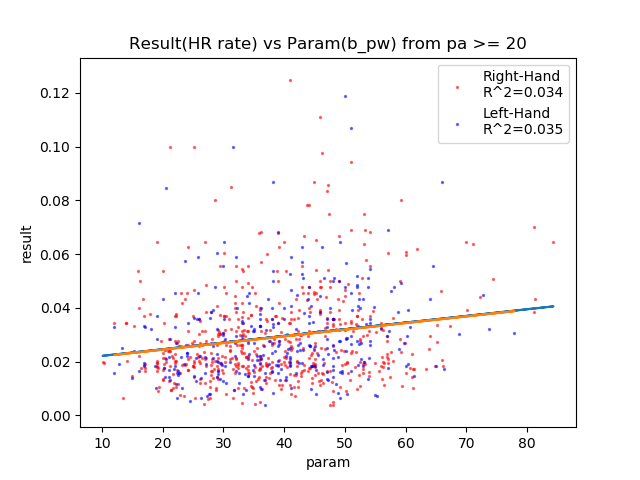
タイトル:「Result(***) vs Param(xxx) from pa >= 20」
結果(***)へのパラメータ(xxx)の相関図(20打席(pa)以上)
Right-Hand:右打、Left-Hand:左打
R^2=決定係数。0~1を取る。1に近いほど相関していると言える。
(>=0.010が2つで相関あり○、1つで相関あり△、なしで相関なし×)

一覧表:

パラメータ 相関± 右打R^2 左打R^2 相関
b_mt + 0.276 0.224 ○
b_pw + 0.011 0.022 ○
b_sp ? 0.001 0.002 ×
b_sf – 0.008 0.009 ×
b_df – 0.018 0.009 △
b_ss + 0.010 0.016 ○
b_er – 0.002 0.000 ×
lv + 0.021 0.014 ○
cond + 0.014 0.008 △
type_b ? 0.003 0.000 ×
type_b(R) – 0.013 0.020 ○
type_b(C) + 0.027 0.006 △
type_b(F) ? 0.000 0.007 ×

b_mt、b_pw、b_ssが相関している。

lv(レベル)とcond(調子)は上がれば上がるほど、上記3つのパラメータが上がるので相関するはずという見込みで計算しました。
その通りでした。

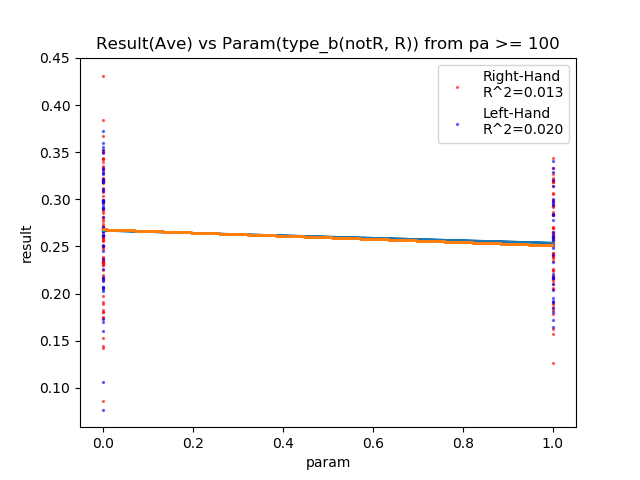
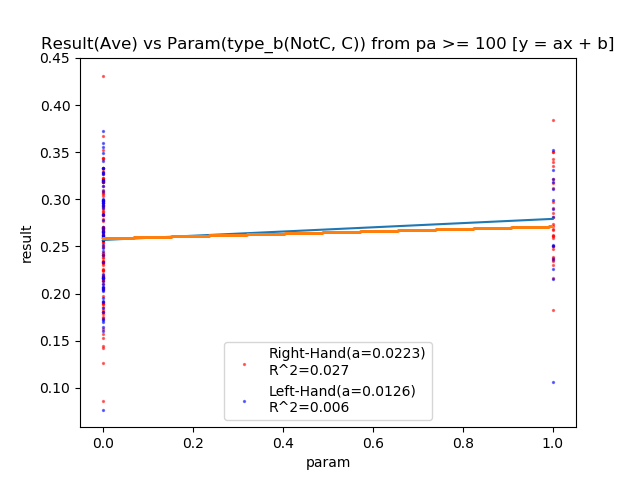
type_b(打席位置:隠しパラメータ)は、R(後ろ)がマイナスに相関、C(中央)がプラスに相関△、F(前)が相関なし。
Rは剛速球対応用で、Fが超変化球対応用として設計しました。Rは変化球に弱く、Fは速球に弱いという裏設計ですね。
現在はC=F>Rです。速球投手が増えればRが台頭してくるはず!

重回帰分析:
Ave(R)
Name Coefficients
2 b_ss 0.000343
1 b_pw 0.000550
0 b_mt 0.003096
切片:0.08263525884539452
Ave(L)
Name Coefficients
2 b_ss 0.000450
1 b_pw 0.000852
0 b_mt 0.002925
切片:0.07878629626174283

各相関図:

ミートはとてもキレイな相関図になってます。
左右どちらも変わらないんですね!


パワーは相関してる・・・?相関してるか。みたいな図ですね。


走力は相関なし。
不思議です。要調査ですね。


肩力は相関なし。
マイナス相関してそうに見えます。肩が上がればその分ミートとパワーが下がるしね。


守備力は相関あり△。
マイナス相関してそうに見えます。守備が上がればその分ミートとパワーが下がるしね。


反応は相関あり。
あまり偏回帰係数は大きくなさそう。


エラー回避は相関なし。
反応とエラー回避はランダムで決定される(=その他のパラメータから独立している)ので、そんなものですね。


選手Lvが上がれば打率が上がる!
育成での能力アップと、打てない人はそれまでに淘汰されてるしわかるかな。
・・・Lv70とか誰だ?


調子は相関あり△。
調子は経時変動あるから実際わからない。


R(-1)、C(0)、F(+1)として設定。
相関なし。


Rはマイナスに相関。(NotR=C,F)


Cはプラスに相関。(NotC=R,F)


Fは相関なし。(NotF=R,C)
これは不思議ですね。

OPSの各パラメータの相関関係

一覧表:

パラメータ 相関± 右打R^2 左打R^2 相関
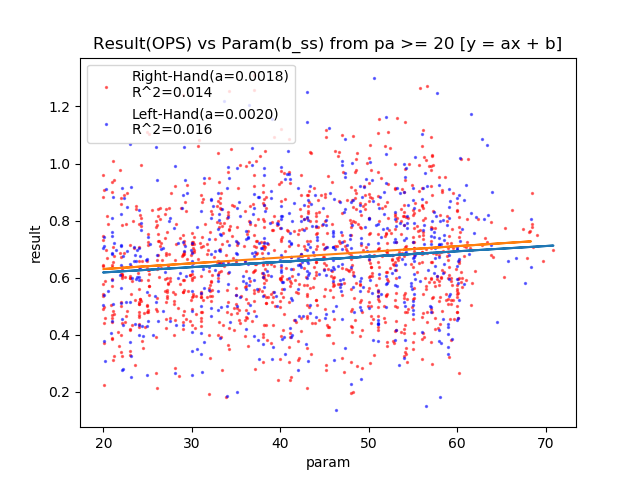
b_mt + 0.218 0.183 ○
b_pw + 0.027 0.044 ○
b_sp ? 0.001 0.001 ×
b_ss + 0.014 0.016 ○

これもミートが圧倒してますね・・・。

重回帰分析:
OPS(R)
Name Coefficients
2 b_ss 0.001203
1 b_pw 0.002206
0 b_mt 0.006626
切片:0.28842150643875264
OPS(L)
Name Coefficients
2 b_ss 0.001145
1 b_pw 0.003046
0 b_mt 0.006414
切片:0.28466512542137623
左右の違いがわからない。

各相関図:

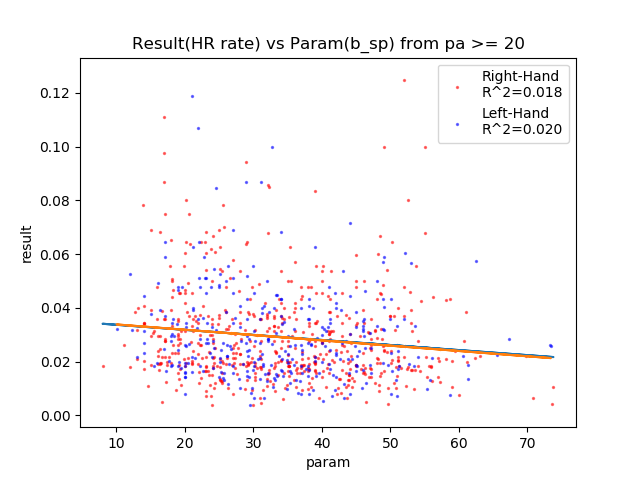
HR率の各パラメータの相関関係

結果:
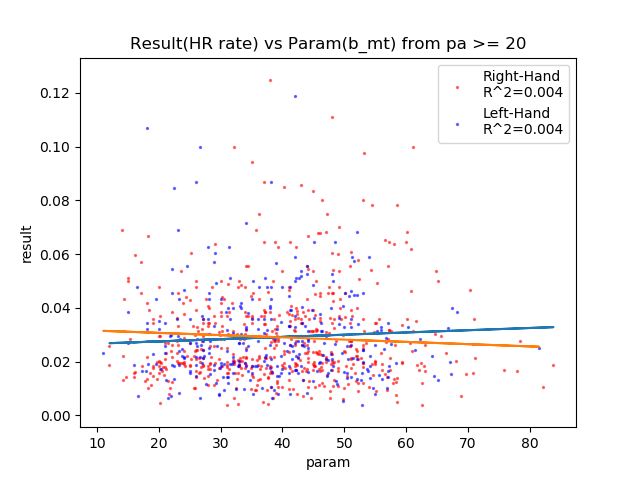
やっぱりパワーだけしか相関しなかった。
ただしパワー100でもそんなにHR率は上がらない。悲しい。

各相関図:

コード

# -*- coding: utf-8 -*-

import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn import linear_model

# 基礎設定
file_name = 'meisyo_b 20181217.csv'

# CSV読み込み
df = pd.read_csv(file_name, encoding='utf-8')

# 投手能力結合・削除
for i in ['sp', 'co', 'st', 'bb1n', 'bb2n', 'bb3n']:
    df['p_'+i] = df['p_'+i] + df['pt_p_'+i] + df['pw_p_'+i]
    df = df.drop(['pt_p_'+i, 'pw_p_'+i], axis=1)

# 野手能力結合・削除
for i in ['mt', 'pw', 'sp', 'sf', 'df', 'er', 'ss']:
    df['b_'+i] = df['b_'+i] + df['pt_b_'+i] + df['pw_b_'+i]
    df = df.drop(['pt_b_'+i, 'pw_b_'+i], axis=1)

# 欠損値のある行を把握
# print(df.isnull().sum())

# 全体で欠損値のある行を削除
df = df.drop(['skill', 'g_pos', 'grow_type'], axis=1)

# 打席数*未満を削除
df = df.where(df['ab'] >= 20).dropna()
#df['type_b'] = df['type_b'].replace({'F': 1, 'C': 0, 'R': 0})

# R/L
R = df.where(df['side_b'] == 'R').dropna()
L = df.where(df['side_b'] == 'L').dropna()

# データ把握
# print(df.columns)
# print(df.head())
# print(R.head())
# print(L.head())
# print("R(" + str(sum(R['ab'])) + "):"+ str(sum(R['h']) / sum(R['ab'])))
# print("L(" + str(sum(L['ab'])) + "):"+ str(sum(L['h']) / sum(L['ab'])))

# 結果出力
dR = pd.DataFrame(index=[], columns=[])
dL = pd.DataFrame(index=[], columns=[])
dR['ave'] = R['h'] / R['ab']
dR['obp'] = (R['h'] + R['bb'] + R['hbp']) / (R['ab'] + R['bb'] + R['hbp'] + R['sf'])
dR['slg'] = R['tb'] / R['ab']
dR['ops'] = dR['obp'] + dR['slg']

dL['ave'] = L['h'] / L['ab']
dL['obp'] = (L['h'] + L['bb'] + L['hbp']) / (L['ab'] + L['bb'] + L['hbp'] + L['sf'])
dL['slg'] = L['tb'] / L['ab']
dL['ops'] = dL['obp'] + dL['slg']

yR = dR.values[:, 0]
yL = dL.values[:, 0]

# 相関係数
list = ['b_mt']
xR = R.loc[:, list].values
xL = L.loc[:, list].values

# title
plt.title("Result(Ave) vs Param(b_mt) from pa >= 20 [y = ax + b]")
plt.xlabel("param")
plt.ylabel("result")

# plt 回帰係数
model_R = linear_model.LinearRegression()
model_L = linear_model.LinearRegression()
model_R.fit(xR, yR)
model_L.fit(xL, yL)

# plt 散布図
plt.scatter(xR, yR, s=2, c="red", alpha=0.5, label="Right-Hand(a="+str("{0:.4f}".format(model_R.coef_[0]))+")\nR^2="+str("{0:.3f}".format(model_R.score(xR, yR))))
plt.scatter(xL, yL, s=2, c="blue", alpha=0.5, label="Left-Hand(a="+str("{0:.4f}".format(model_L.coef_[0]))+")\nR^2="+str("{0:.3f}".format(model_L.score(xL, yL))))

# plt 回帰
plt.plot(xR, model_R.predict(xR))
plt.plot(xL, model_L.predict(xL))

print("Ave(R)")
print(pd.DataFrame({"Name":list, "Coefficients":model_R.coef_}).sort_values(by='Coefficients') )
print(model_R.intercept_)

print("Ave(L)")
print(pd.DataFrame({"Name":list, "Coefficients":model_L.coef_}).sort_values(by='Coefficients') )
print(model_L.intercept_)

# show
plt.legend()
plt.show()
sys.exit()

ひとこと

図示することは大事ダナーと思いました。
だって数値だけでは全然わかりませんから!

出た数値を使って歴代優勝校の選手を生成します。(^q^)

[Meisyo]左投右打が出過ぎで気持ち悪い件の分析

本日フリーゲーム夢現に初コメントが付いたのでワクワクして見ました。

#————————————————————-#
フリーゲーム夢現の’名将と呼ばれた者達’にコメントが投稿されました。
運営が公開処理するまでこのコメントは表示されません。(※投稿されてから約1日程度)

————————-
[コメント投稿者] 匿名

■ コメント内容 ■
左投げ右打ちの選手が出過ぎでちょっと気持ち悪いです

————————-

【投稿されたページを見る】
https://freegame-mugen.jp/simulation/game_7374.html
#————————————————————-#

お・・・おう・・・。そうか。

というわけで、どれくらい気持ち悪いのか数値化してみます。

やること

  1. コード確認
  2. データ把握
  3. あるべき姿(論文等)の調査
  4. 現状とあるべき姿の比較
  5. 改善点
  6. まとめ

コード確認

選手生成のコードを確認。

        // 投
        if(mt_rand(1, 1000) >= 115){ $CD['side_p'] = 'R'; }else{ $CD['side_p'] = 'L'; }

        // 打
        if(mt_rand(1, 100) >= 35){ $CD['side_b'] = 'R'; }else{ $CD['side_b'] = 'L'; }

投、打はどちらも独立に判定される。
投:88.5(=100-11.5)%で右投、その他(11.5%)で左投
打:65(=100-35)%で右打、その他(35%)で左打

このコードから、それぞれが起こる可能性は以下の通りです。
(全体合計は1。ただかけ合わせるだけです。)

右投 左投
右打 0.57525 0.07475
左打 0.30975 0.04025

※検算済み

約7.5%で左投右打ちが出てくる計算です。

データ把握

実際データはどうなってるの?ということで計算してみました。
データセットは[Meisyo]ビッグデータから学ぶ試合の基礎設計4のモノを使用しています。
*このデータで注意すべきは2点。成績準拠なので、「試合に出場した選手のみのデータが記録されていること」「任意でデータを削除できること」ですね。

データセット結果:
Total:6558
RR:3778(0.576)
RL:1991(0.304)
LR:527(0.080)
LL:262(0.040)

コードでの指定:

右投 左投
右打 0.57525 0.07475
左打 0.30975 0.04025

0.005分LRが上に、RLが下にぶれています。
6.7%程度の変動ですね。
これ分散値とか計算できるのか?
おおよそコードとデータは違っていないと判断します。(判断基準があいまい)
計算には実データを使っていきます。

計算コード:

# -*- coding: utf-8 -*-

import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 基礎設定
file_name = 'meisyo_b 20181217.csv'

# CSV読み込み
df = pd.read_csv(file_name, encoding='utf-8')

# 基礎設定
an = pd.DataFrame(index=[], columns=[])

# 投/打把握
an['side_p'] = df['side_p']
an['side_b'] = df['side_b']

# print(an)

# 集計
date = {'RR':0, 'RL':0, 'LR':0, 'LL':0}
for index, row in df.iterrows():
    key = row['side_p'] + row['side_b']
    date[key]+=1

# 表示
print("Total:" + str(len(an)))
for key in date.keys():
    print(str(key) + ":" + str(date[key]))

あるべき姿(論文等)の調査

野球の右投左投等のデータがありそうな論文と言えば、セイバーメトリクス関係か右/左打でどれだけ成績が変わるのか的な論文だと思いました。ということで調べました。
The Success of Sinister Right-Handers in Baseball(October 26, 2017)
超日本語訳:野球で成功したいなら右打ちはやめとけ

Abstract:
This new analysis of data on 17,564 professional baseball players shows a distinct advantage in hitting for those who bat left-handed but throw right-handed. The findings argue against any advantage due to hemispheric lateralization.
Abstract超日本語訳:
17,564人ものプロ野球選手のデータから分析した結果は、左バッターが右バッターに比べて優位(有意)なアドバンテージを持っていることを示した。この発見は他の全てのアドバンテージを跳ね返す力を持っている。

わースポーツ医学の論文カナー・・・

Table1に結果が載ってました。

結果:
All recorder major league players(N=5663)
Percent of Players
RR:63.2%
RL:19.0%
LL:12.3%
RB:4.7%
LR:0.5%
LB:0.3%
(B=両打ち)

現状とあるべき姿の比較

現状とあるべき姿のデータが取れたので比較し、相関関係を確認します。

データセット結果:
Total:6558
RR:57.6%
RL:30.4%
LR:8.0%
LL:4.0%

あるべき姿の結果:
All recorder major league players(N=5663)
Percent of Players
RR:63.2%
RL:19.0%
LL:12.3%
RB:4.7%
LR:0.5%
LB:0.3%
(B=両打ち)

0.5%であるべきところが、8.0%って・・・。差が大きくないか・・・?たしかに気持ち悪い。
以下、両打を無視して計算します。

あるべき姿:
右投:
 右打:左打=63.2:19.0(ALL82.2)
 =77:23

左投:
 右打:左打=0.5:12.3(ALL12.8)
 =4:96

現状は投げ・打ちは互いに独立ですが、あるべき姿では関連性ありですねー。

改善点

コードはこんな感じかなと。

        if(mt_rand(1, 100) >= 13){
            $CD['side_p'] = 'R';
            if(mt_rand(1, 100) >= 23){ $CD['side_b'] = 'R'; }else{ $CD['side_b'] = 'L'; }
        }else{
            $CD['side_p'] = 'L';
            if(mt_rand(1, 100) >= 96){ $CD['side_b'] = 'R'; }else{ $CD['side_b'] = 'L'; }
        }

まとめ

確かに気持ち悪い量の左投げ右打ちの選手が生成されていました。

よく考えてみると、プロ野球選手でも左投げ右打ちの選手いないですね。
野球エリートだと幼い内に左投右打なら左打に矯正されるし、そっちのほうが結果もいいみたいだし。
まあ生涯打率で1割違ったらねえ・・・。

今回MLBのデータを使いましたが、それでもLL>>LRなのでそういうものなんですね。
諸説では「あちら(米国)のほうが個人の意思を優先する」とのことですが、ここまではっきりとした差(LL24:LR1)ならしょうがないね。

コメントありがとうございました!