平成最後の公式戦がありました。

これまで優勝2回の強豪、ジャガ畑
vs
並みいる強豪を倒してきたダークホース、ふたもじ
その結果はこちら
優勝おめでとうございます!
Webサービス制作のための技術情報を。データ分析(Python、機械学習コンペ他)や自作野球ゲームMeisyoのこと中心。
[Meisyo]ビッグデータから学ぶ試合の基礎設計4から早4か月。
「速球の上方修正してほしいな」というコメントが届きました。

すみません!
制球に比べ、速球は蔑ろにされてきたことはわかっております。
速球投手が強くなるように調整を近日中に行います。
今回は、速球の補正値を上方修正するために、速球の高低でどれくらい打率が変わるのか検証します。
・速球の補正値を上方修正する。
・あるべき姿を設定する
速球が上がれば打率はかなり落ちる
・現状把握
・全体データ読み込み
・分析
・解決策の提示
速球が上がれば打率はかなり落ちる
→かなりってどれくらい?
3割程度の減少を見込んでいます。
→現状どうなってんの?
[Meisyo]ビッグデータから学ぶ試合の基礎設計3を見る限り、速球が上がると防御率、WHIPともに上がってる。・・・ゲーム設定大丈夫か?
→速球をどれくらい上げれば明確な差が出るの?
それはデータ見てから設定しよう。
SQLで必要データのみ抽出
↓
Pythonでデータクレンジングとか
直球(pc_br=0)の投球コースを把握

設計通り隅に投げ分けています。
ヒット系 = 1、空振り等 = 0として計算。あとは関係ないログを削除しました。
# ヒット = 1, 打ち損じ = 0
df_test['result'] = df_test['result'].replace(['HR', '1B', '2B', '3B'], 1.0)
df_test['result'] = df_test['result'].replace(['MH', 'SS', 'SF', 'DP' ,'FB'], 0.0)
# 関係ない項目を削除
df_test = df_test[df_test['result'] != 'POINT']
df_test = df_test[df_test['result'] != 'BB']
df_test = df_test[df_test['result'] != 'SB']
df_test = df_test[df_test['result'] != 'SBO']
df_test = df_test[df_test['result'] != 'ER']
df_test = df_test[df_test['result'] != 'SO']
df_test = df_test[df_test['result'] != 'BN'] # 振っていない
df_test = df_test[df_test['result'] != 'SN'] # 振っていない
ヒット系(赤)、打ち損じ(青)で表示しました。

うん。ほとんど違いが判らない・・・。

球速が速いほど、被打率は下がってそうですね。

分布は同じ感じ・・?ですね。絶対数が違います。

いい感じで被打率が球速によって落ちています。
すごくきれいに線が引けそうなグラフです!
[math]p = sp * -0.00118 + 0.32[/math]
重相関 R=0.868
速度spが1km早くなると0.118% 被打率(打率ではない)が落ちる。
球速の補正値は以下の通り。
$rand_mt = mt_rand(0, (($G['pc_bbC'] - $G['bt']['S_b_ss']) / 10 + 1) * 1000)/1000; // 速球 vs 反応
ブレの最大値(cm)は[math]((sp – ss) / 10 + 1)[/math]で表される。
反応の平均値が[math]AVG(BTss) = 40.09[/math]
速球の計算値(調子、ランダム値は平均値)は
$km = floor(0.8576 * $st_sp + 83.74);
を考えると、
140km/hの場合、st_spは65.60
その場合の被打率は0.1548。
ブレの最大値(cm)は[math]((sp – ss) / 10 + 1) = 25.51 / 10 + 1 = 3.551[/math]であり、
最小値0、最大値が3.551なので、ブレの平均値は1.78cm。
ブレがなくなる → sp = ssの場合(sp=40.09)は
被打率は0.2727
そのことから、[math](0.2727 – 0.1548) / 1.78 = 0.06623[/math]
1cmのブレに対して被打率が0.06623下がるので、
140km時点の被打率を3割下げることを想定すると、
被打率は0.1086となり、ブレはさらに0.6975cm程度必要となる。
つまり、ブレの最大値を4.955cmにする必要があるので、
補正値は[math]((sp – ss) / 6.45 + 1)[/math]で表される。
補正値は[math]((sp – ss) / 6.45 + 1)[/math]とする。
そうすることで速球の被打率が現行の70%になることが予想される。
速球投手がだいぶ強くなりました!
これで速球投手が報われるとよいのですが・・・。
試合で一球ごとの分析用DBを追加しました。
なぜかというと、試合での投手vs打者における投球と打撃結果の因果関係が分からなかったからです。
もっとカンタンニシテ・・・
例えば・・・
どのコースは打たれにくいのか?
変化球で打たれにくい球種はあるのか?
ヒットになるとすればどのコースに飛んでいるのか?(守備はどこに重点を置くべきか?)
に答えるためです。

とりあえずは作りました。(使えるとは思うけど・・・)
今からデータ収集するので使えるようになるには半月くらいかかりそうですね。
他のサイトの説明が釈然としなかったので投稿。
以下のref0~2番のホストを抽出したいとする。
ref[0] = "http://www.other.com/path1/index.php?k1=v1&k2=v2#Ref1"
ref[1] = "http://www.other.net/path1/index.php?k1=v1&k2=v2#Ref1"
ref[2] = "https://www.other.com/"
*ホスト名 0 = www.other.com
SQLでは以下の通り。
substring(ref from 'https?://([^/]*)')
出力は[0] = www.other.com
関数:
substring(抽出文字列, 開始桁, 切り取り文字数)
正規表現:
(1)https?
「?」の使い方:「X?」=Xを0or1文字
httpの後に「sを1文字」または「何もつけない」という意味。
[http|https]と同義。
基本SSL準拠でないと警告が出る仕組みになったので、今後はhttpsが増えてくると思います。
(2)([^/]*)
分解して考えると、[^/]に*が付いて、その外側に()。
手順1. [^/]は「^ = ではない」「/」を[](1文字)なので、
「/」ではない「1文字」と読み替える。
手順2. *は直前の文字の0回以上の繰り返し(最長一致)なので、
「/」ではない文字が出てくるまでの文字列が出力される。
手順3. そこに() = フォーカスする。
ということで、0ではwww.other.comが出力される。
手順3をなしにしてみると・・・
substring(ref from 'https?://[^/]*')
[0] = http://www.other.com が出力される。
さらに、変な位置に()をつけると、
substring(ref from 'https?://([^/])*')
「/ではないの文字列の最後の一文字」を出力できる。
つまり、0の場合comの最後のmだ。意味があるのかは置いといて。
[^/]を[^.]に変えると、
substring(ref from 'https?://([^.]*)')
最初の「.」までのwwwが出力される。
とまあ、こんな感じで分解して考えるといいだろう。
「練習ごとに難易度が違いすぎるんですけど!!」という不満は把握しています。
ただ、これまでそこには触れてきませんでした。
なぜなら・・・まだデータ取れてないし、分析できないでしょ(言い訳)
・・・怠慢デスネ!
とりあえず大枠でざっくりと分析します。
データ取得開始~2019/02/28
| sub | action  1 |
point_avg | point_stddev |
|---|---|---|---|
| practice | 5 | 26 | |
| practice | game1 | 146 | 53 |
| practice | game10 | 142 | 45 |
| practice | game11 | 189 | 35 |
| practice | game12 | 112 | 55 |
| practice | game2 | 148 | 39 |
| practice | game3 | 169 | 53 |
| practice | game4 | 87 | 38 |
| practice | game5 | 134 | 53 |
| practice | game6 | 112 | 55 |
| practice | game7 | 142 | 41 |
| practice | game8 | 144 | 59 |
| practice | game9 | 133 | 35 |
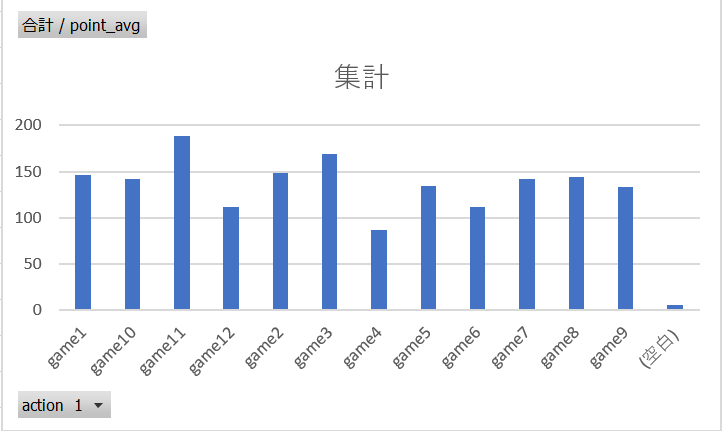
すると、game4が難しくて、game11が簡単なのでは?という疑問が生まれてきます。
game4

game11

「あっ・・・確かに。」とプレイしている身からは腹落ちします。
だってgame4で200ポイント=5ビンゴしないもん。無理。
game11は簡単すぎて笑えないし。
コードは以下の通り。
SELECT
	sub
    , SUBSTRING_INDEX(action, ',', 1) AS action
    , CEIL(AVG(SUBSTRING_INDEX(action, ',', -1))) AS point_avg
		, CEIL(STDDEV(SUBSTRING_INDEX(action, ',', -1))) AS point_stddev
FROM
	acts
WHERE
	sub = 'practice'
	AND time < '2019-03-01 00:00:00'
GROUP BY
	SUBSTRING_INDEX(action, ',', 1)
ORDER BY
	action;
今回の分析の目的は、「練習の得点をだいたい150%平均くらいにしたい」にします。
目的が決まっていないと、分析したけど「で?どうすんの?」という話なので。
下記の流れで進めます。
1・分布の確認。(現状把握)
2・目的達成へのアプローチを考える。(仮説設定)
3・分布の推移を見る。(効果検証)次回以降
このように、現状把握→仮説設定→検証→・・・の流れで進めます。
まあいたって普通な流れですね。
ゲーム:ストップウォッチで*秒で止める。

集計データ:
平均:146
標準偏差SD:53
「とりあえず目標は達成してるんじゃないかな?」と思います。
分布:

集計データから一転、「正規分布とは一体どこへ・・・」みたいな分布になっています。
「得点が正規分布する=ユーザーは成長しない」という前提に立っていることに注意してください。
「十分にプレイした後(=伸びしろがない状態)で集計する」なら正規分布するであろうと。
考えられる仮説としては、「最初はユーザーが慣れていなかったが、慣れたら簡単だった」という。
ならユーザー毎の時系列での成長傾向を調べようってなりますね。
\そもそも数が少ない/
数が少ないと継時変化のデータの取りようがない。
コードとデータは以下の通り。
データ:
meisyo_acts_20190303.sql
SQLです。PHP MyAdmin等に即インポートできます。(ゴミデータも混じってるので扱いには注意が必要)
SEQというseqカラムに0~999まで入れたテーブルを別途作成してください。
コード:
21行目の「game1」を変更すれば、全練習に対応可能です。
SELECT
	SEQ.seq as point
	, COALESCE(ACT.count, 0) as count
FROM
	(SELECT
		(seq * 10) AS seq
	FROM
		an_seq
	WHERE
		seq BETWEEN 0 AND 20) AS SEQ
LEFT JOIN
	(SELECT
		SUBSTRING_INDEX(action, ',', 1) AS act
		, CEIL(SUBSTRING_INDEX(action, ',', -1)/10)*10 AS point
		, count(*) AS count
	FROM
		acts
	WHERE
		sub = 'practice'
		AND time < '2019-03-01 00:00:00'
		AND SUBSTRING_INDEX(action, ',', 1) = 'game1'
	GROUP BY
		act, point
	ORDER BY
		act, point) AS ACT
ON SEQ.seq = ACT.point
ORDER BY
	SEQ.seq
;
実施内容:
とりあえず150点くらい取れるので、game1は何もしません。
ゲーム:任意の桁数の数値を打ち込む
集計データ:
平均:148
標準偏差SD:39
とりあえず150近くだし問題ないよね
分布:
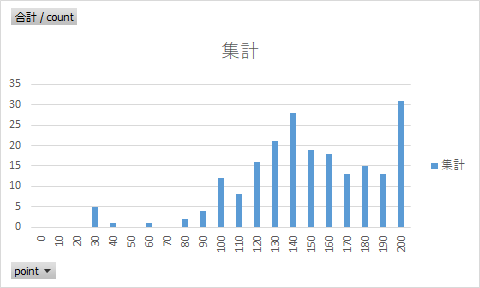
200が多いのが気になる。30もあるのか・・・。
ただし、平均が140あたりで正規分布の山を作っていると仮定すると、
真の200が15、210が10、220が5(合計30)と予想できるので、それが200に積まれている・・・のかな?
問題なさそうですね。
実施内容:
何もしなくてOK。
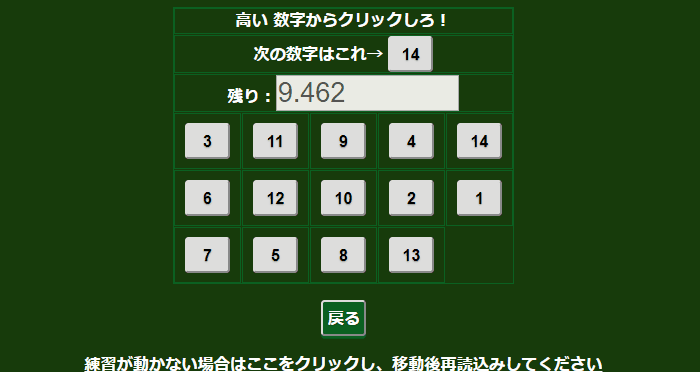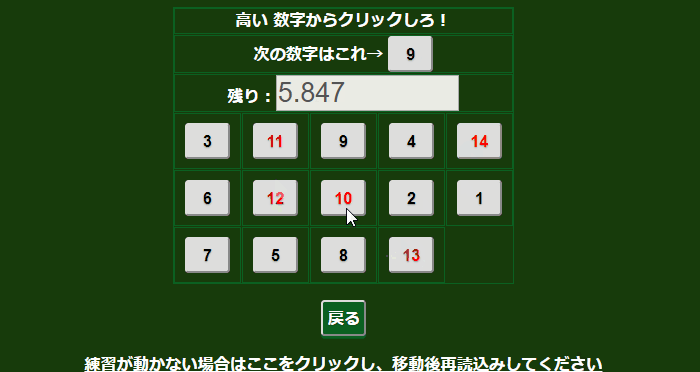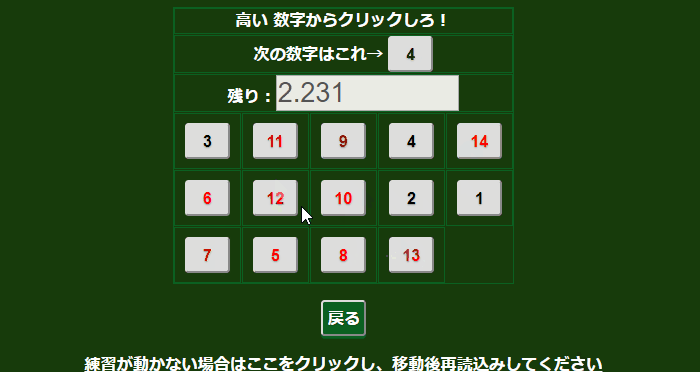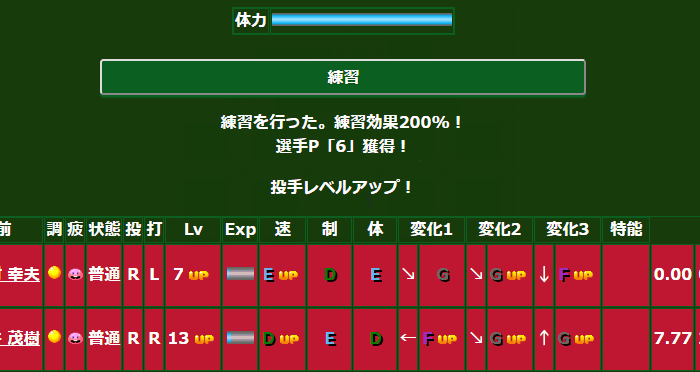
ゲーム:指定された順番に文字をクリックしていく
集計データ:
平均:169
標準偏差SD:53
ちょっと高いような気がするので、下方修正を掛けたい
分布:
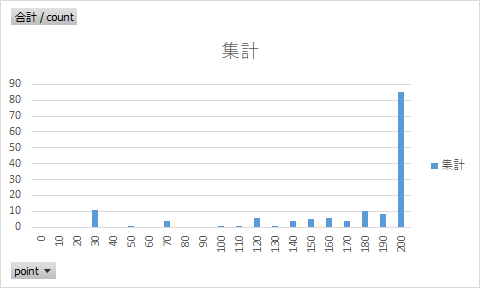
簡単すぎたワロタ・・・
集計データと全然印象が違いますね。
現在は1数字=0.8秒で計算しているので、それを調整します。
では、何秒にすればいいのか?
ちょっとよくわからないですが計算してみます。(正しいかどうかは置いといて)
現在は147回中、得点が200に85回(57.8%)集中しているので、
真の中心は200より右にあることが想定できる。
加えて、グラフの通りこの分布は一様分布(各得点の分布が同じくらい)であることを仮定できる。
一様分布のため、真の200が10程度(6.8%)とすると、210以降に分布する確率は50%となる。
そのため、平均値は200~210の間になる。
現在の1数字あたり0.8秒であると、平均値は200~210(205とする)。
1数字あたり0秒とすると、平均値は0になる。(そりゃそうだ。実際は最低補正25が入るんだけども。)
数字あたりの秒数が平均値と正比例すると仮定すると、係数は「256.25 * 秒」となる。
この値が150程度になってほしいので、
256.25 * 秒 = 150
ゆえに、秒=0.585
実施内容:
1打=0.585秒に修正する。
結構無理やりな気がする。ただ効果の検証を行えれば、この仮定(数字あたりの秒数が平均値と正比例する)が正しいか確認できる。
で、200から下に分布の中心が来たら、正規分布等々の推定ができる。
今はどっちもわからないので、とりあえず試そう。
ゲーム:スロットマシン。すべての数字を一致させたい。(願望)
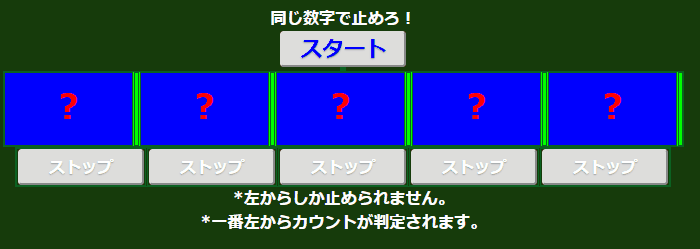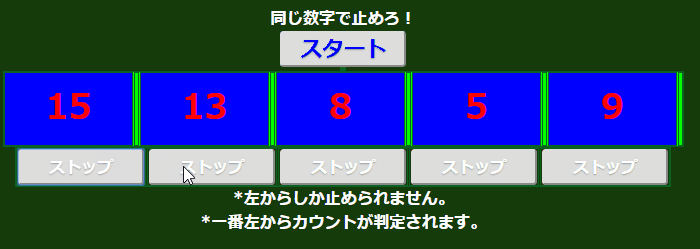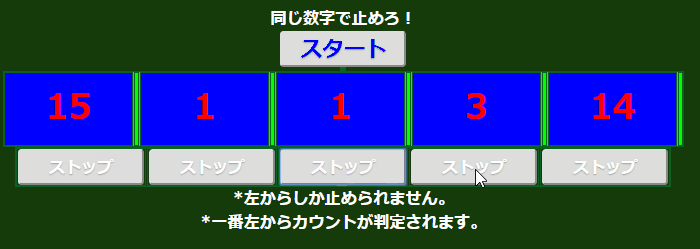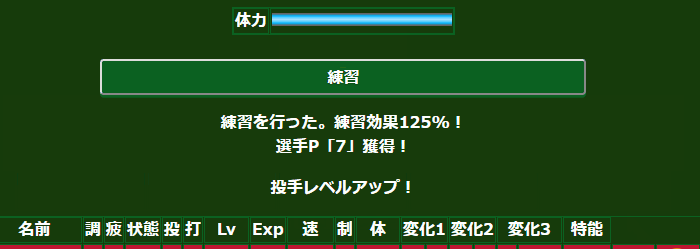
集計データ:
平均:87
標準偏差SD:38
とりあえずヤバい(語彙力)
ちなみに得点最下位なので、てこ入れは必須ですね。
分布:
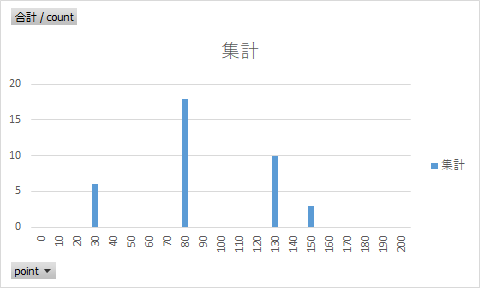
意外とまともな分布かもしれない。平均値は置いといて。
200も一応存在するんですが、誰一人として到達しませんでした!
条件:
・数字は1~15。
・スロットの数は5個。
・得点(ビンゴ数)は、25(0),75(1),125(2),150(3),200(4)の通り。
・各スロットの速度(更新速度(ms))は、120,100,80,65,50。
合計試行回数37って少なくない・・・?他は200まで行っているものがあるのに。
毛嫌いしてるんでしょうか。僕もコレ嫌いです。
ビンゴ3個(X-X-X-X-n)で約8%。
場合分けで考えられないのが厳しい・・・。
なぜなら、それぞれのスロットの速度が異なるから、目押し成功率との相関係数を仮定しないと計算できないため。
更新速度が早ければ早いほど、狙う数値(±0)からの誤差が大きくなって分布の形が平べったくなっていく。
-2:|
-1:|||||
±0:|||||||||||||||||||
+1:|||||
+2:|
↓ 速度が早いと・・・
-2:||||
-1:||||||
±0:|||||||||
+1:||||||
+2:||||
ということで、更新速度をすべて統一し、100msとします。
もし、反応速度が200±10msならば、狙っていさえすれば1回86.2%程度の確率で当たる。
(0~100msを10msごと(10個)に分け、正規分布をとるとすると、片側検定の考え方で、(4*100+2*97.5+2*83.5+2*50.0)/1000=0.862)
で、面倒なこととしては、スロットで外れた値も当たり値としてカウントが可能なところ・・・と思っていたら、そんなことはなかった。
一番左の数に当たっているか?当たっていたらその数値が最優先される。
つまり、「15」「1」「15」「1」「1」でも2HITになる。
4回当てる可能性は・・・0.862^4 = 55.2%
(ん?これで計算合ってるの?)
ちなみに、ヒトの光刺激に対するボタン押し反応の速度は209ms(SD:10)(反応時 間研究の歴史と現状)だそうです。集団で反応速度を計測しており、個人として平均±SDを出しているわけではないので本当は参考にしてはならない。
実施内容:
更新速度をすべて統一し、100msとします。とりあえず。
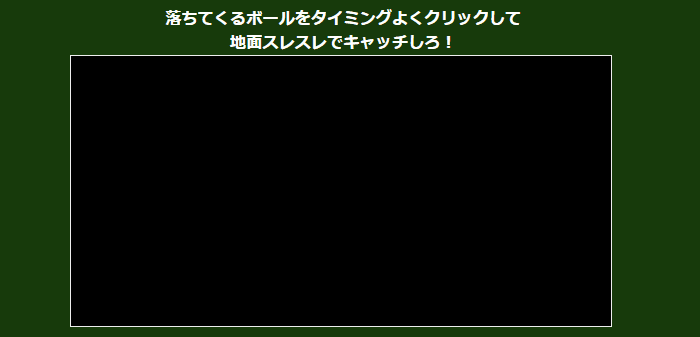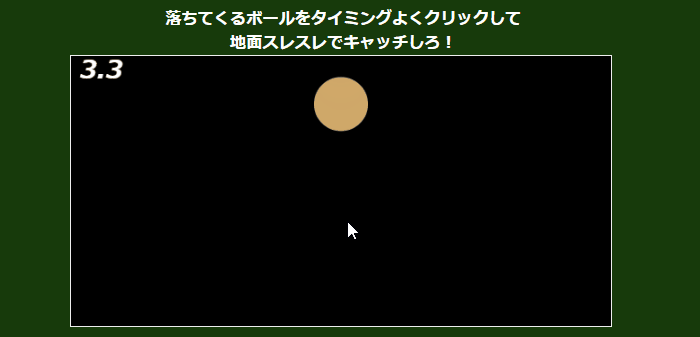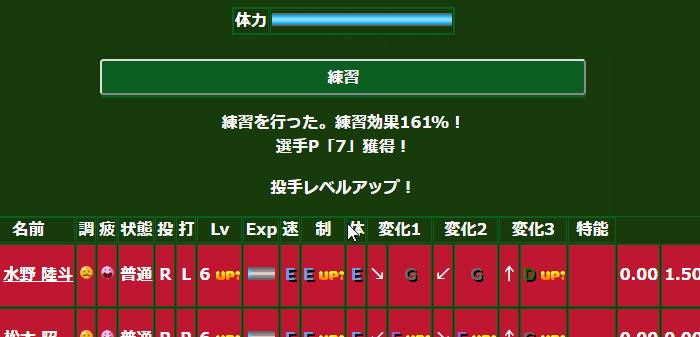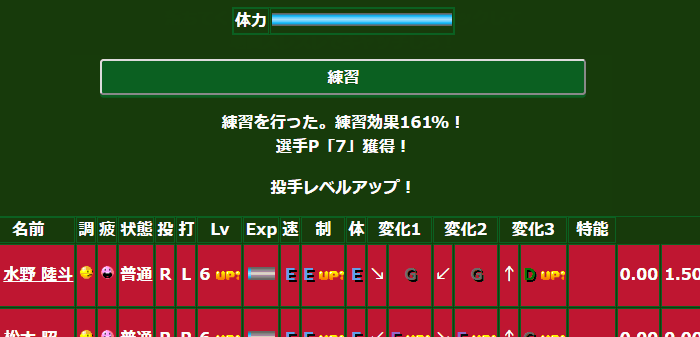
ゲーム:落ちてくるボールをタイミングよく中心でキャッチする。
集計データ:
平均:134
標準偏差SD:53
少し(10%)低いような気がします。
分布:
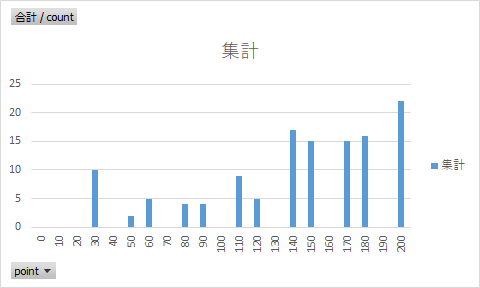
何とも言えないのですが・・・。
分布もまあまあ悪く・・・ないのか?何と言えばいいのかわからない。
ポイントの計算式は、goal(誤差ms)に-300を掛けるというおおざっぱなモノです。
myGame = -300 * Math.abs(goal) + 200;
平均134ということは、-66 = -300*(goal)
AVE(goal) = 0.22s
goal係数 * NEXT = -50にしたいので、
goal係数 = -227
実施内容:
goal係数を-227にします。
ゲーム:落ちてくるボールをタイミングよく中心でキャッチする。(縮尺変更、距離変更あり。)
集計データ:
平均:112
標準偏差SD:55
ん~・・・正規分布なら、標本内の20%程度しか150を超えていない。
上方修正が必要そうですね。
分布:
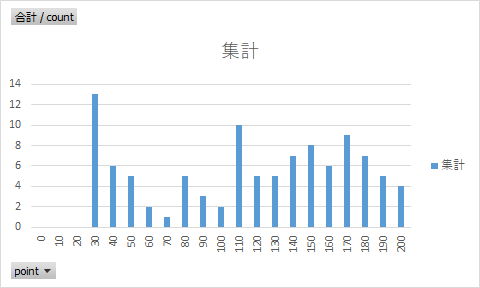
結構25が多そうやな?
縮尺(落ちる距離)がランダムで変化するので、プレイしてる側からしてもちょっと対応が難しいかもしれません。
チリみたいなのがたまに出るので・・・アレほぼ見えないです。
データ数が少ない!!
あとランダム性があるので、それをすべてまとめて分析しても因果関係が不明。
困った・・・。
というわけでgame5と同じことをします。(安直)
実施内容:
goal係数を-227にします。
ゲーム:振り子2つを中心に合わせられるようクリックする。

集計データ:
平均:142
標準偏差SD:41
とりあえず平均的だしいいよね。
分布:

ああ・・・なんだかとってもいい分布(錯乱)
割ときれいに分布しており、平均値もぼちぼちいい感じなので、
とりあえずこのままで。
実施内容:
何もしません。
ゲーム:ちょっとだけ違う色(濃淡)を判定する。

集計データ:
平均:144
標準偏差SD:59
これもまずまず。変更しなくていいかも。
分布:
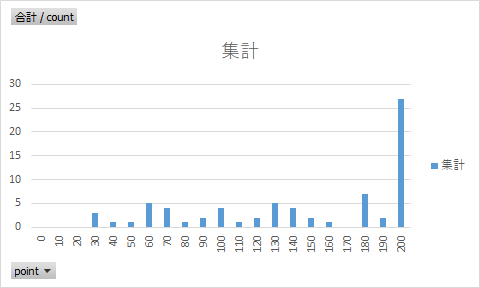
200多くない・・・多くない?(37.5%)
感想としては、そんなに早く見分けつくかなあと思いました。
携帯とかだと特にわからん気がするんだが。(色識別は苦手かもしれない)
何とも言えないのでこのまま置いときます。
実施内容:
何もしない。
ゲーム:色のついたタイルを高速でクリックする。
集計データ:
平均:133
標準偏差SD:35
少し(10%)上方修正すべきかな?
分布:
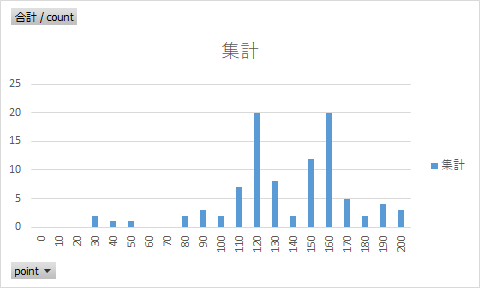
正規分布してそうだけども・・・。
ゲームとしては正解1個辺り8Pずつたまっていく。
10秒で終了。
200P=25回って0.4sに1回正解するのか。すげえな・・・。
120と160が高い理由としては、もしかして8P(10Pではない)に関わるのでは?
得点は、80, 88, 96, 104, 112, 120, 128, 136, 144, 152, 160, 168, 176, 184, 192, 200を取る。
やはり・・・120と160に割り振られる値は2個ありますね。(144が欠損してそう)
そうして見ると、山がちょうど150になってそう。
何もしなくていいかなと思いました。
実施内容:
何もしません。
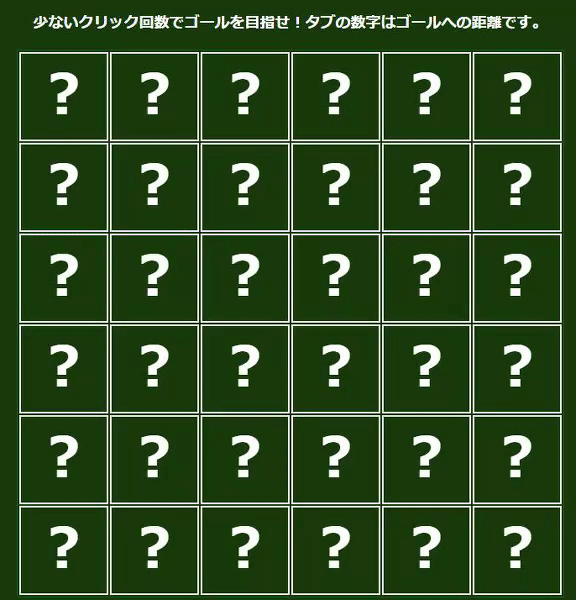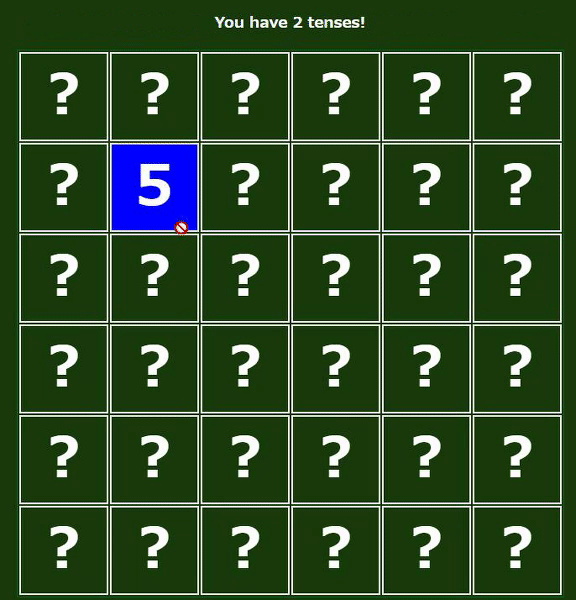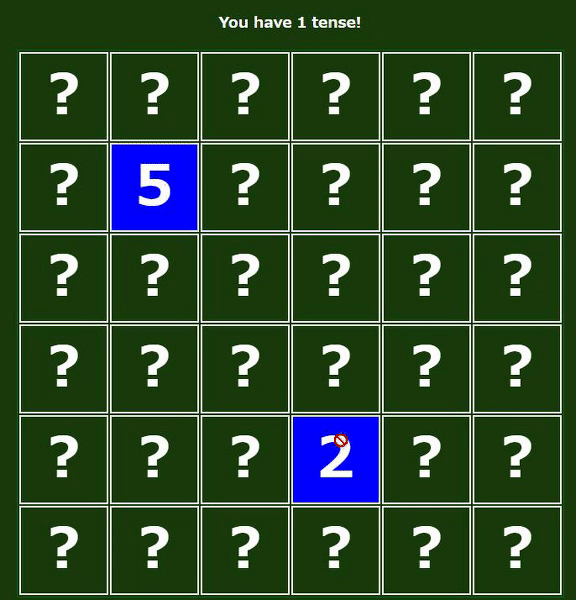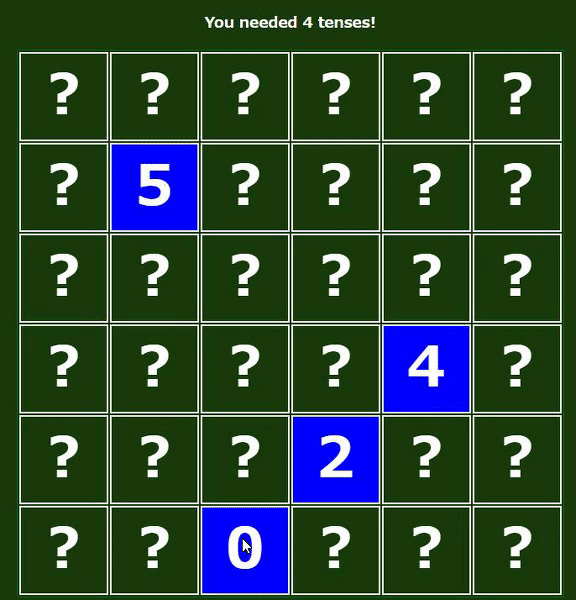
ゲーム:わしが考えた最強のマインスイーパーもどき。(クリックするとゴールまでの距離が出る。)
集計データ:
平均:142
標準偏差SD:45
大丈夫だ。問題ない。
分布:

まあ良さそう。
これは得点(正解までの手数)を25(5~),50(4),100(3),150(2),200(1)を取ります。
分布としてもまあまあ合格点だと思います。
意外と頭使うのと、運要素が大きいかも。
これを機械に探索させると面白そうですね。
実施内容:
何もしません。
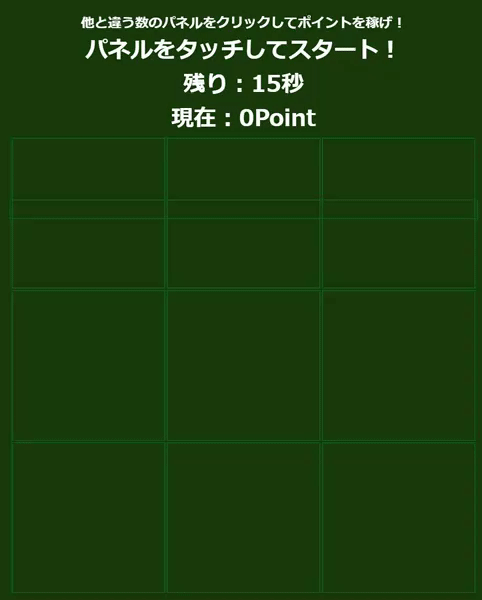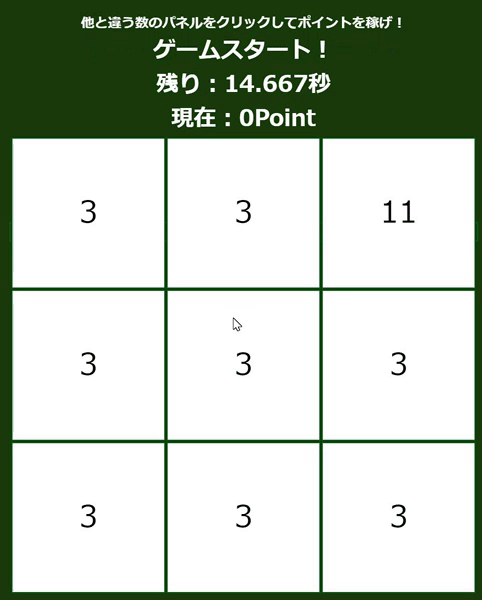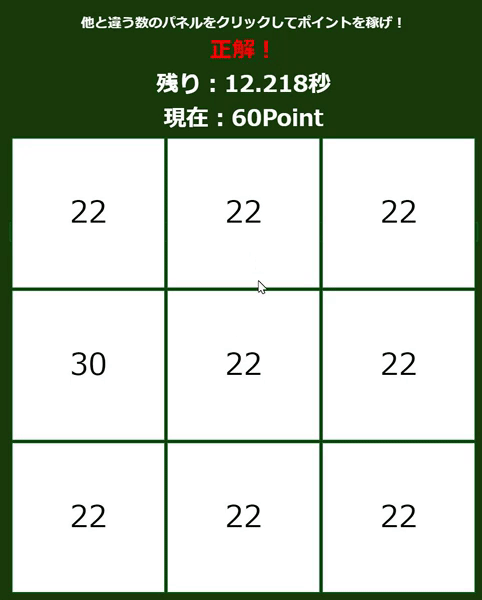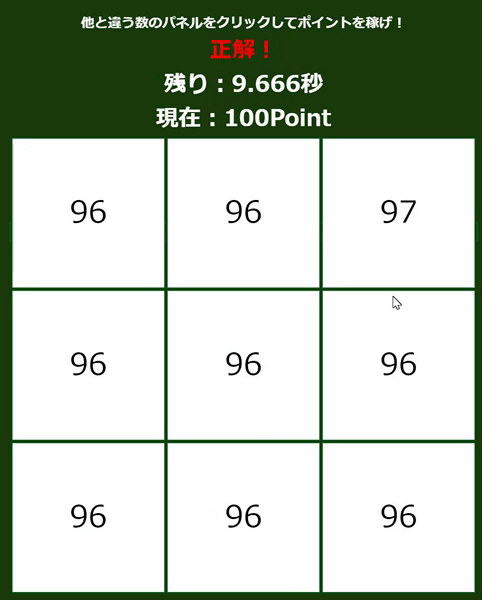
ゲーム:他と違う数のパネルをクリックしていく。
集計データ:
平均:189
標準偏差SD:35
簡単すぎぃ!
分布:
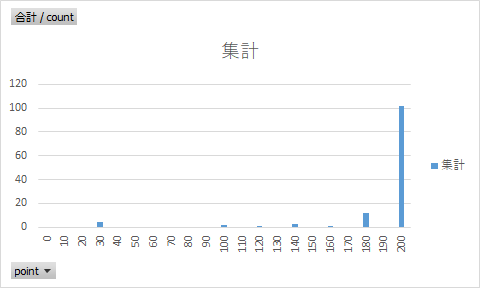
簡単すぎぃ!
ということで、ゲームの基礎情報のおさらい。
ゲーム時間:15s
ポイント:1回正解で20p
・・・たった10回正解すればいいのに、15sもあるの?
game9は0.4sに1回(10s、1回8p)なのでそれと同等にしよう。
(あっちは色判別だけなのに、こっちは文字識別が必要・・・だぞ?)
実施内容:
ゲーム時間:15s→10s
ポイント:20p→10p
ゲーム:反応速度ゲー

集計データ:
平均:112
標準偏差SD:55
ちょっと上方修正必要では・・・
分布:
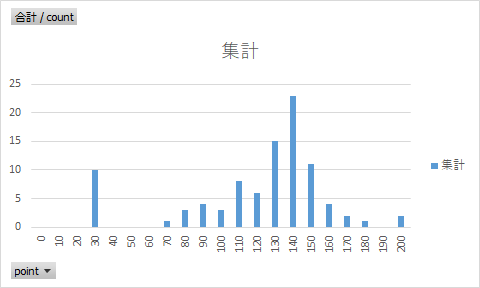
悪くはないけど、ちょっとシビアかなあ。
左裾が伸びている。(だからどうした)
まあミスしてる人も多いのでこんな感じかと。
得点は以下の数式で与えられる。
myGame = (0.8 – Math.abs(myTime)/1000) / 0.7 * 200
反応が0.1s以内なら200点以上・・・って。
いやちょっと待て。人間の限界は0.15sくらいのはず。FPSの上手い人でもその程度だった気がする。
計算すると平均112が反応速度0.40s・・・?
この前提から考えて、式を変更してみる。
myGame = (0.8 – Math.abs(myTime)/1000) / 0.7 * 200
↓
myGame = (0.9 – Math.abs(myTime)/1000) / 0.7 * 200
これでだいたい平均が142になるはず。
実施内容:
(得点の変更)myGame = (0.9 – Math.abs(myTime)/1000) / 0.7 * 200
game1~12までのデータを分析し、練習難易度の不均衡是正を目指しました。
とりあえずこの内容を今日から施行し、1か月後(4/1ごろ)に3/4~4/1のデータを分析したいと思います。
因果関係がわからないランダム要素を入れてしまうと、詳細な分析ができない・・・。
これは新たな発見でした。
もともと問題視していた育成方針の選択数の不均衡。
なぜそれが起こるのかというと・・・、
使えない(と思いやすい)育成方針があるってことなんですよね。
詳しく見ていきましょう。
各方針の能力上昇(2019.02.23)
◎=上昇大、○=上昇小、無印=上昇微小
| 略称 | 速 | 制 | 体 | 変 | ミ | パ | 走 | 肩 | 守 | E避 | 反 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 速・肩 | ◎ | ◎ | |||||||||
| 投球技術 | ◎ | ◎ | |||||||||
| 巧打 | ◎ | ○ | ◎ | ||||||||
| 長打 | ○ | ◎ | ○ | ||||||||
| 走・体 | ○ | ◎ | ◎ | ○ | |||||||
| 守備 | ○ | ○ | ◎ | ◎ | |||||||
| バランス |
投手では、投球技術が圧倒的に有利に見えます。
以前の分析で制球(と変化量)が、防御率・WHIPを下げるためにはとても良いという結果が出ていました。
それがどっちも◎です。
そうなれば速・肩とか選ばないですよね。
投手に関係あるのが◎1つって・・・。
その不均衡がどのような状態にあるのかを調査し、
それをどう軽減できるのか方法を考えます。
対象:すべての選手。ただし、バランス型を無視。
解析方法:SQLでの抽出 → Excel(ピボットテーブル)での分析

巧打と投球技術が多いですね。
この集計には投手、野手が混ざっているので分けて考えます。

やはり投球技術が圧倒しています。
魅力度(比率)では以下の通り。
投球技術(p):70.16908213
速・肩(sp):15.70048309
走・体(st)14.13043478

巧打が圧倒しています。意外と守備が選ばれていますね。
魅力度(比率)では以下の通り。
巧打(mt):50.61728395
守備(df):20.59483726
長打(pw):16.89113356
走・体(st):8.978675645
速・肩(sp):2.918069585
能力値上昇の◎を2、〇を1、無印を0とした場合、
能力値ごとにそれぞれ異なった重み(判断を上昇させる効果)があるのではないか?
ということを考えました。
ちょっと分かり辛いので噛み砕いて、どうぞ・・・。
投手で言うならば、
データから見て、速球上げるより制球上げたほうが良くね?
という考えを拡大解釈したものです。
速・肩は速球1個しか◎ついてないし、制球◎変化量◎がついてる投球技術選ぶよな!
という判断基準を数値に落とし込む考え方ですね。
ゲームやってる以上負けたい人はいないだろうし、あくまで理性的に行動するだろう、ということを前提にしています。
そのため今回は無選択(バランス型)は抜いています。ノイズになりやすいので。
それを踏まえて重回帰分析を行います。
投手成績を重回帰分析を行いました。

・・・いかん。
なぜダメかというと、
X4(変化量)への相関が0のためです。
つまり、投球技術は制球◎変化量増加なしでも、制球◎変化量◎でも選ばれる率は変わらない。
んーだったら、X2とX4の相関は同等とします。
仮定(偏回帰係数):
X1:7.85
X2:17.5
X3:7.05
X4:17.5

こんな感じで調整して、と。
野手も調整しました。

こうすればかなりまともになるのでは?と思います。
Meisyoは、
「どうすれば勝てるのか?」を考えるゲームです。
どうすれば勝てるのか?は育成から始まります。
育成方針の選択肢が少なければ、まったく選択肢はなくなります。
この調整でどの方向でも進めるし、自分が考えた戦略を実現しやすくなった、ということですね。
では!
練習試合のバグ修正を修正しました。
練習試合で大阪桐蔭2018(NPC)と当たるってマジ?
久々のバグ報告(ありがたい!)で、なんでこうなるかなーと思ってみたら、
下記のようにしたつもりが・・・
$vid = null;
if(!$vid){
    // レーティング処理
}
実際こうなってました。
$vid = null;
if($vid){
    // レーティング処理
}
想定:
$vidが選択されていないときにはレーティング処理(練習試合レートによる適正なマッチング)を行う。
現実:
$vidが存在するとき$vidを選択する!!
→そもそも$vidが存在しないからレーティングが発動しない。
→しゃーないから適当に対戦相手選べよ!!
→大阪桐蔭爆誕
悲しいなあ・・・。
レーティングの中身も少々おかしかった。直した。
というわけで、問題なく対戦できます。
これまでなかったレーティング付きで。
ふじなみ様
ご連絡ありがとうございます!画像を確認しましたが、これはバグです。
当該バグを修正いたしました。なお、気持ちだけですが模擬戦チケットを1枚送付しました。
また何かございましたらご連絡ください。
プレイしていただきありがとうございます。
実力不足感が否めませんが、Kaggleのチュートリアル的なTitanicにおいてランダムフォレストで正答率約80%を出せたのでコードを載せておきます。
Colaboratory
実施期間:2019/02/07~02/19
的中率:46%→80%
使用識別器:ロジスティック回帰、ランダムフォレスト、SVM、K-means、カーネルSVM
グリッドサーチ:あり
注意したこと:
・データをよく観察する。
・欠損値はよく考えて埋める。適当に埋めない。
・1つずつ理由を考える。
問題点:
・識別器の違いが判らなかった。(だいたい分かるようになってきた)
・分析のためのコードの書き方がわからなかった。
・名前の分類凝りすぎた感。(+αするなら男の名前と女の名前で列を分けたほうが良かったかも?)
・データ正規化の自作関数、data_normalize()がWarning出てしまう。
・NNとかCNN、LGBなどの優秀な識別器を自作できなかった。理解が足りない。
・ほぼほぼモノマネに終始してしまった。
・上のColaboratory URL完成してない!
・「もし乗客になった場合、死亡確率を下げるにはどうしたらいいの?」という問いに答えられない。
感想:
・時間かかったけど楽しかった。
・KaggleはPythonに慣れるのにはよさそう。
・他の人のコードをもっと読みたい。(カーネル読もね)
・Pythonやデータサイエンスの理解を深めたい。で、仕事で使いたい。
【追記:04/30】
LightGBM、XGBoostをさらに試したところ、84%の精度が出ました。
・・・とは言え、単純な「データ加工→学習→出力」ではチューニングしたランダムフォレストが一番精度高かったです。
2つのBoosting系は、出力後の結果を再度取り込んで学習させるなど、さらなる精度を求めるならよさそうです。(なお、ノンチューニングなので真価は発揮していない)
回答が非常に長い気がするのはなぜだろうか。
/* 自己結合を用いた場合 */
SELECT DISTINCT K1.名義, K1.口座番号,
       K1.種別, K1.残高, K1.更新日
  FROM 口座 AS K1
  JOIN 口座 AS K2
    ON K1.名義 = K2.名義
 WHERE K1.口座番号 <> K2.口座番号
 ORDER BY K1.名義, K1.口座番号;

/* 集計関数と結合を用いた場合 */
SELECT K1.名義, K1.口座番号,
       K1.種別, K1.残高, K1.更新日
  FROM 口座 AS K1
  JOIN (SELECT 名義, COUNT(名義) AS 口座数
          FROM 口座
         GROUP BY 名義
        HAVING COUNT(名義) > 1) AS K2
    ON K1.名義 = K2.名義
 ORDER BY K1.名義, K1.口座番号;
ワイ
SELECT 名義, 口座番号, 種別, 残高, 更新日
  FROM 口座
 WHERE 名義 IN (SELECT 名義
  FROM 口座
 GROUP BY 名義
HAVING COUNT(名義) > 1)
ORDER BY 名義, 口座番号;
自分自身のコードの傾向としては、以下の通り。
1・できるだけ短いコードを目指す。(美しいコードガイイヨネ)
2・「カラムA = A」は1つにしたい派。(同じこと複数書いてると入力間違えそう)
3・テスト問題はさっさと終わらせたい。(実際のデータに触れたいのであった=答えが見えている問題は興味がない?)
異常に奥が深いnumpyで遊びましょう!!
import numpy as np
a = np.arange(int(np.floor(np.random.rand()*1000)))
for i in range(1,len(a)+1):
     if len(a) % i == 0:
             np.reshape(a, (i,-1))
def test(n):
    return sum(range(n))

import timeit
timeit.timeit('test(100)', globals=globals(), number=1000)
amaxとmaxの比較
>>> timeit.timeit('np.amax(a)', globals=globals(), number=1000000)
3.069760522001161
>>> timeit.timeit('np.max(a)', globals=globals(), number=1000000)
3.094179121999332
環境と調子次第で0.3s(10%)くらい変動するのが気になる。
a = np.arange(12).reshape((3, 4))
b = np.reshape(a, (3, 4))
c = b ** 2
np.where(b % 2 == 0, b, c) # bが偶数でないときはcが出てくる
a = np.arange(120).reshape((1,2,3,4,5))
# a.T = a.transpose(4,3,2,1,0)
b = np.arange(120).reshape((2,3,4,5))
# b.T = b.transpose(3,2,1,0)
c = np.arange(24).reshape((2,3,4))
# c.T = c.transpose(2,1,0)
位置関係が逆転する訳だ
import matplotlib.pyplot as plt
x = np.linspace(-50, 50, 100000)
y = np.tan(x)
plt.plot(x, y)
plt.show()

tan()は何かかっこいい
from scipy.special import expit
x = np.linspace(-10, 10, 100000)
y = expit(x)
plt.plot(x, y)
plt.show()
sigmoid 関数は神(神経科学的な意味で)

x = np.random.randint(1000, size = 10000)
y = np.sin(x)
plt.scatter(x, y)
plt.show()

謎の模様・・・なぜだ?自己組織化に関連しているような・・・。
import numpy as np
import matplotlib.pyplot as plt
for i in range(1, 20):
  n = i * 100
  x = np.random.randint(n, size = 10000)
  y = np.sin(x)
  plt.scatter(x, y)
  plt.title("n = " + str(n))
  plt.show()
やばい(ヤバい)
import numpy as np
import matplotlib.pyplot as plt
for i in range(1, 20):
n = i * 100
x = np.random.randint(n, size = 10000)
y = np.sin(x)
plt.scatter(x, y)
plt.title("n = " + str(n))
https://t.co/VN8b2xoiQR() pic.twitter.com/b0vSA0ABzc— R (@R_farms) 2019年2月7日