[Meisyo]第4回公式戦決勝戦

名将と呼ばれた者達、今年最後の第4回公式戦決勝戦がありました。結果をお伝えします。
(ゲームにログインしていれば、こちらから結果を見ることが出来ます)

オモテ:
市立織田高校
チーム総合力:119.5
打撃:D 走塁:E 守備:E
総評:打ち崩せないチーム。それでいて点も取ってくる。
私はココに準決勝4-3で負けました(^o^)

VS

ウラ:
府立理想の高校
チーム総合力:132
打撃:E 走塁:D 守備:E
総評:珍しい走力重視チーム、総合力はトップクラス。第2回大会優勝の強豪。

圧倒的なチーム力の差があるものの勢いのある市立織田高校。
それに対する強豪府立理想の高校。
織田高校の体力が少ないのが気になります。

それでは、試合開始です。

といきなり織田高校が2点先制!

いきなりの2得点。これは・・・

しかし3回裏、理想の高校は反撃を見せる。

ツーベース → 三盗 → ゴロで1点

ただ織田高校、すぐに反撃。
HRで1点!

これは織田高校有利ですね。勢いもあるし。

コレに対して理想の高校はコツコツ点を取る。

ただ、逆転は出来ない・・・。

大量点を与えないところが織田高校の強いところですね。

織田高校、さらに追加点を取る!

5-2!
ん~これは・・・すごい。

6回ウラ、理想の高校はコツコツ点を重ねていく。

5-3
ただ、追いつかない・・・。

そして7回ウラ、理想の高校は逆転のチャンスを掴む。

ノーアウトでランナー3塁。
5-3の2点差であれば十分にひっくり返せる。

ヒットで続く!1点!

5-4
あと1点!

さらに・・・四球。

これはチャンスだ!

次の打者はフライだったもののランナーを次の塁へ進めた。

5-4
2アウト2・2塁
5番岡本

1打逆転のチャンス。
こいつは・・・結果を出せるか?

・・・・!

orz

その回のあとすぐに織田高校が突き放す!

8回でコレは、理想の高校はツラい。

そのあとは、織田高校の投手が強さを見せつける。

ゲームセット!


終始、織田高校が優勢で試合を進めていました。

理想の高校はただ1回のチャンスが生かせなかったですね。
チャンスもなかなか作れなかった・・・。

市立織田高校の6942947295さんおめでとうございます!
熱い戦いをありがとうございました!

[Meisyo]ビッグデータから学ぶ試合の基礎設計4

ここでは、「どのパラメータが打率等にどれくらい関係するのか」を理解することで強いチームを作る指針を記載しておきます。

機械学習(重回帰分析)を使って本気で遊んでます。

実際のデータセットはこちら
野手データ 2018.12.17.csv
投手データ 2018.12.17.csv
*公平を期すために使用したデータセットを公開しています

計:146141打席
多くなりましたね。

結果

野手編
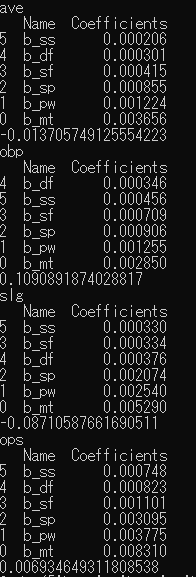
打率(AVE)、出塁率(OBP)、長打率(SLG)、OPS(OPS)
に対し・・・ミート(MT)、パワー(PW)、走力(SP)、肩力(SF)、守備力(DF)、反応速度(SS)が相関しています。

とはいえ、速球投手が全然居ないのでミート王者は変わりそうにありませんが。
昔は速球投手が猛威を奮っており、反応高くないと死ぬゲームでした。

投手編
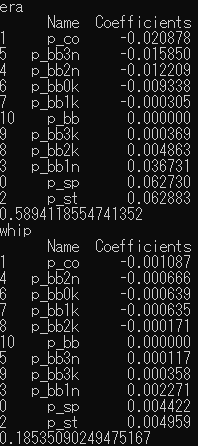
防御率(ERA)、WHIP
に対し・・・コントロールが高ければ高いほど、ERAとWHIPは落ちる傾向。
速球とスタミナがあるとERAとWHIPが上がる・・・だと?

相手投手との相関性を全く考えていないデータなので、水物ではあります。日々変化しそう。
守備もデータ取ってないから説明できないのが悲しいところですね。

詳細分析

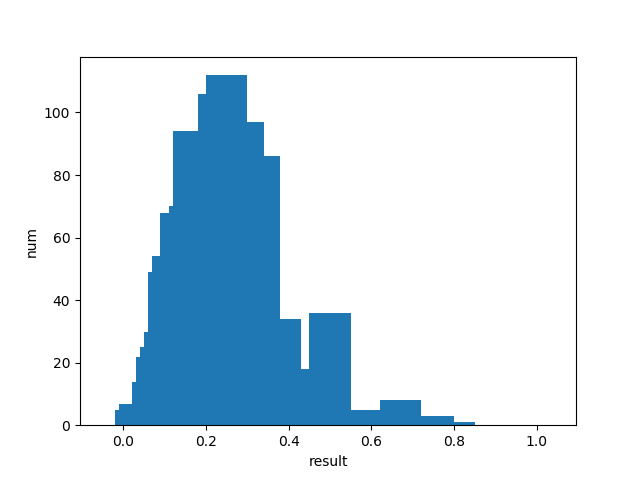
AVE

平均: 0.22
中央値: 0.22
分散: 0.01
標準偏差: 0.12

OPS

平均: 0.63
中央値: 0.64
分散: 0.08
標準偏差: 0.29

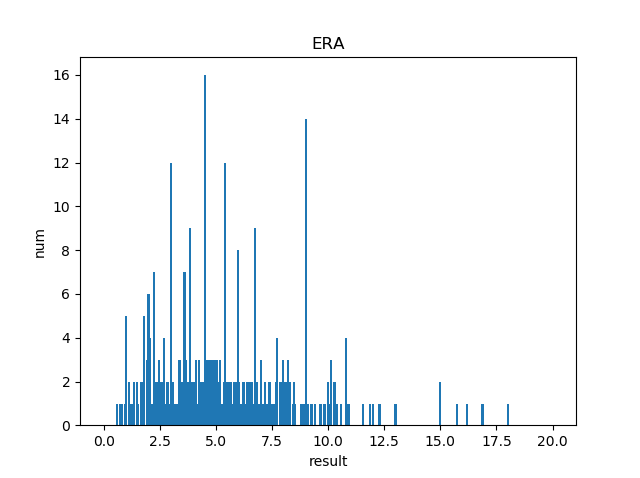
ERA(防御率)

平均: 4.20
中央値: 3.91
分散: 18.28
標準偏差: 4.28
・・・こいつだけエラいばらばらやな?

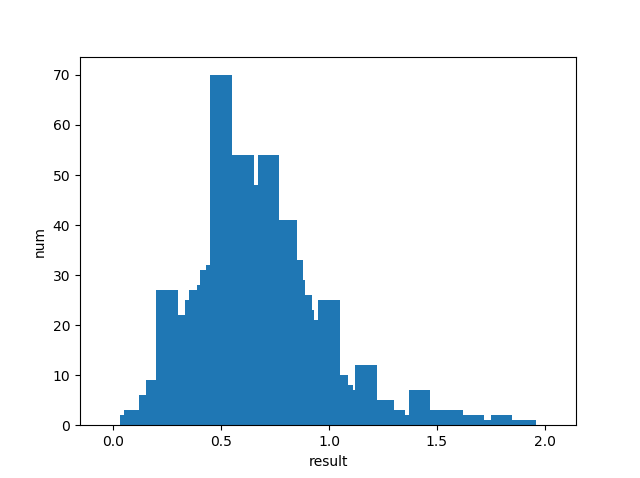
WHIP

平均: 0.46
中央値: 0.50
分散: 0.09
標準偏差: 0.30

※注意:各選手の結果をリスト化して、単純に平均、中央値等を出しているだけなので、投球回数等は反映されていないデータです。ご注意ください。

分析スクリプト

コマンドプロンプトでpython他をインストールしてみてください。
グラフの出力は100行目くらいにある

sys.exit()

をコメントアウトしてくださいませ。

投手用

# -*- coding: utf-8 -*-

import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 基礎設定
file_name = 'meisyo_p 20181217.csv'

# CSV読み込み
df = pd.read_csv(file_name, encoding='utf-8')

# Null値を把握
# print(df.isnull().sum())

# 基礎設定
team = pd.DataFrame(index=[], columns=[])

# 投手能力結合・削除
for i in ['sp', 'co', 'st', 'bb1n', 'bb2n', 'bb3n']:
    df['p_'+i] = df['p_'+i] + df['pt_p_'+i] + df['pw_p_'+i]
    df = df.drop(['pt_p_'+i, 'pw_p_'+i], axis=1)
#for i in ['bb1', 'bb2', 'bb3', 'bb0k', 'bb1k', 'bb2k', 'bb3k']:
#    df = df.drop(['p_'+i], axis=1)

# 野手能力結合・削除
for i in ['mt', 'pw', 'sp', 'sf', 'df', 'er', 'ss']:
    df['b_'+i] = df['b_'+i] + df['pt_b_'+i] + df['pw_b_'+i]
    df = df.drop(['b_'+i, 'pt_b_'+i, 'pw_b_'+i], axis=1)

team = df

# 不必要品削除
df = df.drop(['mn_id', 'name', 'side_p', 'type', 'type_p', 'hp', 'cond', 'cond_b', 'img', 'exp', 'time', 'skill', 'game.1', 'id.1', 'g_bench', 'g_pos', 'g_sb', 'game', 'pc_type', 'bt_type', 'grow_type'], axis=1)

# 欠損値のある行を削除
df = df.dropna()

# 変化球(チェンジアップ=0)ありか
df['p_bb'] = 0
if df['p_bb1'].empty or df['p_bb2'].empty or df['p_bb3'].empty:
    df['p_bb'] = 1

# データセット
df = df.drop(['type_b', 'side_b', 'lv'], axis=1)
df = df.drop(['p_bb1', 'p_bb2', 'p_bb3'], axis=1)

# データ確認
#print(df.isnull().sum())

# 結果データ作成
rs = pd.DataFrame(index=[], columns=[])
rs['id'] = df['id']
rs['era'] = (df['er'] * 9) / (df['ip'] / 3)
rs['whip'] = (df['h'] + df['bb']) / (df['ip'])

# 結果削除(結果に直接相関する)
df = df.drop(['pa', 'ab', 'h', 'risp_b', 'risp_h', '1b', '2b', '3b', 'hr', 'tb', 'sh', 'sf', 'bb', 'hbp', 'so', 'e_er'], axis=1)
df = df.drop(['er', 'r', 'ip', 'wp', 'win', 'lose', 'save', 'cg', 'sho', 'gs'], axis=1)

# データ欠損値の埋め合わせ
rs = rs.fillna(0)

# データ設定
x_col = df.drop('id', axis=1)
x = x_col.values
y_era = rs.values[:, 1]
y_whip = rs.values[:, 2]

#必要なパッケージのインポート
from sklearn import linear_model
model_era = linear_model.LinearRegression()
model_whip = linear_model.LinearRegression()

# 学習する
model_era.fit(x, y_era)
model_whip.fit(x, y_whip)

# 偏回帰係数
print("era")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_era.coef_}).sort_values(by='Coefficients') )
print(model_era.intercept_)

print("whip")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_whip.coef_}).sort_values(by='Coefficients') )
print(model_whip.intercept_)

# 相関
myteam = {}
for key, row in team.iterrows():
    if row['mn_id'] == 'れい' and row['type'] == 'P':
        sum = 0
        for i in x_col.columns:
            if i is not 'p_bb':
                sum += row[i]
        myteam[row['name']] = '{:.0f}'.format(sum);

for k, v in sorted(myteam.items(), key=lambda x: x[1]):
    print(str(k) + ": " + str(v))

# stop
sys.exit()

# グラフ用
y_eraV = ['{:.2f}'.format(n) for n in y_era]
y_whipV = ['{:.2f}'.format(n) for n in y_whip]

# plot
data = y_whipV

import collections
list = collections.Counter(data)
x = np.arange(200) / 100
values = []
for i in x:
    i = '{:.2f}'.format(i)
    print(str(i) + ":" + str(list[i]))
    if list[i]:
        values.append(list[i])
    else:
        values.append(0)
values[0]=0 # 0を無視

# 計算
from statistics import mean, median,variance,stdev
print(data)
data = [float(s) for s in data]
m = mean(data)
median = median(data)
variance = variance(data)
stdev = stdev(data)
print('平均: {0:.2f}'.format(m))
print('中央値: {0:.2f}'.format(median))
print('分散: {0:.2f}'.format(variance))
print('標準偏差: {0:.2f}'.format(stdev))

plt.bar(x, values, width=0.1)
plt.xlabel("result")
plt.ylabel("num")
plt.show()

野手用

# -*- coding: utf-8 -*-

import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 基礎設定
file_name = 'meisyo_b 20181217.csv'

# CSV読み込み
df = pd.read_csv(file_name, encoding='utf-8')

# Null値を把握
# print(df.isnull().sum())

# 基礎設定
team = pd.DataFrame(index=[], columns=[])

# 投手能力結合・削除
for i in ['sp', 'co', 'st', 'bb1n', 'bb2n', 'bb3n']:
#    df['p_'+i] = df['p_'+i] + df['pt_p_'+i] + df['pw_p_'+i]
    df = df.drop(['pt_p_'+i, 'pw_p_'+i], axis=1)
for i in ['bb1', 'bb2', 'bb3', 'bb0k', 'bb1k', 'bb2k', 'bb3k']:
    df = df.drop(['p_'+i], axis=1)

# 野手能力結合・削除
for i in ['mt', 'pw', 'sp', 'sf', 'df', 'er', 'ss']:
    df['b_'+i] = df['b_'+i] + df['pt_b_'+i] + df['pw_b_'+i]
#    df = df.drop(['b_'+i, 'pt_b_'+i, 'pw_b_'+i], axis=1)

team = df

# 不必要品削除
df = df.drop(['mn_id', 'name', 'side_p', 'type', 'type_p', 'hp', 'cond', 'cond_b', 'img', 'exp', 'time', 'skill', 'game.1', 'id.1', 'g_bench', 'g_pos', 'g_sb', 'game', 'pc_type', 'bt_type', 'grow_type'], axis=1)

# 欠損値のある行を削除
df = df.dropna()

# 不必要分削除
df = df.drop(['type_b', 'side_b', 'lv'], axis=1)
df = df.drop(['b_er'], axis=1)

# データ確認
#print(df.isnull().sum())

# 結果データ作成
rs = pd.DataFrame(index=[], columns=[])
rs['id'] = df['id']
rs['ave'] = df['h'] / df['ab']
rs['obp'] = (df['h'] + df['bb'] + df['hbp']) / (df['ab'] + df['bb'] + df['hbp'] + df['sf'])
rs['slg'] = df['tb'] / df['ab']
rs['ops'] = rs['obp'] + rs['slg']

# 野手結果削除(結果に直接相関する)
df = df.drop(['pa', 'ab', 'h', 'risp_b', 'risp_h', '1b', '2b', '3b', 'hr', 'tb', 'rbi', 'rs', 'sh', 'sf', 'bb', 'hbp', 'so', 'dp', 'e_er', 'tc', 'm_er', 'sb', 'cb', 'c_sb', 'c_cs'], axis=1)

# データ欠損値の埋め合わせ
rs = rs.fillna(0)

# データ設定
x_col = df.drop('id', axis=1)
x = x_col.values
y_ave = rs.values[:, 1]
y_obp = rs.values[:, 2]
y_slg = rs.values[:, 3]
y_ops = rs.values[:, 4]

print(df.isnull().any())
print(rs.isnull().any())

#必要なパッケージのインポート
from sklearn import linear_model
model_ave = linear_model.LinearRegression()
model_obp = linear_model.LinearRegression()
model_slg = linear_model.LinearRegression()
model_ops = linear_model.LinearRegression()

# 学習する
model_ave.fit(x, y_ave)
model_obp.fit(x, y_obp)
model_slg.fit(x, y_slg)
model_ops.fit(x, y_ops)

# 偏回帰係数
print("ave")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_ave.coef_}).sort_values(by='Coefficients') )
print(model_ave.intercept_)

print("obp")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_obp.coef_}).sort_values(by='Coefficients') )
print(model_obp.intercept_)

print("slg")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_slg.coef_}).sort_values(by='Coefficients') )
print(model_slg.intercept_)

print("ops")
print(pd.DataFrame({"Name":x_col.columns, "Coefficients":model_ops.coef_}).sort_values(by='Coefficients') )
print(model_ops.intercept_)

# 結果表示
print(x_col.columns)
print(model_ops.coef_)

# 相関図
myteam = {}
for key, row in team.iterrows():
    if row['mn_id'] == 'れい' and row['type'] == 'B':
        sum = 0
        for i in x_col.columns:
            sum += row[i]
        myteam[row['name']] = '{:.0f}'.format(sum);

for k, v in sorted(myteam.items(), key=lambda x: x[1]):
    print(str(k) + ": " + str(v))

# stop
sys.exit()

# グラフ用
y_aveV = ['{:.2f}'.format(n) for n in y_ave]
y_obpV = ['{:.2f}'.format(n) for n in y_obp]
y_slgV = ['{:.2f}'.format(n) for n in y_slg]
y_opsV = ['{:.2f}'.format(n) for n in y_ops]

# plot
data = y_aveV

import collections
list = collections.Counter(data)
x = np.arange(100) / 100
values = []
for i in x:
    i = '{:.2f}'.format(i)
    print(str(i) + ":" + str(list[i]))
    if list[i]:
        values.append(list[i])
    else:
        values.append(0)
values[0]=0 # 0を無視

# 計算
from statistics import mean, median,variance,stdev
print(data)
data = [float(s) for s in data]
m = mean(data)
median = median(data)
variance = variance(data)
stdev = stdev(data)
print('平均: {0:.2f}'.format(m))
print('中央値: {0:.2f}'.format(median))
print('分散: {0:.2f}'.format(variance))
print('標準偏差: {0:.2f}'.format(stdev))

plt.bar(x, values, width=0.1)
plt.xlabel("result")
plt.ylabel("num")
plt.show()

手書き数字診断士(機械学習)ver 0.1 K近傍法を使ってみた

手書き文字の判定精度が全然上がらないので、他の手法を試してみました。

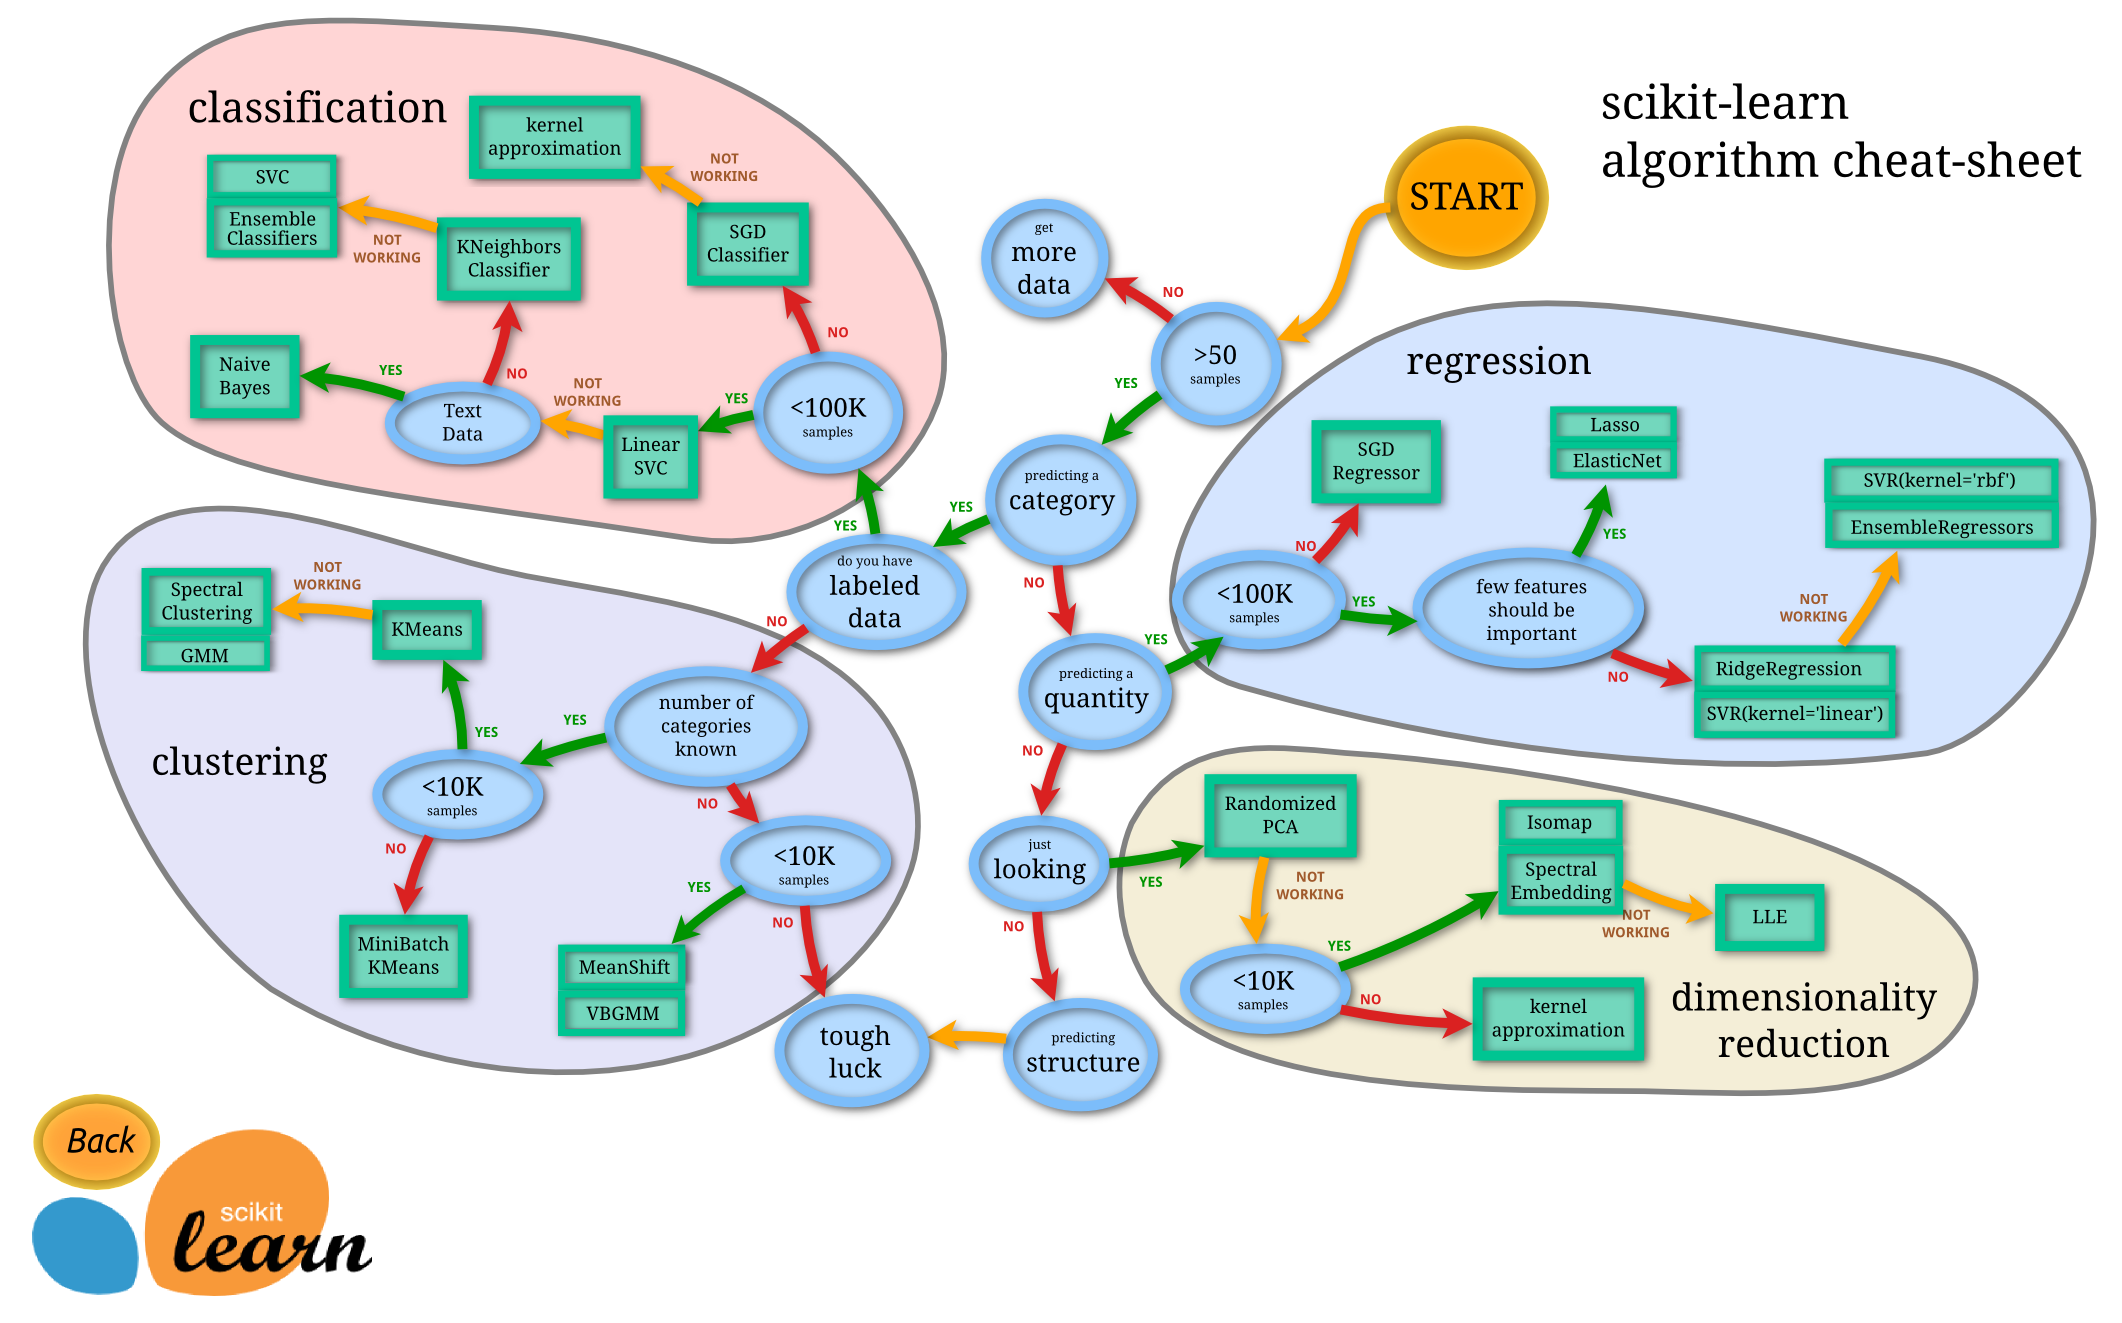
sklearnの開発元によると、以下の方法が良いらしい・・・。

なるほど!SVCで上手くいかない → K近傍法だな!

早速実装
predict.py

from sklearn import datasets
from sklearn import metrics
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import train_test_split
import numpy as np
from sklearn.externals import joblib

# データセットロード
dataset = datasets.load_digits()
#全データの最大値、全データ数確認
#print(np.amax(dataset.data)) # 最大値16
print(dataset.data.shape[0]) # 全データ数

# 設定用
x = dataset.data / 16 # 最大値を1にする
y = dataset.target

# 訓練データ/テストデータの分割
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.1, random_state=1)

# モデル作成
model = KNeighborsClassifier(n_neighbors=10)

# 学習
model.fit(x_train, y_train)

# 推定
y_pred = model.predict(x_test)

# 評価
score = metrics.accuracy_score(y_test, y_pred)
print("KN Score : {0:.4f}" . format(score))

# 間違い探し
co_mat = metrics.confusion_matrix(y_test, y_pred)
print(co_mat)

# 学習済みモデルの作成
joblib.dump(model, "consultant.pkl", compress=True)

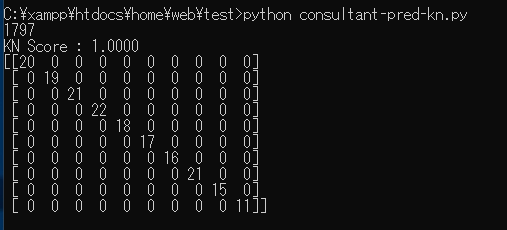
sklearn上では・・・精度100%?
すごくいい数字です。ちなみにSVCは0.98程度でした。

結果

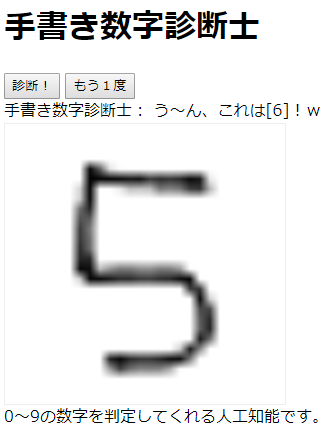
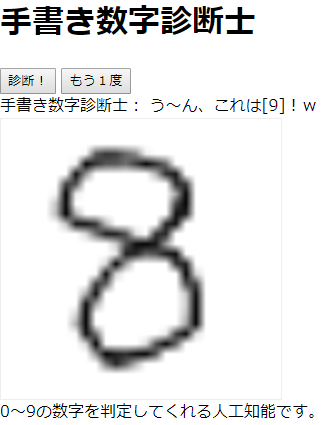
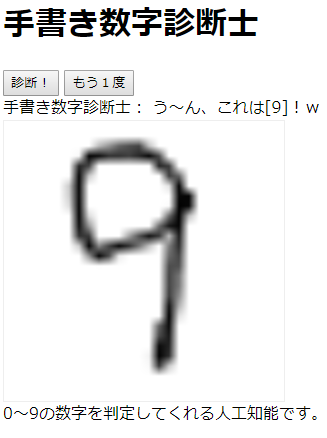
✕
○
○
✕
○
✕
○
✕
✕
○

結果まとめ

正答率:5/10

・・・(^o^;)
正答率は良くはなりましたが、まだまだ未完成みたいですね。

データ整形のサイズを56×56→8×8にする時に、
mean(平均値)で丸めちゃってるのがおかしいのかな・・・。

つづく、はず。

手書き数字診断士(機械学習)ver 0.0

手書き数字診断士、まずは動くようにしました。

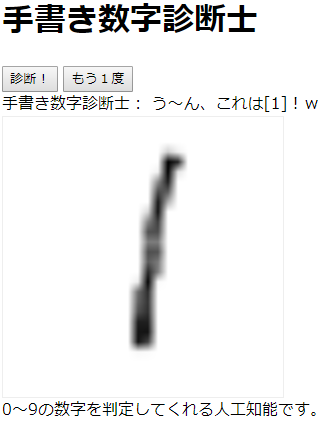
ただ、初っ端から間違えています・・・!

動画

作り方

データ通信方法

canvas → 画像データ化 → JavaScript(Json化)→ POSTで送信 → python、postの[data]のみ受信 → データ整形 → 予測 → 結果表示

使うファイル

pythonのflaskを使いました。
・consultant-app.py 本体
・consultant-pred.py 学習モデル生成用
・consultant.pkl 学習モデル
/template
・index.html 表示、データ通信用
・message.html 判定用

問題点

・判定能力が甘い
 MNISTだから割とデータが整っている=数字の中心がずれたら判定できない

 ・・・その結果ほぼ4に!

・pythonのPostで何でもデータ受け取っている。
 セキュリティがザル。公開するには攻撃対策が必要だろう。

・データ整形に不安感
 JavaScript(Json化)→ POSTで送信 → python、postの[data]のみ受信
 この間で、28×28のデータを送っているはずが・・・56×56に?
 無理やり整形していますが、これでいいのか。

コード

consultant-app.py

from flask import Flask, render_template, request, flash
from wtforms import Form, FloatField, SubmitField, validators, ValidationError
import numpy as np
from sklearn.externals import joblib
import json

# 学習済みモデルを読み込み
def predict(parameters):
    model = joblib.load('./consultant.pkl')
    params = parameters.reshape(1,-1)
    pred = model.predict(params)
    return pred

app = Flask(__name__)
app.config.from_object(__name__)
app.config['SECRET_KEY'] = 'zJe09C5c3tMf5FnNL09C5d6SAzZoY'

@app.route('/', methods = ['GET', 'POST'])
def index():
    return render_template('index.html')

@app.route('/message', methods = ['GET', 'POST'])
def message():
    if request.method == 'POST':
        # フォームの取得、辞書化
        form = request.form
        data = json.loads(form['data'])
        dict = data['data']
        # 辞書→np配列化
        array = np.array(list(dict.values()))
        # 28x28の多次元配列化 なぜかarray[3::4]で出力?
        array_ex = np.reshape(array[3::4], (28, 28))
        #print(*array_ex, sep='\n')
        # 28x28 → 対応する8x8へ(meanで補正)
        d = 8
        z = 28
        array_last = np.zeros((d, d))
        n = int(z / d)
        y = x = int(0)
        for y in range(d):
            for x in range(d):
                yb = n * y
                yf = n * y + n
                xb = n * x
                xf = n * x + n
                data = np.mean(array_ex[yb:yf, xb:xf])
                #print(str(y) + ':' + str(x));
                #print('?' + str(yb) + '-' + str(yf) + 'x' + str(xb) + '-' + str(xf) + ':' + str(data))
                array_last[y,x] = data
        array_last = array_last / np.amax(array_last) # 補正
        pred = predict(array_last)
        print(array_last)
    else:
        pred = 'None'

    return render_template('message.html', pred=pred)

if __name__ == "__main__":
    app.run()

index.html

<html>
<head>
<meta charset='utf-8'>
<title>手書き数字診断士「う~ん、これは0!w」</title>
</head>
<body>
<h1>手書き数字診断士</h1>
<input type=button id='button' onclick="push();" value="診断!" disabled>
<input type=button onclick="delete_canvas();" value="もう1度"><br />
手書き数字診断士:<span id="comment">「」</span><br />
<canvas id="canvas" name="canvas" width="28" height="28" style="width: 280px; height: 280px; border: 1px solid #eee;"></canvas><br />
0~9の数字を判定してくれる人工知能です。
<script type="text/javascript">
<!--
	var drawing = false;
	// 前回の座標を記録する(初期値:0)
	var before_x = 0;
	var before_y = 0;

	var canvas = document.getElementById('canvas');
	var ctx = canvas.getContext('2d');

	canvas.addEventListener('mousemove', draw_canvas);
	// マウスをクリックしてる時
	canvas.addEventListener('mousedown', function(e) {
		drawing = true;
		var rect = e.target.getBoundingClientRect();
		before_x = e.clientX - rect.left;
		before_y = e.clientY - rect.top;
	});
	// マウスをクリックしてない時
	canvas.addEventListener('mouseup', function() {
		drawing = false;
	});

// 描画の処理
function draw_canvas(e) {
	// drawingがtrueじゃなかったら返す
	if (!drawing){
		return
	};
	var rect = e.target.getBoundingClientRect();
	var x = e.clientX - rect.left;
	var y = e.clientY - rect.top;

	// 描画
	ctx.lineCap = 'round';
  ctx.strokeStyle = 'black';
	ctx.lineWidth = 1;
	ctx.beginPath();
	ctx.moveTo(before_x/10, before_y/10);
	ctx.lineTo(x/10, y/10);
	ctx.stroke();
	ctx.closePath();
	// 描画最後の座標を前回の座標に代入する
	before_x = x;
	before_y = y;

	// ボタン使用可能
	document.getElementById('button').disabled = false;
}

// canvas内削除
function delete_canvas() {
	ctx.clearRect(0, 0, 28, 28);
	// ボタン使用不可
	document.getElementById('button').disabled = true;
	document.getElementById('comment').innerHTML = '「」';
}

// 出力
function push() {
	var imgData = ctx.getImageData(0, 0, 28, 28);
	var Data = JSON.stringify(imgData, null);
	var xhr = new XMLHttpRequest();
	xhr.open('POST', '/message');
	xhr.setRequestHeader('content-type', 'application/x-www-form-urlencoded;charset=UTF-8');
	xhr.send('data=' + Data);
	xhr.onreadystatechange = function() {
		if(xhr.readyState === 4 && xhr.status === 200) {
			document.getElementById('comment').innerHTML = xhr.responseText;
		}
	}
}
//-->
</script>
</body>
</html>

message.html

{% if pred == 'None' %}
お客さんデータが無いアルよ
{% else %}
う~ん、これは{{ pred }}!w
{% endif %}

consultant-pred.py
MNISTの学習モデルを保存し、テストする

まとめ

やってることは至って簡単です。
ただ少し気になることが多いですね。

[python]MNISTの学習モデルを保存し、テストする

機械学習のHello World的なMNISTにて、学習モデルを保存し、実行する際のメモ。

用意するもの

PC
コマンドプロンプト
インストール(python、sklearn、numpy)

学習時のコード

from sklearn import datasets
from sklearn import metrics
from sklearn import svm
from sklearn.model_selection import train_test_split
import numpy as np
from sklearn.externals import joblib

# データセットロード
dataset = datasets.load_digits()
#全データの最大値、全データ数確認
#print(np.amax(dataset.data)) # 最大値16
#print(dataset.data.shape[0]) # 全データ数

# 設定用
x = dataset.data / 16 # 最大値を1にする
y = dataset.target

# 訓練データ/テストデータの分割
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=1)

# モデル作成
model = svm.LinearSVC() # SVC

# 学習
model.fit(x_train, y_train)

# 推定
y_pred = model.predict(x_test)

# 評価
score = metrics.accuracy_score(y_test, y_pred)
print("SVC Score : {0:.4f}" . format(score))

# 間違い探し
co_mat = metrics.confusion_matrix(y_test, y_pred)
print(co_mat)

# 学習済みモデルの作成
joblib.dump(model, "test.pkl", compress=True)

呼び出し時のコード

from sklearn.externals import joblib

def predict(parameters):
    model = joblib.load('./test.pkl')
    params = parameters.reshape(1,-1)
    pred = model.predict(params)
    return pred

pred = predict(x) # xは入力値、未設定のためエラー出ます(28x28)
print(pred) # 結果出力

他のモデルを使う場合

「学習時のコード」の3行目と22行目を変更してください。

from sklearn import svm
model = svm.LinearSVC() # SVC

これをSVC以外の・・・分類に突っ込んであげましょう。
ロジスティック などですね。
k-meansは教師なしなので使い方が違います。

回帰(数値分類)ではできないので注意してください。

まとめ

意外と簡単に学習→モデル保存→出力できました。
慣れてない人は、コードに慣れてくるまでは写経ですね。

・・・とはいえ私も、「学習時のコード」のdatasetの最大値を出すだけで15分かかりました…。

手書き数字診断士(機械学習)を作り始めました

Python(Flask)+機械学習の勉強がてら、「手書き数字診断士」を作っています。

元ネタは2chの中小企業診断士です。
「う~ん、これは中小企業!w」

やること

1・index.html
 1. canvasに手書きで文字を書けるようにする(280×280)
 2. canvasを送信できる
 3. save.htmlで保存した間違いを殿堂入りとして表示
2・result.html
 1. canvasのデータを画像で受け取って配列データ化(280×280)
 2. MNISTの28×28に変換(Max-Pooling?)
 3. 判断→「う~ん、これは0!w」
 4. 正解かどうかチェックしてもらう or 間違えたら正解と名前を保存(save.htmlへ)
3・save.html
 1. 間違えた画像データを保管。

2’・機械学習
 1. mnistを使って予め学習。(何個かモデルを用意しとく)

できたこと

1-1まで終わった。
コード詳細は下記「現在のコード」にて。

できていないこと

1-2 canvasを送信できる、が厄介。
・canvasを画像データにすること
・Flaskでのformのやり取りが不明(wtformとは)
 → 使わなければいいじゃん・・・

解決策たち

他の人のコード見て動かすしかないですね。
・https://deep-ize.jp/hcr/
・https://icondecotter.jp/blog/2013/01/31/canvas-todataurl%E3%83%A1%E3%82%BD%E3%83%83%E3%83%89%E3%82%92%E4%BD%BF%E3%81%86/
・https://qiita.com/0829/items/a8c98c8f53b2e821ac94
・https://www.google.co.jp/search?q=canvas.toDataURL()&oq=canvas.toDataURL()&aqs=chrome..69i57j69i61&sourceid=chrome&ie=UTF-8

現在のコード

<html>
<head>
<meta charset='utf-8'>
<title>手書き数字診断士「う~ん、これは0!w」</title>
</head>
<body>
<h1>手書き数字診断士</h1>
<form method="POST">
<input type=submit value="診断!"><br />
<a href="./test.html">もう一度行う</a><br />
<input type=hidden name=text value="10">
<p id="comment">「・・・」</p>
<canvas id="canvas" name="canvas" width="280" height="280" style="border: 1px solid #eee;"></canvas><br>
</form>
<script type="text/javascript">
<!--
  // https://kigiroku.com/frontend/canvas_draw.html
	var drawing = false;
	// 前回の座標を記録する(初期値:0)
	var before_x = 0;
	var before_y = 0;

	var canvas = document.getElementById('canvas');
	var ctx = canvas.getContext('2d');

	canvas.addEventListener('mousemove', draw_canvas);
	// マウスをクリックしてる時
	canvas.addEventListener('mousedown', function(e) {
		drawing = true;
		var rect = e.target.getBoundingClientRect();
		before_x = e.clientX - rect.left;
		before_y = e.clientY - rect.top;
	});
	// マウスをクリックしてない時
	canvas.addEventListener('mouseup', function() {
		drawing = false;
	});

// 描画の処理
function draw_canvas(e) {
	// drawingがtrueじゃなかったら返す
	if (!drawing){
		return
	};
	var rect = e.target.getBoundingClientRect();
	var x = e.clientX - rect.left;
	var y = e.clientY - rect.top;

	// 描画
	ctx.lineCap = 'round';
  ctx.strokeStyle = 'black';
	ctx.lineWidth = 10;
	ctx.beginPath();
	ctx.moveTo(before_x, before_y);
	ctx.lineTo(x, y);
	ctx.stroke();
	ctx.closePath();
	// 描画最後の座標を前回の座標に代入する
	before_x = x;
	before_y = y;
}
//-->
</script>
</body>
</html>

[Meisyo]第3回公式戦決勝戦

本日、Meisyoの第3回公式戦決勝戦がありました。

ダークホースの「sagasitamitaina」高校、悲運の帝王ジャガ畑高校。

チーム総合力を比較してみましょう

国立sagasitamitaina高校
チーム総合力:104
打撃:F 走塁:E 守備:E

VS

私立ジャガ畑高校
チーム総合力:132.25
打撃:D 走塁:E 守備:D

oh…ジャガ畑が強すぎる…

これは、下馬評はジャガ畑圧倒的有利ですね。

3回裏、ジャガ畑高校3番宮崎がチャンスを活かす。

1点先制!

さらに4番が!

畳み掛けれない!

しかし、sagasitamitaina高校、5回表にワンチャンスで逆転!

・・・おっと・・・ジャガ畑高校。強い・・・。


そのウラにすかさず逆転。

ダメ押し・・・か?

まだ追いすがる!

しかし、ここまで。

私立ジャガ畑高校さん(監督:potatoさん)おめでとうございます!

参加していただいた方、ありがとうございました!

私個人としては、、、今度こそ準決勝に行きたい。

【初心者向け】mysqlclientのインストールで詰まったときの補足

コマンドラインでmysqlを使いたい!と思ったら、思わぬ罠がありましたので紹介します。

*僕の場合はpythonで使いたい!というものでしたが、他でも使えることを確認しています。

まずコマンドラインで下記コマンドを入力。
コレが通れば成功です。

pip install mysqlclient

(例:PythonでMySQLに接続する方法【初心者向け】)

これでできるよ!!

と言いたいところでしたが・・・、できないんだな、これが。

思わぬエラー

error: Microsoft Visual C++ 14.0 is required. Get it with "Microsoft Visual C++ Build Tools": http://landinghub.visualstudio.com
/visual-cpp-build-tools

うむ・・・。
調べても全然記事がないぞ。

というより、C++でのエラーがほぼ記事がない。

私は探し当てました。
mysqlclientをインストールできないときの対処法

ちなみにコレのStep4にてdownloadに移動した後、

dir

で、ダウンロードしたファイル名をコピペして、下記<package_name>に入れてください。

pip install <package_name>

を実行する。

これで終わり。・・・のはずですが、引っかかった方は教えてください。

TensorFlow RNNで詰まるの巻

DeeplearningのフレームワークTensorFlowの学習まで漕ぎ着けました。
CNN(画像認識用と言っても過言ではない)はゼロから始めるディープラーニングでだいたいOK。
何度か読み返してわりとなんとか・・・。

実装面がちょっと困る。

なぜなら、数列の扱いに慣れていないからだろう。
行列の変形や逆行列の導出にちょっと詰まるくらいだが、スラスラ理解できるようにならねば・・・。

RNN(自然言語処理等の時系列把握)が詰まった。

なぜなら「突然の数式全開」

とりあえずまずは写経して、もう1度読む時に日本語訳しよう。

プログラミングはまず書くことが大事だと思います。割とマジで。

写経前「?????」
↓
写経後「?????動いた!面白いけど謎」
↓
読解中「あ!これやったやつやん~こういう理解でいいんか」
↓
読解後「だいたいわかる!!」

出来ないって思ったら負けなんですよね。自分に負ける。それがだいたいの失敗理由だ。

(失敗作)愚痴のプラットフォーム アゴニア(αγωνία)


Photo by Alex Iby on Unsplash

今日とりあえず作ってみたけど面白くなかったのを紹介。

コンセプト:
 匿名で後ろ向きに愚痴を吐き捨てる場所が欲しい

なぜか?:
どんどん実名化が進んで行って息(生き)苦しくない?
とりあえず匿名で愚痴を投げ捨てられる場所がほしい。
他の人もこれだけ悩んでるんだなーへー(自分だけじゃない安心!)っていう所があればいいかな。

競合はあるか?:
アプリならある。でも他の人の愚痴は見れない。

アゴニア(αγωνία)の意味:苦悩(ギリシャ語)

なぜやめたか:
動機が後ろ向き過ぎて作るのがしんどくなった。

アイデアはご自由にお使いください(‘A`)
欲しい人居れば作ります。