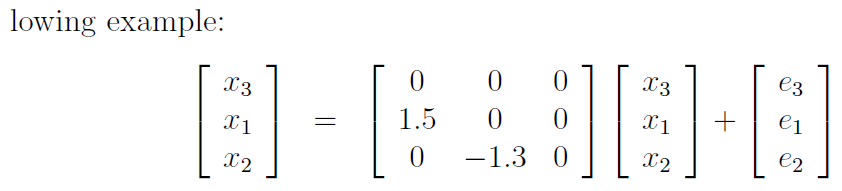[Python] PDFファイルから文字抽出

「大量にPDFファイルがあり、そこから文字を抽出したい。」
そんなお悩みにPython(プログラム言語)でお答えします!

まずは、PDFの種類を確認し、それぞれに対応コードを例示します。

* 今回、構造化データは英語文書のみを対象としていますのでご注意ください。
* 構造化データを日本語対応にしたい場合は「pdfminer.six」モジュールの利用をお勧めします。

対応したいファイル
・パスワード付きのファイル
・その他読み込みが難しいファイル

Twitter:R@へDMいただけると助かります!

想定読者

・Pythonを使ったことがある人
・プログラム言語を書いても良いなと思う人

プログラムは意外と簡単なので、Anaconda Navigatorを使えるようにしてみてください。
下記のコードは、お手持ちのパソコンで全て実行可能です。スペックは不問です!

PDFファイルの種類

  1. 構造化データ
  2. 「文字がどこに配置されているか」が明確に決まっているPDFファイル。

  3. 非構造化データ
  4. 「文字がどこに配置されているか」が明確に決まっていないPDFファイル。画像を埋め込んだものが主。

1. 構造化データ

構造化データは、処理する方法が決まっています。

コマンドラインでPyPDF2のインストール

pip install PyPDF2

Jupyter NotebookまたはPython上でPython関数の定義

import PyPDF2
# 構造化データ読み込み
def open_pdf_text(file_name):
    text = ''
    with open(file_name, "rb") as f:
        reader = PyPDF2.PdfFileReader(f)
        for page_no in range(reader.numPages):
            page = reader.getPage(page_no)
            if page.extractText():
                text += page.extractText()
    return text

下記コードの実行

file_set = "PDFs/構造化データ.pdf"
open_pdf_text(file_set)

構造化データの場合、open_pdf_text関数からfile内の文字データが出力されます。
そうでない場合、空の出力(または改行のみ)が行われます。そのため、2番の非構造化データ抽出を行いましょう。

2. 非構造化データ

非構造化データの場合、画像として読み込んだ方が手っ取り早いです。
以降はPDFを画像化し、OCR(光学文字認識)で読み込む方法です。

TesseractとPyOCRのインストール

OCRをあなたのパソコン上で使うために、インストールを行います。
詳細はPythonでOCRを実行する方法のうち、TesseractのインストールとPyOCRのインストールをご覧ください。

PDFを画像化し、画像をOCRで読み込むPython関数の定義

PDFを画像化した際に保存しておくフォルダを「Image」とします。なければ作ってください。

import pathlib, pdf2image, glob, os, pyocr, PIL

# poppler/binを環境変数PATHに追加する
poppler_dir = os.path.join(pathlib.Path().resolve(), "src/poppler/bin")
os.environ["PATH"] += os.pathsep + str(poppler_dir)

# 画像読み込み
def open_pdf_image(file_name):
    ## pdfから画像化
    img_dir = pathlib.Path('Images')
    # 存在する画像ファイルを削除
    for p in glob.glob(os.path.join(img_dir, "*.png")):
        if os.path.isfile(p):
            os.remove(p)
    # 画像ファイル抽出
    images = pdf2image.convert_from_path(file_name, grayscale=True, size=1800)
    for index, image in enumerate(images):
        image.save(img_dir/pathlib.Path('{}.png'.format(index + 1)), 'png')
        
    ## 画像を加工したい場合はこちらに記述する

    ## ocr読み込み
    tools = pyocr.get_available_tools()
    tool = tools[0]
    builder = pyocr.builders.TextBuilder(tesseract_layout=6) # 1~6まで存在する
    # テキスト抽出
    text = ''
    for p in glob.glob(os.path.join(img_dir, "*.png")):
        if os.path.isfile(p):
            img = PIL.Image.open(p)
            text += tool.image_to_string(img, builder=builder)
    return text

エラーが出る場合は、上記と同じようにpipでインストールしてください。

実行は上記と同じように行います。

file_set = "PDFs/非構造化データ.pdf"
open_pdf_image(file_set)

画像を加工する方法

特定部分以外の文字が必要がない場合は、画像のトリミングを行います。
たとえば、下記のようなPDFの場合、赤枠内の文字しか使いません。
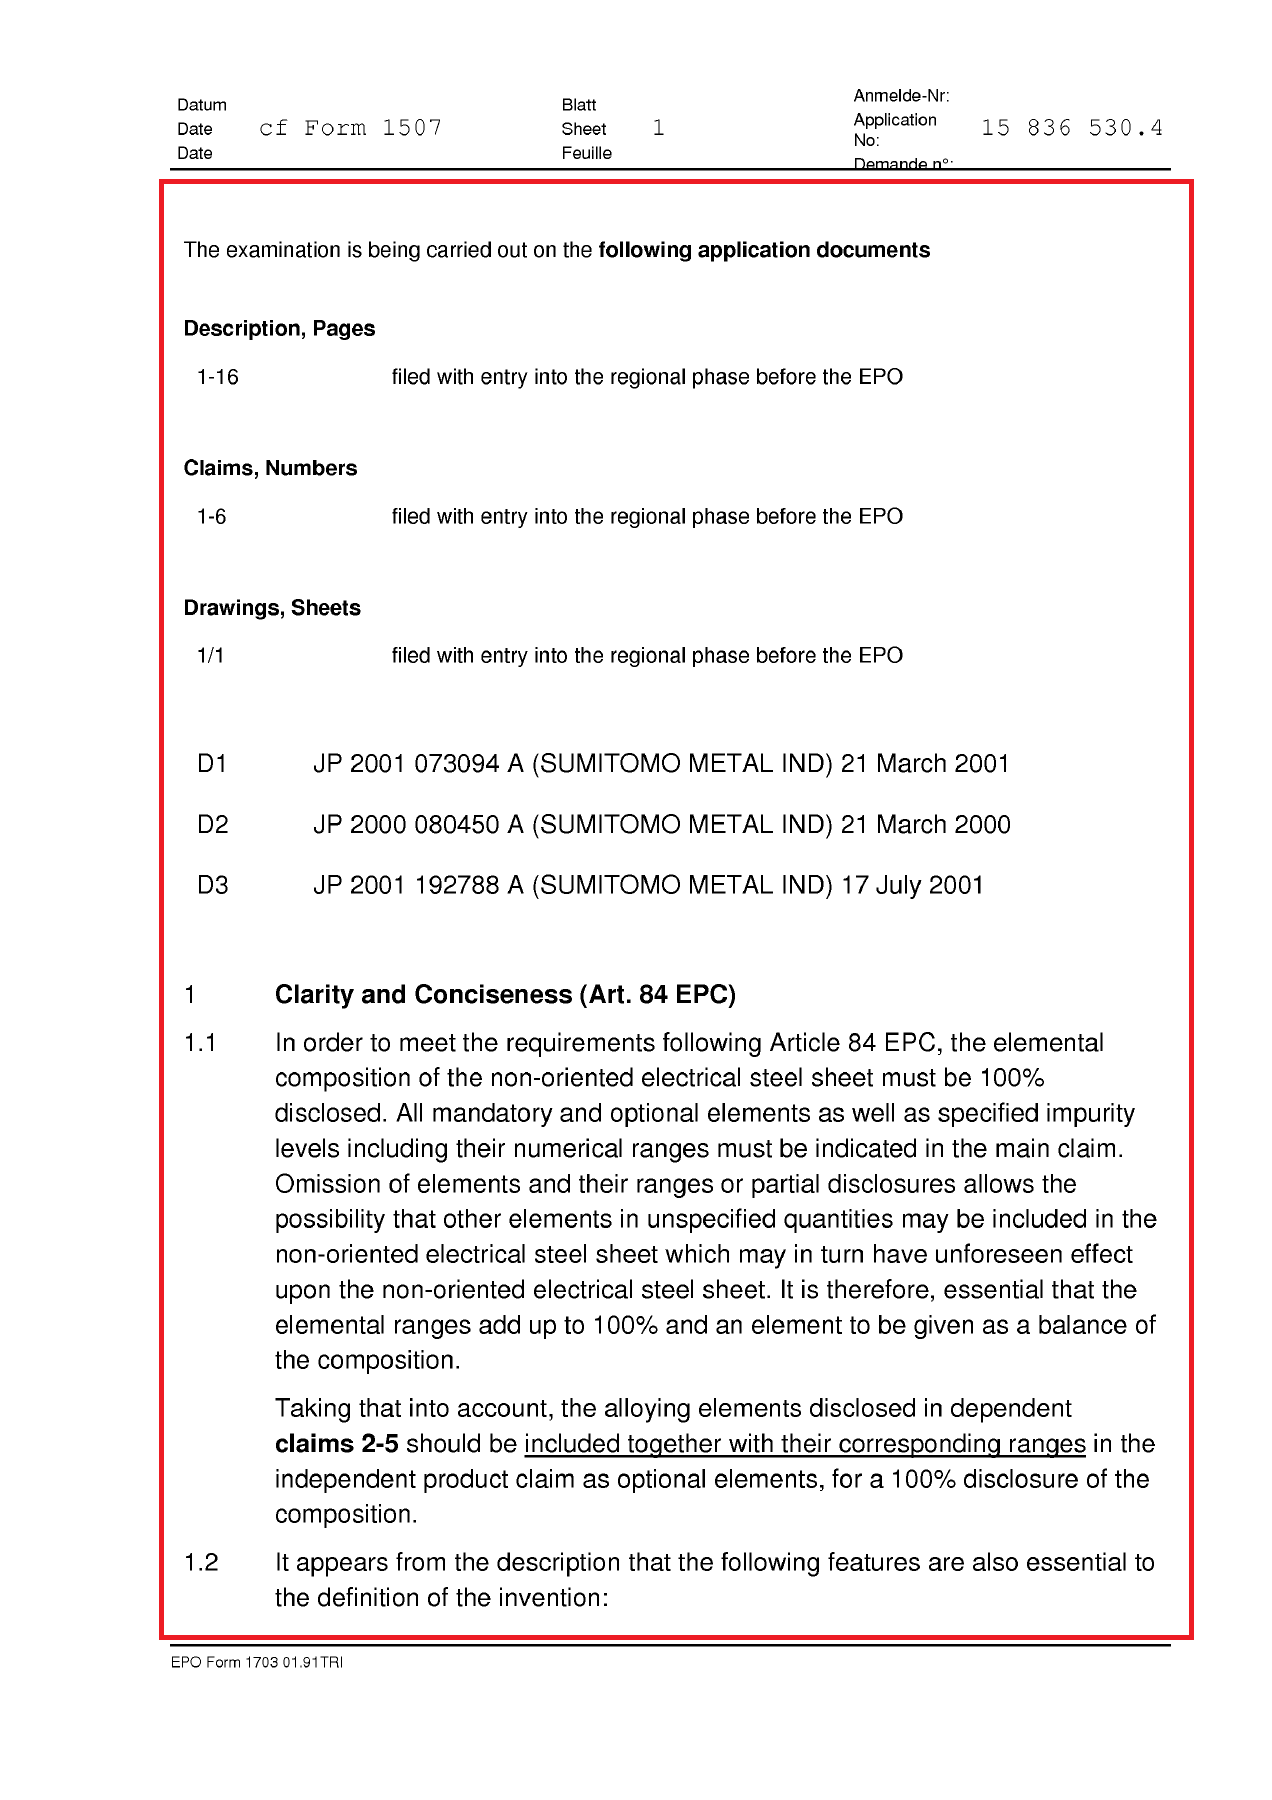
下記は例ですが、どのファイルにも応用が可能です。

## 画像ファイル加工
img_dir = pathlib.Path('Images')
for p in glob.glob(os.path.join(img_dir, "*.png")):
    if os.path.isfile(p):
        ## 画像1枚の加工
        img = PIL.Image.open(p)
        # 切り抜き版を(left, upper, right, lower)で指定
        img_crop = img.crop((160, 180, 1200, 1640))
        img_crop.save(p)

上記の画像ファイルは下記のように加工されます。
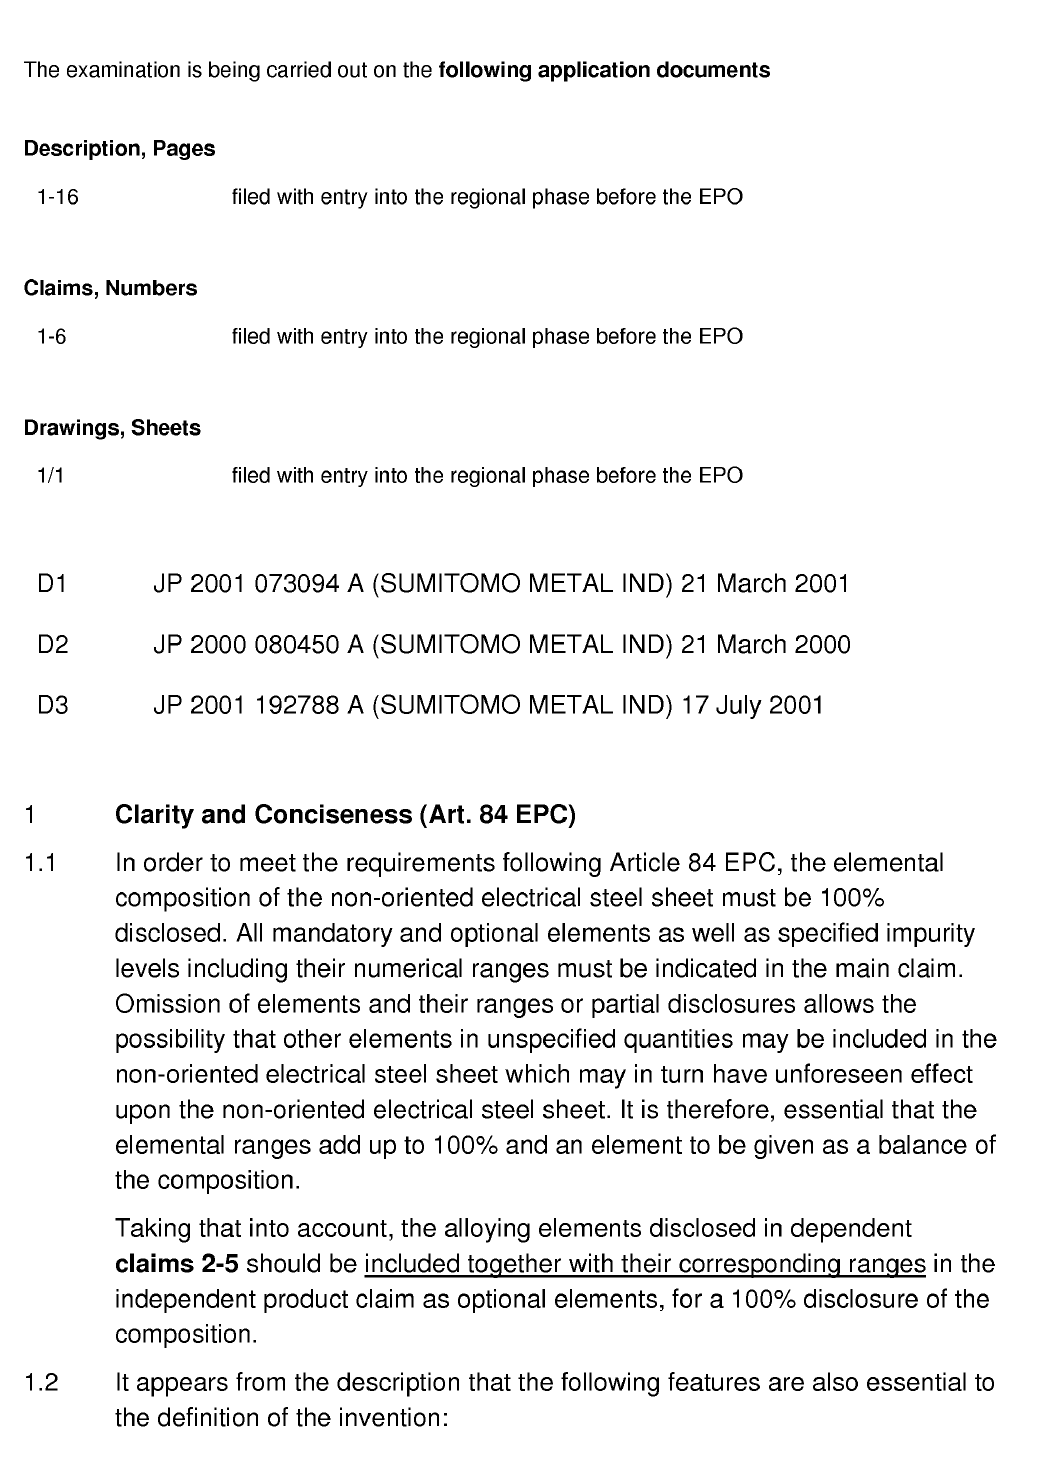
加工することで、無駄な情報がかなり減ります。
例として、加工前と加工後の文字を比較します。

画像加工後にも存在, 画像加工前のみ存在

Datum Blatt Anmelde-Nr:\nDate cf Form 1507 Sheet 1 ppelcation 15 836 530.4\nDate Feuille °° .\nThe examination is being carried out on the following application documents\nDescription, Pages\n1-16 filed with entry into the regional phase before the EPO\nClaims, Numbers\n1-6 filed with entry into the regional phase before the EPO\nDrawings, Sheets\nq1 filed with entry into the regional phase before the EPO\nD1 JP 2001 073094 A (SUMITOMO METAL IND) 21 March 2001\nD2 JP 2000 080450 A (SUMITOMO METAL IND) 21 March 2000\nD3 JP 2001 192788 A (SUMITOMO METAL IND) 17 July 2001\n\n1 Clarity and Conciseness (Art. 84 EPC)\n\n14 In order to meet the requirements following Article 84 EPC, the elemental\ncomposition of the non-oriented electrical steel sheet must be 100%\ndisclosed. All mandatory and optional elements as well as specified impurity\nlevels including their numerical ranges must be indicated in the main claim.\nOmission of elements and their ranges or partial disclosures allows the\npossibility that other elements in unspecified quantities may be included in the\nnon-oriented electrical steel sheet which may in turn have unforeseen effect\nupon the non-oriented electrical steel sheet. It is therefore, essential that the\nelemental ranges add up to 100% and an element to be given as a balance of\nthe composition.\n\nTaking that into account, the alloying elements disclosed in dependent\nclaims 2-5 should be included together with their corresponding ranges in the\nindependent product claim as optional elements, for a 100% disclosure of the\ncomposition.\n\n1.2 It appears from the description that the following features are also essential to\nthe definition of the invention:\n\nEPO Form 1703 01.91TRI

加工方法が決まった場合、PDFを画像化し、画像をOCRで読み込むPython関数の定義内の「上記の画像を加工したい場合はこちらに記述する」に記述すると画像加工処理を組み込むことができます。

最後に

Pythonにより、かなり簡単にPDFから文字抽出を行うことができたと思います。
ある程度文書構成が決まっていた場合には、文字の自動抽出を行うことができるようになるでしょう。

このような技術があれば、医療・医薬品業界や司法関連業務の半自動化が進むといいですね。
ヒトは解釈など機械にできないことに時間を使うべきであって、単純作業に時間を取られるべきではないです。

参考

PythonでPDFからテキストを読み取る方法について
PythonでOCRを実行する方法
Python, Pillowで画像の一部をトリミング(切り出し/切り抜き)
[Meisyo]「覚醒」の仕様

[Meisyo] アップデート方針2020.10の通り、選手が覚醒できるようになりました。
ただし、覚醒するためのアイテム入手先など詳細を決めていなかったので、仕様としてまとめました。

覚醒概要

選手の能力値上限(S120)がなくなり、カードの絵柄も変わる。
覚醒後、各能力の覚醒Lvを上げることで能力値の上昇が可能(最大5%)になる。
覚醒Lvを上げるアイテムは探索がメイン(つまり他でもOK)で手に入る。
探索のフィールドボスとの戦いで勝利すると入手可能に。

※ベースの能力値は基礎+育成+強化値の合計とする。

フィールドボス

パワフル高校

覚醒用。
ステータスは70(監督Lv40相当)でPP1のを純粋強化・スキル付与を予定。

1マップに2キャラクター存在し、誰かに発見された場合はその他の人は1日間挑戦できなくなる(挑戦権システム)。
戦いに勝利した場合は3日後に再度出現する。

勝敗に関わらず各能力の覚醒Lv上昇アイテムを複数個(最大5)獲得可能。
勝利すると覚醒アイテムを入手可能。

博士チーム

覚醒Lvを上げる用。
ステータスは85~90(監督Lv80相当)で守備重視型を予定。

1マップに1キャラクターしか存在せず、誰かに発見された場合はその他の人は1日間挑戦できなくなる(挑戦権システム)。
戦いに勝利した場合は7-14日後に再度出現する。

勝敗に関わらず各能力の覚醒Lv上昇アイテムを複数個(最大20)獲得可能。
勝利すると覚醒アイテムを入手可能。

覚醒

カード詳細から覚醒アイテムを1つ使用し、覚醒状態になる。
能力値の上限が解放される。

覚醒Lv上昇

覚醒Lv上昇アイテム(投手・野手能力別)と選手EXPを使い、各能力値の覚醒Lvを上げることができる。
0~100段階あり。
100で能力値が5%UPする。

*必要選手EXPは1回あたりLv100→101分。これまで使い道がなかった選手Lv100以上の経験値取得に対し、使い道を追加する。

コメント

覚醒は能力上限解放と能力値パーセント上昇で実装しています。

ある速球投手(速球能力値140)で覚醒Lv80にした場合、
速球投球時にスキル(ノビLv4)が発動すると・・・

140 * 1.04 + (5 + 2 * 4) = 158.6

以前と比べて能力値が5.6伸びます。
うん、強いわね・・・(対応できる打者居るのか?)という状態に。

ちなみに、覚醒Lvはキレにも付与されています。
キレは強化・育成ができない分、覚醒Lvが重要なアップ要素になります。

さらに投手が重要になってきそうですね。

統計的因果探索(LiNGAM)を分析実務観点で詳しく解説

統計的因果推論の一分野である統計的因果探索。
その研究の中で生み出された画期的なモデルLiNGAMの解説を行います。PythonによるLiNGAMの実装については、cdt15/lingamと、応用モデルおよびPythonモジュールの解説をご覧ください。

背景

これまでの統計学や機械学習の多くが、相関を元に関係性を把握してきました。

ただし、その変動は何が原因なのかという本当に知りたいことは不明でした。

因果探索とは、データから因果構造を推定する方法を指します。
それは、因果の方向性や大きさを含み、これまでの統計学や機械学習とは違った原因とは何かを探していく方法です。

ここでは、統計的因果探索の代表的なアプローチであるLiNGAM(Linear Non-Gaussian Acyclic Model)を紹介します。

数理的なアプローチは他の資料に譲るとして、実用にはどういった点を注意すべきか、どのような応用モデルがあるかについて中心に説明します。

LiNGAM適用の前提条件

LiNGAMを適用する前に、適用するデータの前提条件が4つあります。

(1)Linear

線形な(足し合わせで表現できる)構造方程式で示すことができるとする。

構造方程式とは、下記のような式です。

簡略化するとxは何で、yは何で表されるかを示すことができる式です。

(2)Non-Gaussian

構造方程式の誤差項は非正規(ガウス)分布である。

(3)Acyclic

非循環な因果グラフ(Directed Acyclic Graph)で表すことができるとする。

(4)構造方程式

未観測の要因が存在しない。つまり、構造方程式で因果構造全てを表すことが可能であるとする。
各誤差項は互いに独立であり、各変数は連続値であるとする。
*各誤差項はxやyなどで表せていない値の動きを全て表現できるとする。

調べていて、かなり強い前提を置いているのでは?というところが分かりました。

前提条件の理由

前提は4つありますが、一番気になるのはなぜ「構造方程式の誤差項は非正規(ガウス)分布である。」のかでしょう。
*変数の独立性や分布のガウス性の成否は、一般的な方法で求めることができるので割愛します。

少し調べてみるとLiNGAMはセミパラメトリックアプローチとされています。セミパラメトリックアプローチの定義は、関数型には仮定を置くものの、構造方程式の誤差項(外生変数ともいう)の分布には仮定を置きませんとされています。

LiNGAMは誤差項を「正規分布以外」という仮定であるので、それ以外の分布はすべて取りうる(=仮定を置いていないのと同じ)というスタンスを取っているため、セミパラメトリックアプローチに分類されています。

そうすると、何が嬉しいのでしょうか?
そうしなければ、何に困るのでしょうか?

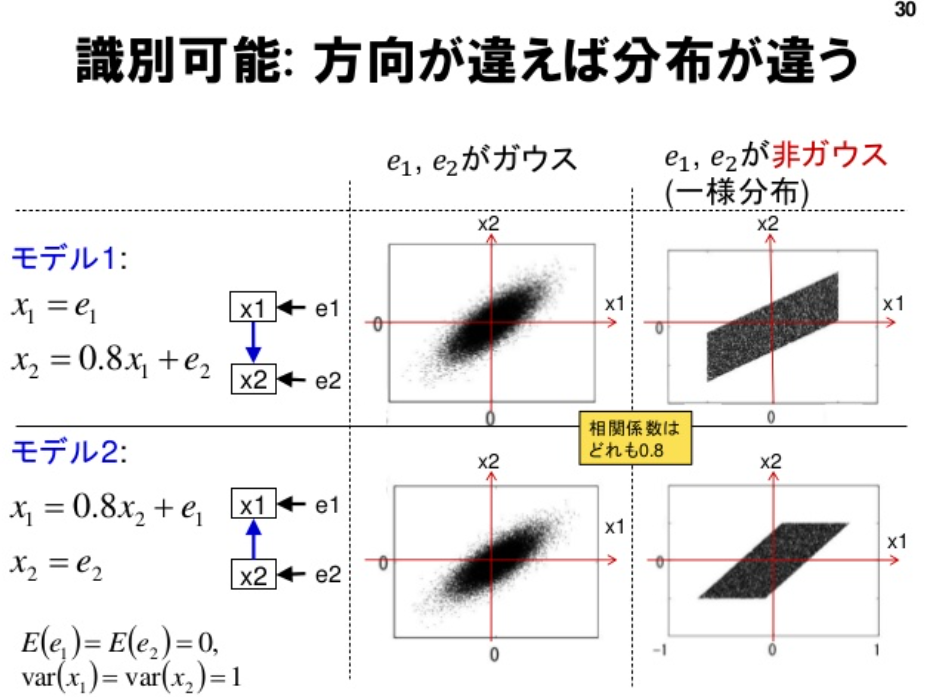
答えは、誤差項が正規分布であると因果の方向が推定できないのです。

下記の図をご覧ください。

(因果探索: 基本から最近の発展までを概説 P.30)
変数の平均や分散が同じで、正規分布であるとx1かx2どちらがどちらか判断がつきません。

そのため、LiNGAMの誤差項は非正規分布であるという仮定を置いていると読み解けます。

実用時の懸念点

上記に記載した4つの前提で気になる点は複数あります。

(1)Linear

線形な(足し合わせで表現できる)構造方程式で示すことができるとする。

懸念点

本当に因果関係は線形で表せるのか?
例えば、コンビニで購入する経験と行動変容について、下記の条件で行う1回の差は同じだろうか?
・初めて(1回目)の購入(感触:これ良さそう! → 経験:いいなこれ!)
・2回目の購入(これ良かったよね! → やっぱり良いね!)
・3回目の購入(これやっぱり良いよね! → ずっとこれにしよう!)

LiNGAMでは同じと計算されます。

(2)Non-Gaussian

構造方程式の誤差項は非正規(ガウス)分布である。

懸念点

正規分布は、実世界のデータではなかなか見かけないので問題ないのだろうか。特に、購買関係は正規分布は少ない。

実世界のデータで、機器の波形データなどに正規分布があることは周知の事実です。因果グラフ上に正規分布のデータがもし存在した場合は、その変数を除外するのか?正規分布でなくなるように加工するのか?は不明です。

(3)Acyclic

非循環な因果グラフ(Directed Acyclic Graph)で表すことができるとする。

懸念点

一般的に因果は循環しうるのではないか?例えば、購買活動で良い体験が得られた場合は、もう1度経験しようとする動機が生まれるのではないか?

(4)構造方程式でかつ…

未観測の要因が存在しない。

つまり、構造方程式で因果構造全てを表すことが可能であるとする。各誤差項は互いに独立であり、各変数は連続値であるとする。

懸念点

すべての要因を観測できていることはありうるのか?ということですね。無理だと思います。

こちらは。統計的因果推論の傾向スコアマッチングでも問題になりますね。

以上、上記のようにいろいろな疑問点が浮かんできますね。
そのまま推定すると、前提条件から外れているため、因果構造の推定精度が落ちることは予想されます。

その対処には、複数の応用モデルが存在します。

応用モデルおよびPythonモジュールの解説


下記で簡単にインストールが可能です。

pip install lingam

テストコードはLiNGAM – Githubのexampleディレクトリで利用可能です。下記で紹介しているモデルの他にもさまざまなモデルが存在します。

コードの実行については、その他の資料に説明を譲ります。

方法論としてDirectLiNGAMはよく使いそうなので、解説を追加しておきました。

DirectLiNGAM

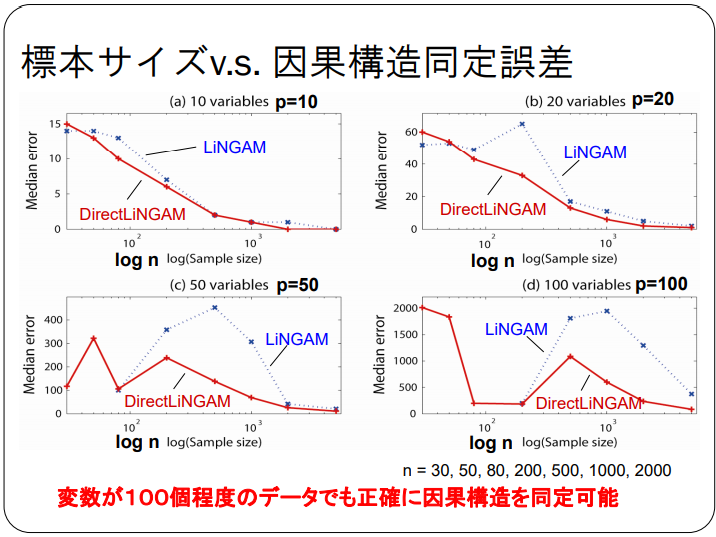
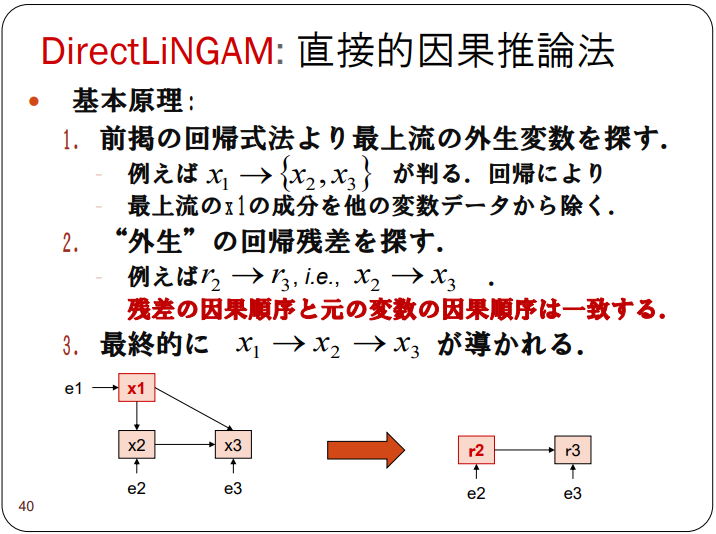
回帰分析の残差を利用したモデル。通常のICA-LiNGAMより性能が良いとされている。(ビッグデータに基づくモデリング -生体・医療への適用を例として-より)

DirectLiNGAM アルゴリズム


日本語で良い資料がなかったので同資料をコピーしています。
回帰分析を行い、その残差をさらに回帰分析することを繰り返す方法です。意外と簡単ですね。

非線形モデル

関数型を線形→非線形に切り替えます。

巡回モデル

因果を非巡回→巡回に切り替えます。

離散変数モデル

ベイジアンネットワークのように変数を離散変数として扱います。

未観測要因ありモデル(ParceLiNGAM)

外生変数に未観測要因があることを前提に計算します。

離散変数モデル

ベイジアンネットワークのように変数を離散変数として扱います。

時系列モデル(VARLiNGAM、VARMALiNGAM)

時系列(過去・現在)のロジックを追加します。

データ構造変化モデル(LongitudinalLiNGAM)

時間軸でのデータの構造変化を考慮します。

複数データグループモデル(MultiGroupDirectLiNGAM)

複数のデータグループが存在する時、単独でそれぞれLiNGAMを行うより、まとめて行う方がよい精度が出るように考案されたモデル。

以上、その他にも多くのモデルが提唱されていますので、ぜひ試して記事を書いてみてください!

注意点

コードを実際に動かしてみると、実務に簡単に適用できそうと思いました。しかし・・・実務のウラでテストしてみると、実務適用に難しい点が何点も出てきました。

グラフ構造を指定しないと、推定が全くうまくされません

特定のモデルでは、グラフの開始ノードと終了ノードが指定可能です。

ある実データ(売上データ)を使い実験してみました(5例すべて)が、構造を指定しないとうまく予測されませんでした。指定しない場合、一般的と考えられる因果構造と逆、例えばユーザー継続の原因が売上のような結果が出てきました。

データ量が少なすぎると、結果が出力されません

ある実データ(売上データ)で1年間・週ごと(48=4週×12か月)かつ20カラムのデータでは、結果が表示されませんでした。

検証方法がわかりません

カイ二乗検定を使います。つまり、期待値からどれくらい値が外れているか(=有意な差があるか)の指標で判断します。
(因果探索: 基本から最近の発展までを概説 P.37)

ただし、どれくらい値が大きくなれば適合している・していないと言えるのか基準がわかりません。使うとすれば、同じ取得条件のデータで、指標を比較して使うべきでしょう。

SEM(Structural Equation Modeling)との違いが判りません

比較したモデルは、Python LiNGAM(Direct LiNGAM)とSPSS AMOSです。

ある実データ(売上データ)で実験を行いましたが、グラフ構造を指定した場合はほぼ同じ結果(因果の方向、係数の相対的大きさ)が出てきました。ただし、係数の実数値は大きく異なりました。

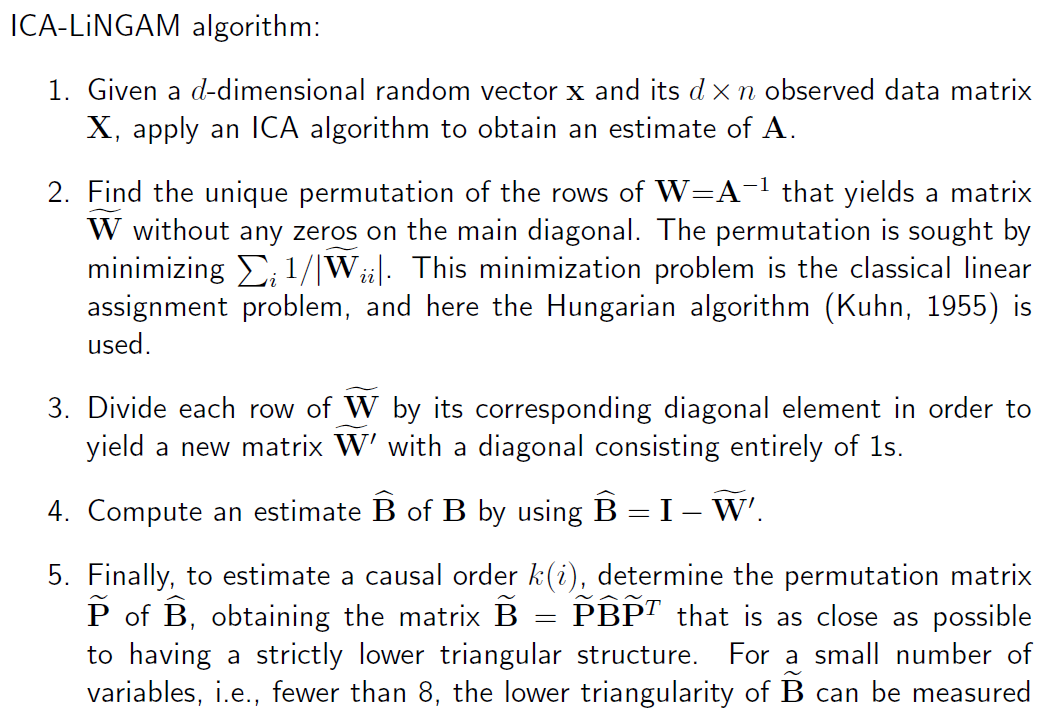
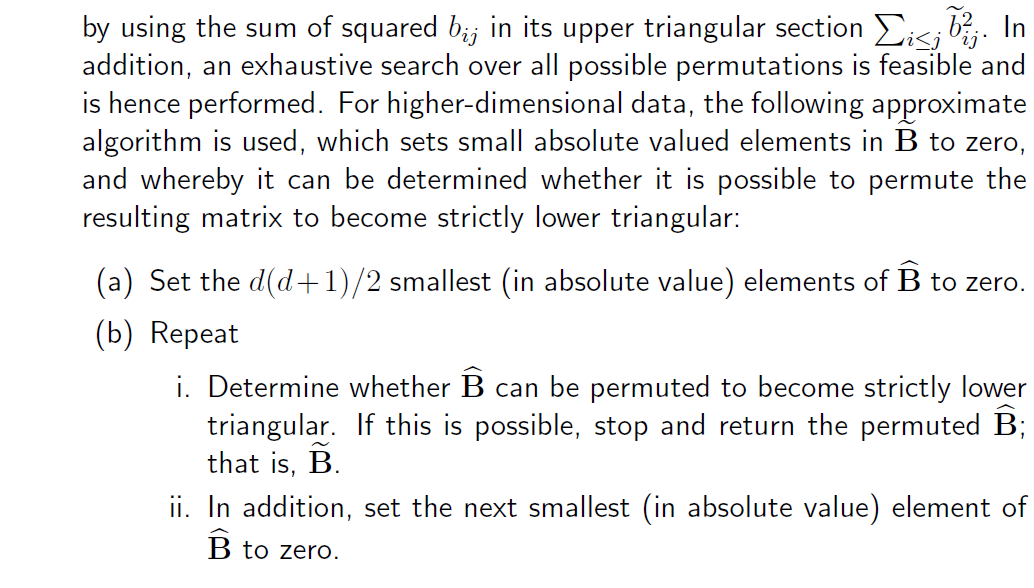
おまけ:LiNGAMの解き方


1. 独立成分分析(ICA)

DirectLiNGAMと比較してICALiNGAM呼ばれる理由でもある。

2. 復元行列WをAの逆行列から求める

3. ハンガリアン法による最小化

4. 行の順序入れ替え

ICAは行の識別性がないので、入れ替える必要がある。

5. 単位行列Iを除く

6. 因果方向・効果量を特定する

結果. 構造方程式で示すことができる形となる

まとめ

今回は、統計的因果探索のLiNGAMを紹介しました。
「因果構造を把握することで、何をすれば購買につながるのか?」ということは全世界のマーケターをはじめ、購買に関係する社会人は知りたいでしょう。

ただ、実データで利用するとしても問題点があります。

科学的なデータとは違い、そもそもの答えが分からないのです。心理的な背景がどうなっているか、それがどうなるかは私たちの知りうる範囲ではありません。そのため、大規模に実験しづらい問題があります。

なぜなら、時間を掛けて上手く行くかどうかわからないことを試す余力はないからです。何度も何度も実証を重ねて、一般的な因果構造を理解するとどれくらい儲かるのでしょうか?投資対効果が全く分からないのです。

かつ、個人によって因果構造が違うのではないかという懸念もあります。一般的な科学的モデルであれば、因果構造は一定です。経験や環境によってヒトは判断を変えうるのです。それを推定できるのでしょうか?

そのようにいろいろと問題は山積していますが、私はまずは1つやってみなければ始まらないと思っており、データ分析案件実施上の空き時間でテストをしていました。

色々と認識違いがあるかもしれませんが、その際はコメントいただけると幸いです。皆さんもぜひ試してください!

参考文献

発明者の清水さんをはじめ、多くの方の書籍・文献を参考にさせていただきました。
統計的因果探索 (機械学習プロフェッショナルシリーズ)
因果探索: 基本から最近の発展までを概説
LiNGAM: Non-Gaussian methods for estimating causal structures.
つくりながら学ぶ! Pythonによる因果分析 (Compass Booksシリーズ)
etc…

より深く勉強したい方へ

【教材紹介】入門統計的因果推論で因果推論、グラフ理論の基礎を学んでから、清水先生著作の【教材紹介】統計的因果探索を学ぶことでより深い理解が可能です!

分析スキルも大事だけど、思考法の方が大事だよっていう話

データサイエンス関連の仕事をしていて思うのは、

分析スキルも大事だけど、思考法の方が大事だよっていう話です。

最近、会社で教育・OJT関連の業務をしていて切に思うので、つらつらと書いていきます。

まず第一に、スキルは大事です。

大事ですが・・・記憶力のいいひとには、スキルは割と簡単に身に付きます。
特に簡易的な解説書がある分野に関しては、すごく早いスピードで身に付きます。
ただ、そこには価値があるのだろうかと思うことが多いのです。

正しい目標設定がなければ、事業は、仕事は上手く行きません

その目標設定ができる、自分なりの思考方法を持っている人が少ないなと思います。
持っていなければ過去の焼き直ししかできないので。

もちろん、思考法は確度の高い正解を求めることができますが、唯一絶対の答えを示すことはできないです。失敗は当たり前です。

目標設定ができた上で、分析スキルが活躍します。
あくまで分析スキルは、目的が上手くハマったときにしか生きません。
したがって、思考法を鍛えたいよねという話を良くしています。
あとは、その事業の内容を理解していないと話にならないよねとも。

例えば、ソーシャルゲーム業界の案件で、あるゲームの売り上げを伸ばしたいとします。

自然言語処理でレビューサイトの出現する言葉の傾向を見て、
良いレビュー群はさらに伸ばしていくべきポイント、悪いレビュー群は改修すべきポイントと仮定します。

ただし、分析の前にゲーム内容を確認していません。
さて、どのような分析結果になるのでしょうか?

・
・
・

予想するに、当たり前の結果しか出てこないとなるでしょう。
しかも、施策に反映しても売り上げに良い影響がある確率は非常に低いです。

なぜなら、売り上げとレビューが関連するという前提が正しいのかどうかわからないです。

細かく指摘をすると、以下のように様々な前提を検証していない中で、自然言語処理を使うことが目的になっているからです。
・サービス(ここで言うゲーム)内容を把握しておらず、コメントが事実かどうかが分からない。
・レビューは具体的な改修ポイントを言っていないことが多く、あくまで1プレイヤーの感覚であることが多い。
・自由文で書かれているため、評価が非常に難しい。英語では皮肉が割と多い。

なぜその内容をするのか、その手法でなければならない理由は何かという思考法がないんですよね。

そのため、スキルより、思考法を鍛えたいですねという結論になります。

思考法を鍛える方法は割と簡単で、分かっている人に対して壁打ちをすることです。
色々な本はありますし、学ぶのは難しくありません。

もちろん、最初は思考が上手く行かないので、自分の思考法が否定されます。
そこで自分を否定されたと思う人が多いんですよね。

ここが大きな壁です。

ただのスキルチェックをして、間違いを訂正しているだけなのに。
エンジニアで言うなら、このコードはこう書いたらバグ出ないよね?と言ってるだけです。

ただ、思考法はスポーツとよく似ていて、
頭(体)になじませる間は習得状況が分かり辛いという分析スキルとは大きな違いがあります。

意識しなくてもできるレベルを目指している思考法と、
本を見ても何でもいいから、とりあえず再現ができればいい分析スキルと習得難易度は違います。
その前提を理解してからすると、挫折しにくいはずです!

思考法の勉強、始めてみませんか?

ゲームデータで学ぶSQL(初級編)

近年のデータサイエンスブームをきっかけに「SQLを学びたい」と思った方へ。

そう思ったところで、壁になってくるのは実データの入手です。
私は職業としてデータサイエンス関連の業務に従事していますが、キレイに整形されたデータはKaggle等にあるものの、実際のログデータとしてはほど遠いという認識があります。

確かに、「実運用されているサービスのログを入手できないか」と言われれば不可能だと思います。
ただ、私は趣味でゲーム作成をしていることもあり、ログデータを作ってきたので入手が可能でした。
学ぶなら実データの方がいいなと思ったので、今回公開します。

そのため、今回はそのゲームデータを使用してSQLを学びましょう!
演習を3つ用意していますので、取り組んでみてください~(^o^)ノ

データ

名将と呼ばれた者達の実データを使用します。
このデータはユーザーのすべての行動を記録しているactsログ8-9月分(約14万行)です。

meisyo_acts_output_20200930.zip
※ZIPファイルのため解凍が必要です。
※ID等は個人特定が不可能な加工を施しています。

使用データベース

MySQL
※MySQLの最低限のクエリでどうにか集計する方法を学んでほしいため。分析はBigQueryやPostgreSQLなどの方が向いている。
※BigQuery等での読み込みも可能な形式(CSV)のため、そちらでも利用できます。

MySQL環境構築法

XAMPPをインストールし、phpMyAdminを起動してください。
phpMyAdminに実データ(CSV)をインポートしていただくと使用が可能になります。

下記の管理コンソールから、MySQLのAdminをクリックするとphpMyAdminにアクセス可能です。

はじめに

今回行う集計はよくありがちな流れです。

1枚の画像で表しました。

まずはこの図をメモしてください。

集計でミスが起こる場面は下記のどちらかです。
1・1ユーザーごとのログに集約
2・1ユーザーごとのログから図式・文書化

どちらでしょうか?

私の認識では、
2・1ユーザーごとのログから図式・文書化です。

これまでの業務(教育関連)で上手くできない人は、
目的意識がなく、集計ができたら満足してしまうという傾向がありました。
そこさえできていれば問題ないのですが…。そこが難しい。

何のために、何を見たいのかという目的意識をはっきり持ってください。

データベース作成

phpmyAdminを開いて画面左のNewをクリックし、データベースを作成します。

次に、そのデータベースのタブをクリックし、SQLでテーブル構造を設定します。

CREATE TABLE acts (
id INT AUTO_INCREMENT NOT NULL,
mn_id VARCHAR(32),
time VARCHAR(20),
sub VARCHAR(32),
action VARCHAR(1024),
PRIMARY KEY(id)
) ENGINE = INNODB character set utf8mb4;

最後に、テーブル構造を設定したactsにインポートでデータを入れます。
データ量が多いため複数回再送信が必要です。
※id=1を削除しておきましょう。

データ準備を行うことができました。

集計1

目的:日ごとのログインユーザー数を知りたい

まずは、データの構造を理解するところから始めましょう。
設定に使用したSQL構文を確認します。

CREATE TABLE acts (
id INT AUTO_INCREMENT NOT NULL,
mn_id VARCHAR(32),
time VARCHAR(20),
sub VARCHAR(32),
action VARCHAR(1024),
PRIMARY KEY(id)
) ENGINE = INNODB character set utf8mb4;

前提として、各カラムの意味、データの生成要件、用語の定義を知る必要があります。

各カラムの意味は以下の通りです。
id:テーブルログの生成id
mn_id:監督ID(プレイヤーIDと同義)
time:JST(UTC+9)時間での時間表記
sub:機能名
action:各機能での詳細ログ

データ生成要件は以下の通りです。
・何らかの機能を触ると、全ての行動が取得される。
(ログインしなければログは出されない)

用語の定義は以下の通りです。
・ログイン:何らかの機能に触れたことがある(=何らかのログが生成されている)
・日ごと:日本時間での1日ごと

このように、集計の前提を定義することが非常に重要です。
なぜなら、それを定義していないと「思っていたことと違う」分析になってしまいます。
今回は、目的:日ごとのログインユーザー数を知りたいなので、そこから外れないようにしたいですね。

続いて、集計の考え方の手順です。

1・1ユーザーごとのログに集約

まず1からやっていきましょう~。
1ユーザーごと、かつ定義した日ごとのログに集約していきます。

SELECT
  DATE(time) AS date
  ,mn_id
FROM
  `acts`
GROUP BY
  date
  ,mn_id

※DISTINCTでもOKだが、後々のこと(日ごとのプレイ回数を付与等)を考えるとGROUP BYが最適。

2・1ユーザーごとのログから図式・文書化

続いて、日ごとの人数を出力します。

SELECT
  a.date
  ,COUNT(a.mn_id) AS count_uu
FROM
  (
    SELECT
      DATE(time) AS date
      ,mn_id
    FROM
      `acts`
    GROUP BY
      date
      ,mn_id
  ) AS a
GROUP BY
  a.date
ORDER BY
  a.date

※COUNT関数でDISTINCTを使う人は多いです。ただし、今回はすでにa内でGROUP BYしているので不要です。

このようにすると、目的:日ごとのログインユーザー数を知りたいを達成できます。

集計2

目的:日ごとのログインユーザー数とその継続率を知りたい

集計1を終えた方は、継続率って何だろう?決めないとと思っていただけるかと思います。

継続率は、「ログインした当日からN日後の日にログインしているか」という定義にします。
10月10日にログインしていた場合、7日後なら10月17日にログインしているかどうかを判定します。

この指標は、ゲームでユーザーが継続していることはKGI(Key Goal Indicator)(※売上等)の達成に良いことであると仮定しているため、集計を行います。

ここでは、LEFT JOINを使います。

下記のように接続を行います。、
10月10日にログインしたユーザー ← M月J日にログインしたユーザー
プレイヤーIDは同一であるなら結合をOKとする。
SELECTで、N日後を設定する。

INNER JOINだと、
10月10日にログインかつM月J日にログイン、でどちらもログインしていないユーザーは消えます。

LEFT JOINだと、
10月10日にログインしていればよくてM月J日にログインしているかどうかは何も決めないという強くない制約を置きます。
※WITH句を使えないMySQLのバージョンなので、同じ構文を再度書いています。

1・1ユーザーごとのログに集約

まず1からやっていきましょう~。
1ユーザーごと、かつ定義した日ごとのログに集約していきます。

SELECT
  DATE(time) AS date
  ,mn_id
FROM
  `acts`
GROUP BY
  date
  ,mn_id

続いて、1ユーザーごとにN日後にログインしたかどうかのフラグを付けていきます。

SELECT
  a.mn_id
  ,a.date
  ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 7 THEN 1 ELSE 0 END) AS flag_day7 # 差分が7日あるユーザー(Nullの場合の対応をIFNULLで追加)
  ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 14 THEN 1 ELSE 0 END) AS flag_day14 # 差分が14日あるユーザー
  ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 30 THEN 1 ELSE 0 END) AS flag_day30 # 差分が30日あるユーザー
FROM
  (
    SELECT
      DATE(time) AS date
      ,mn_id
    FROM
      `acts`
    GROUP BY
      date
      ,mn_id
  ) AS a
LEFT JOIN
  (
    SELECT
      DATE(time) AS date
      ,mn_id
    FROM
      `acts`
    GROUP BY
      date
      ,mn_id
  ) AS b
ON
  a.mn_id = b.mn_id # プレイヤーIDが同じなら結合
GROUP BY
  a.mn_id
  ,a.date

2・1ユーザーごとのログから図式・文書化

最後に、継続率を出していきましょう。

N日後継続率= 当日ログインしていた人のうち、N日後にもログインしていた人 / 当日ログインしていた人なので、AVGで出せます。
AVGは計算方法が=SUM(case)/COUNT(all)なので、フラグ化した変数を使用すると実施割合を出力できます。

SELECT
  a.date
  ,COUNT(a.mn_id) AS count_uu
  ,AVG(flag_day7) AS per_day7
  ,AVG(flag_day14) AS per_day14
  ,AVG(flag_day30) AS per_day30
FROM
  (
    SELECT
      a.mn_id
      ,a.date
      ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 7 THEN 1 ELSE 0 END) AS flag_day7 # 差分が7日あるユーザー(Nullの場合の対応をIFNULLで追加)
      ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 14 THEN 1 ELSE 0 END) AS flag_day14 # 差分が14日あるユーザー
      ,MAX(CASE WHEN DATEDIFF(IFNULL(b.date, '9999-12-31 23:59:59'), a.date) = 30 THEN 1 ELSE 0 END) AS flag_day30 # 差分が30日あるユーザー
    FROM
      (
        SELECT
          DATE(time) AS date
          ,mn_id
        FROM
          `acts`
        GROUP BY
          date
          ,mn_id
      ) AS a
    LEFT JOIN
      (
        SELECT
          DATE(time) AS date
          ,mn_id
        FROM
          `acts`
        GROUP BY
          date
          ,mn_id
      ) AS b
    ON
      a.mn_id = b.mn_id # プレイヤーIDが同じなら結合
    GROUP BY
      a.mn_id
      ,a.date
  ) AS a
GROUP BY
  a.date
ORDER BY
  a.date
  

このように継続率を出します。
基本的にソーシャルゲームの業界では1・3・7・14・30日後継続率を出すことが多いですが、あくまで一般論であってN日を定義するのはアナリスト次第です。

集計3

目的:2020年9月にログインしたユーザーは何のコンテンツをプレイしているのか知りたい

集計2を終え、何となくですがSQLが分かってきたかと思います。
今回は・・・何のコンテンツをプレイしているかという問題です。

まず用語の定義が必要ですが、ドメイン知識(領域知識、業界知識)がないのでコンテンツとは何かわかりません。

そのため、コンテンツの種類を知るための・・・集計のための集計を行います。
コンテンツの種類が分かったところで、プレイしている人数が分からないと重要度がわかりませんので、併せて集計しておきます。

SELECT
  sub
  ,COUNT(DISTINCT mn_id) AS count_uu # DISTINCT必須
FROM
  `acts`
WHERE
  DATE_FORMAT(DATE(time),'%Y-%m-01') = '2020-09-01' # 9月に限定
GROUP BY
  sub
ORDER BY
  count_uu DESC # 降順

下記表が出力されます。

ここで立ち止まって考えてみましょう。
なぜ何のコンテンツをプレイしているか知りたいのか?を考えてみてください。

私が出せる仮説は、大きくは以下の通りです。
・とりあえず大まかなプレイ傾向を知りたいから、試合や特訓のメインコンテンツが遊ばれているか知りたい
・新規登録ユーザーが想定したプレイ内容(練習試合、特訓)きちんと遊んでくれているのか知りたい
・既存ユーザーが全然プレイしていないコンテンツがないか知りたい

この3点をSQLで集計しようとすると全然違ったモノが必要ですよね?

解決策としては、依頼者に話を聞きましょう。
「何が知りたいのか」「なぜ知りたいのか」をです。
ここをしない人は必ず失敗します。ご注意ください。

今回は講座なので、下記の仮説に従って集計していきます。
とりあえず大まかなプレイ傾向を知りたいから、試合や特訓のメインコンテンツが遊ばれているか知りたい

ドメイン知識を整理します。
試合は3種類あります。
20時間に1回いずれかをプレイ可能です。監督LvUPするともう1度遊べます。
・練習試合:月ごとのリーグ戦(PvP)を行うコンテンツ。
 プレイはsub=game_practice_goで取得可能
・シナリオ:難易度が選べるvsNPCコンテンツ。一度負けると最初からのタワー形式。
 プレイはsub=senario_goで取得可能
・模擬戦:対戦相手が選べるvsNPCコンテンツ。
 プレイはsub=game_test_goで取得可能

特訓は3種類あります。
20時間に1回いずれかをプレイ可能です。監督LvUPするともう1度遊べます。
・挑戦:クリアすることでオリジナル選手を獲得できるコンテンツ
 プレイはsub=practice_chall_fで取得可能
・特訓:特定の選手を強化かつ投打データ取得が行えるコンテンツ
 プレイはsub=practice_training_goで取得可能
・探索:選手強化アイテムを取得できるコンテンツ
 プレイはsub=map_json_userおよびaction=1で取得可能。
 action=0はサーバー接続確認のための確認ログ。

用語の定義としては、以下を決めておきます。
・遊ばれているか
 ログインしている人のうち、遊ばれている割合

ではそれをSQLの考え方を使ってまとめていきましょう。

1・1ユーザーごとのログに集約

GROUP BYを使い、MAXでフラグ化するととても扱いやすいログ形式になります。

SELECT
  DATE(time) AS date
  ,mn_id
  ,MAX(CASE WHEN sub = 'game_practice_go' THEN 1 ELSE 0 END) AS flag_play_gpractice
  ,MAX(CASE WHEN sub = 'senario_go' THEN 1 ELSE 0 END) AS flag_play_gsenario
  ,MAX(CASE WHEN sub = 'game_test_go' THEN 1 ELSE 0 END) AS flag_play_gtest
  ,MAX(CASE WHEN sub = 'practice_chall_f' THEN 1 ELSE 0 END) AS flag_play_pchall
  ,MAX(CASE WHEN sub = 'practice_training_go' THEN 1 ELSE 0 END) AS flag_play_ptraining
  ,MAX(CASE WHEN sub = 'map_json_user' AND action = '1' THEN 1 ELSE 0 END) AS flag_play_pmap
FROM
  `acts`
WHERE
  DATE_FORMAT(DATE(time),'%Y-%m-01') = '2020-09-01' # 9月に限定
GROUP BY
  date
  ,mn_id

2・1ユーザーごとのログから図式・文書化

ここで注意したいのは、「試合・特訓をどちらもプレイしていてほしい」という依頼者が見たいであろう意図を汲むことです。
試合・特訓の種類ごとに役割が異なるので、プレイしているユーザー層は違うことが予想されますが、今回はそもそもプレイしているんだっけ?ということが知りたいのです。

SELECT
  a.date
  ,COUNT(a.mn_id) AS count_uu
  ,AVG(CASE WHEN flag_play_gpractice = 1 OR flag_play_gsenario = 1 OR flag_play_gtest = 1 THEN 1 ELSE 0 END) AS per_play_game # 試合のうちいずれかをプレイ
  ,AVG(CASE WHEN flag_play_pchall = 1 OR flag_play_ptraining = 1 OR flag_play_pmap = 1 THEN 1 ELSE 0 END) AS per_play_practice # 特訓のうちいずれかをプレイ
  ,AVG(flag_play_gpractice) AS per_play_gpractice
  ,AVG(flag_play_gsenario) AS per_play_gsenario
  ,AVG(flag_play_gtest) AS per_play_gtest
  ,AVG(flag_play_pchall) AS per_play_pchall
  ,AVG(flag_play_ptraining) AS per_play_ptraining
  ,AVG(flag_play_pmap) AS per_play_pmap
FROM
  (
    SELECT
      DATE(time) AS date
      ,mn_id
      ,MAX(CASE WHEN sub = 'game_practice_go' THEN 1 ELSE 0 END) AS flag_play_gpractice
      ,MAX(CASE WHEN sub = 'senario_go' THEN 1 ELSE 0 END) AS flag_play_gsenario
      ,MAX(CASE WHEN sub = 'game_test_go' THEN 1 ELSE 0 END) AS flag_play_gtest
      ,MAX(CASE WHEN sub = 'practice_chall_f' THEN 1 ELSE 0 END) AS flag_play_pchall
      ,MAX(CASE WHEN sub = 'practice_training_go' THEN 1 ELSE 0 END) AS flag_play_ptraining
      ,MAX(CASE WHEN sub = 'map_json_user' AND action = '1' THEN 1 ELSE 0 END) AS flag_play_pmap
    FROM
      `acts`
    WHERE
      DATE_FORMAT(DATE(time),'%Y-%m-01') = '2020-09-01' # 9月に限定
    GROUP BY
      date
      ,mn_id
  ) AS a
GROUP BY
  a.date
ORDER BY
  a.date

下記のように出力できました。

データを見ていて気付い方かも居るかもしれませんが、
19日から20日に練習試合からシナリオへユーザーのプレイ傾向が偏りました。
これは、ゲーム内の仕様で練習試合の月次リーグ戦が20日の0時に終了するからです。
それ以降はプレイしてもランキングは変わらないので、シナリオに移行するユーザーも出てくるといった状況が、数値からも見て取れます。

おわりに

今回は行動ログから簡単な集計を行いました。
前提を定義し、なぜそうなるかを考えながら集計を行うという一連の流れを経験できたかと思います。

実際にユーザーが行動した生データですので、いろいろと利用できる方法はあると思います。
例えば、「アイテム課金するユーザーはどのような傾向にあるか。何をどれくらいプレイしていないと課金しないのか。」など、運営目線で言うと実際の売り上げにつながる分析が欲しいですよね。

あとは、「このデータがないと分析できないよ」という気づきもあります。
例えば、月1回の公式戦と呼ばれるトーナメント戦があるのですが、ログは公式戦閲覧しか取っておらず、閲覧ユーザーのチームが勝ったかどうか(または単純に他のチームが気になるから見ているか)はわかりません。
このゲームの中心として公式戦を位置付けているので、「公式戦を勝つために工夫するユーザー像」がプレイを継続するモチベーションではないかと。
それを分析できないのは、公式戦システムの都合もあります。

そのように、SQLを学び、考えるきっかけになれば幸いです。

反響があれば中級編に続くかもしれません。
今回は簡単な行動データのみでしたが、次回はスナップショットや選手データ、アイテム保有など組み合わせた複雑なデータを取り扱えればと思います。

SQLをさらに勉強したい方へのおすすめ図書


SQLをとりあえずガリガリ書けるようになりたいならこちら。技術的、ドメイン知識的な面は弱い。
テスト用のdokoQLの試行回数がもっと増えれば良いなと思います。


まさにオライリー。教科書。基礎はこれでOK。


分析技術寄りの本。入門書の次に買った方が良さそう。
10年戦えるかは置いといて良書。


実務を教えるときに使うならコレ。ドメイン知識寄りの本。
ただ、実務で使わない内容も多いため、こういったものがあるんだなと知るのにも便利。

[Meisyo] アップデート方針2020.10

今後のアップデート方針を記載します。中々今回もボリュームがありますね。

今後の方針

1・新規向け:新規登録後の継続者を増やす
 1・データ分析
  基盤ができているので、まずは離脱ポイントがないかか確認する。
  Lv1で止まる割合が下がったので、止まらないように対策をする。

2・既存の方向け:できることを増やす
 1・ストーリーモード再追加
  2章を追加する予定。
 2・デイリークエスト
  簡単にクリアできるものを複数(2~3個)行う。
 3・選手覚醒
  選手の能力値上限(S120)が取り払われる。カードの絵柄も変わる。
  上記の探索発見の特定NPCに勝利で入手可能に?(入手先は未設定です)
  1チームでの人数制限はなし。
  ※「低い基礎能力をある程度調整可能にさせる」は強すぎたのでなかったことに。

覚醒前 覚醒後

3・課金者の方向け:できることを増やす
 1・選手枠増加
  期限あり
  +10枠有償100P/30日
  (+10枠無償100P/14日)
  より多くの選手育成ができるようになる
 2・選手Exp増加
  期限あり
  100%UP有償500P/30日
  (100%UP無償500P/14日)
  より早く選手育成ができるようになる

4・未定
 1・探索 発見(vsNPC)
  アイテム類と同じように探索上でNPCに触れることで、特定のNPCに挑戦する権利を得る。
  挑戦は1発見1回きり。
 他の人に発見されている(7日間は権利保持)と挑戦できない、のような制限を付ける予定。
  勝てば様々な報酬があるかも?

その他
表示系の改善を色々と行いました。
新規登録で定着されつつある方が増えてとても嬉しいです。
追加したいものはあるけど、ゲームバランスがぶっ壊れそうなものが多いことに気付く・・・。

個人的に公式戦優勝したいorz

それではまた。

[Meisyo] 打撃・守備のバランス調整(v0.40)

変更概要

守備力を上方修正します。

詳細に言うと、OPSに対する影響度を、守備力=ミートまたは反応の有利な能力値にしました。
これまではOPSに対する影響は、守備力<ミートまたは反応の有利な能力値(2倍ほどミートまたは反応が有利)でした。

変更の根拠

現行バージョン(v 0.32)において過去の私のチームを使い、打撃データを分析すると以下のような関係性がわかりました。

実データはこちらからダウンロードください。

能力値1ポイントあたりのOPSへの影響度が、守備≦ミート(有利ではない)<反応(有利)でした。
※今回の実験では速球投手多めだったので、打者の反応がOPS増加に有利です。

想定では、ミート(有利ではない)<守備≦反応(有利)でしたが、そうなっていなかったので今回の変更により調整します。

上記結果を出した根拠としては、内野4選手または外野3選手の守備の能力値を変動させ、それ以外は固定させる方法での実験結果があります。

内野は、
(1)何もしない対照群、(2)4人とも守備力を+10にした群、(3)4人とも守備力を-10にした群で実験しました。

外野は、
(1)何もしない対照群、(2)4人とも守備力を+10にした群、(3)4人とも守備力を-10にした群で実験しました。

その結果、守備力が増加すればするほど相手チームのOPS(全体)が減ったので、以下の表にまとめました。
ミートや反応のOPS補正(個人)については、回帰分析で求めました。

変更後の計算値

守備速度(m/s) = 0.12 * (走力 + 守備力 * 4.5) / 4 + 7;
※守備力の係数を1.5倍にしました

変更前の計算値

守備速度(m/s) = 0.12 * (走力 + 守備力 * 3) / 4 + 7;

その他計算値

守備待機時間(s) = 0.2 – 0.002 * 反応
※投手は+1s、捕手は+2sされます。

最後に

外野より内野の守備力の方が重要だとわかったのは大きいかな。
内野より外野の方が守備範囲が広いので、私は内野<外野だと思っていました。

もしかしたら、内野を抜けるゴロを防げる確率が増えたのかもしれない。
ということは、、守備の重要度は二遊間>外野>一三かもしれない。
見た限り二遊ゴロ多いし。

今後は、勝っているときの守備固めが重要になってきそうだし、守備重視のチームもありかも・・・。
ただ監督指導Pリセットチケットと選手リセットチケットがない。困った。

注意点としては、バランス調整は見切り発車ですので、あまりにも強すぎる・弱すぎる場合は再度変更いたします。
コメントいただければ早急に対応できる可能性が高くなりますので、よろしくお願いいたします。

Webサイトの更新を続ける秘訣

何かを続けることって辛くありませんか?

実は・・・続けることに努力は必要ありません。
あなた自身に対して合う方法を設定すれば、うまくいきます。

更新を続ける秘訣

  1. 報酬を設定する
  2. やる時間を決める
  3. やらないことを決める

報酬を設定する

私の場合は、アクセス・PV数やコメントが更新の原動力です。

例えば、http://rei-farms.jp/だけで月30万PVほどあります。
(ゲームがあるので、一般のページより多くなる感は否めません。)

「自分が作ったサイトが、1日にだいたい1万ものページが見られている」と考えると凄くないですか?
これを1日100アクセスに到達した頃(いつだったか忘れましたが)から、この数値感を報酬として自分に与え続けてきました。

コレって凄いやんという自己満足ですね。

あとは、1ヶ月に1回くらいユーザーの方のコメントやTwitterでの連絡があるので、やってて楽しいなあと思ってます。

あなたはどんなことが嬉しいですか?
他人から認められることでしょうか?私はそうでした。

マズローの欲求5段階説(例:マズローの法則とは? 知っておくべき5つの「欲求」)から、あなたが満たされていない部分はどこか確認してみてください。

私は始めたときは、自己実現欲求と承認欲求が必要でした。
開始したのは20年前ですし、パソコンはマイノリティもいい所で・・・変なヤツのおもちゃとして扱われてましたしね。
パソコン(Win98ハイスペック)が家にある時点で金銭的余裕がある家庭でしたし、親も立派でした。(今も立派です)

今は、仕事で割とうまくできることが証明できているし、超苦手だった人付き合いもぼちぼちできているので承認欲求は別にもういいかなとは思っています。
そのため、必要なのは自己実現欲求だけかなと。
事業にできたら面白そうだなと言うことで、収益化を目論んで色々とやっています。

そのように、自身に対する報酬を設定してください。

すぐに見れて、わかりやすい指標があると続けやすいですよ!。

やる時間を決める

私は、1週間に土日13-14時で1時間はHP更新の時間を取るようにしています。

ヒトは触らないと楽しさを忘れるのです。

これまでで更新が止まった時が何度かありましたが、その時はすべてPCに一切触れていませんでした。

「楽しいからする」のではなく、「するから楽しさがわかる」という側面が強いです。
(不合理だと思いますが、ヒトは因果関係の錯誤を起こしやすいので、それを利用します。)

やらないことを決める

「そうは言っても時間がない」は本当でしょうか。

テレビやスマホをだらだらと見ている時間はありませんか?

私はテレビを意図的に見ませんし、スマホも仕事以外とある時以外ではほとんど触りません。
(ツイッターなどのSNSが厄介ですね。承認欲求解消のループなので。)

ある時とは、筋トレの時です。
私は、仕事でソーシャルゲームやサービスのコンサルティングをやっている都合上、更新情報や顧客体験をなぞることは欠かせません。
かつ、たまーにある炎上時に対応するために、身体的・精神的スタミナをつける必要があるので筋トレをしています。

ゲームはある程度放置できるものが多いので、そのクエスト開始から終了までの自動進行のスキマ時間を筋トレの1セットに当てています。

そのように、やらないことを決めると時間が捻出できます。
やるなら理由を作ってするのも重要ですね。もちろん時間を区切って。

そうすると、仕事上でも効率化を自然と意識できるようになります。
自分がやらなくていいことは徹底してやりません。時間の無駄です。

知識と経験がある、あなたがその業務をする明確な理由は存在するのでしょうか?
(上手く行かないとしても、)部下に任せればよいのではないでしょうか?
部下が業務をした後の訂正時間と、自分が取り組んだ場合はどちらが自分の時間を確保できるでしょうか?

部下はルーティンだけでいつも仕事が終わってませんか?
任せると部下のスキルアップにもなり、後々更に楽ができるので私は積極的に行ってます。
無茶振りと部下によく言われますが、「無茶振りだ」と上長に言える間柄だと仕事が楽ですよね。

その結果、私の現行業務は1日3時間も掛かりません。
その分、勉強時間も確保できますし、社外・社内への提案を考える時間も増えていきます。
言われたことをやっているだけではそれ以上の価値はありません。

効率化は一つの方法だけではなく、いろいろな方法を知っているからできるのです。
ただ、あまりにも効率化すると、プライベートと仕事の境目が無くなってくるのは厄介ですorz

「自分がうまくいく方法ってなんだろう?」って考えてみませんか?

[社内コンペ] 間取り予測

これは何?

某社で行われている社内コンペのメモです。私の備忘録でもあります。

結果:3位
精度:60.7%

今回は学習データが12,000件ほどあり、ある程度多いデータ量での学習ができました。
学習データは評価データと分布が同じとされていましたが、それはちょっと怪しかったかなと思います。

今回の目的変数

「その部屋が何の間取りに種別されるか」のテーブルデータの多値分類問題です。

回答は、
・3LDK
・2K
・1K
などとよくある形です。目的変数の種類が多い(最大38個)ことを除けば。

今回の評価指標・ベースレート

Accuracy(精度)です。

出題者によると、お試しの意味も込めてAccuracyだそうです。
普通なら複合指標による評価が妥当とされています。
Precision(適合率:真の陽性をいかに漏れなく見分けられたか)やAUC(認識性能の高低を表す)、MAP(Mean Average Precision、Precisionの応用)などなど。

ベースレートはAccuracy50%でした。

僕は、検証の際はAccuracyを用いていました。
今回は別の目的があり、全く工夫をしませんでした。

今回の説明変数の特徴

テーブルデータ

訓練に使用できるのは12,000データ

同じような目的変数がある

 3LDK、3DK、3K・・・違いが判らん!
 それらのデータの特徴量も似たようなものでした。
 つまり、ルールベースで分けたほうが精度が上がる目的変数のグループも存在しました。
 ルールベースで分けること自体はKaggleやSIGNATEではあまり言及されませんが、現場ではよく使われる手法です。実データはデータ量が足りない場合も多く、環境が整っていないからその手法採用されているだけで、本来のデータが潤沢にある状況であれば予測すべきです。

説明変数の作成が手入力(で雑)

 家探ししているとよく見かけるのですが、敷金、礼金は家賃の〇か月分ってありますよね?
 その値が手入力のようで、一致している場合もあればしていない場合もありました。

 例を挙げると以下のようになっていました。
 ・家賃:8万
 ・敷金(家賃の〇か月):2
 ・敷金額:12万円 ← What’s?????

今回の目標

特徴量生成のみで乗り切る。
(一応3位なんで乗り切れたと思いたい。)

今回行った特徴量生成の方法

データの適正化

手入力が多かったので上記のようなことが起こっていました。

グループ平均との差分を取り、標準偏差で表す

例えば、「その地域の家賃平均から高ければ高いほど、大きな部屋である可能性が高い」を数値化しました。

グループ内での順位を取る

上記と同じ考え方です。

業者の電話番号は業者ごとに存在すると考え、ラベルエンコーディングで特徴量化しました

建設業者はそれぞれの得意な分野(大きさ、形、場所)があり、棲み分けがされているようでした。
施設管理・施設設計をしていた経験からそう判断しています。施設の発注代がとても高かった記憶があります。(‘A`)

UMAPでの次元削減

t-SNEと同様でしたが、計算速度が速い・・・ハズ。
ただ、計算リソースが少ないPCだと結構エラーが出るので面倒でした。
Kaggleであった同様のコンペでは効果があったようですが、今回はあまり意味がなかったです。

K-Meansクラスタリングで教師なし学習結果を特徴量化

大分類で8クラスに分かれることが分かったので、それぞれの確率を特徴量としました。
あまり意味がなかったorz

その他の情報

モデル:XGB+LGBM(23:1)アンサンブルモデル
バリデーション方法:層別K-Fold(9:1)
パラメータチューニング:Optuna、Optuna LGB

その他の解法

パラメータチューニング

Kaggleで勝つデータ分析の技術P.318-320に載っているパラメータチューニング方法を、XGBにそのまま使うと大分上手くいったようです。

Optunaはベイズ最適化なのである程度は上手くいきますが、より精度を高めるのであれば手動をお勧めします。
それをしないと無理な境地がありそうです。
Deep Learningを含めて全部できるのはスゴイと思う。計算速度の良いPCが必要だ・・・お金足りないよ。
Optuna LGBは初めて使いましたが、Optunaに比べコードがかなり簡略化されており、初心者にも扱えそうで便利でした。

※個人的に、Kaggleはデータ分析というよりデータモデリングが主だと思っている。

スタッキング

よく使われるようになった手法。
ただし、今回はあまり効果がなかったようです。

※私は使ったことはない。

最後に

間取り予測して何に使うんですか?
目的がわかってない、分析では最悪なパターンです。

コンペに参加する目的が最近の手法の大枠を捉えなおすことなので、ボチボチ更新できたかなと思う程度でした。
日本語のはある程度読みましたが、海外の資料や論文は10も読まなかったかな。
この考え、動き方を社内でできる人を増やす方向で動いているので、あまり時間を割きたくないという理由もある。

やってみたではなく、何を考えたか、なぜそう考えたかを包括的に書いた記事が少ないので、少しずつですがアップしていこうと思います。
その他コードやデータサイエンス関連の質問はR:Twitterまでお願いします。

[Meisyo] ver 0.32 リリース情報と2020年4月以降の開発予定について

名将と呼ばれた者達をver 0.32にアップデートします。

更新概要

1・探索の追加
2・探索の追加に伴うゲームバランスの再調整

更新詳細

探索の追加

アイテムを発掘できる動的なゲームシステムを追加しました。
探索機能の詳細は[Meisyo] 探索をご覧ください。

監督・選手経験値獲得はできませんが、その分アイテムの獲得量を増やしています。

探索の追加に伴うゲームバランスの再調整

アイテム獲得量が探索によって増えることが想定されるため、各種アイテムの獲得量を再調整しました。
こちらは適宜変更していく予定です。

2020年4月以降の開発予定について

メインの方針としては、プレイ人口を増やすことに注力していきます。
そのため、基本的なゲーム動線の整備を再度行いたいと考えています。

大きくは、ストーリーや機能の説明を、それぞれのページで自動的に表示されるようにします。
ゲームとして色々な機能はあるものの、それぞれの機能の意味付けがわからないことが多いためです。
※データ分析から見えてきた課題です。この動線がゲームプレイの基本となり、ゲーム体験向上のためのデータ分析の基盤構築の基礎を作る前座となります。

新規実装

  1. ・探索
  2. VS NPC・ボスNPC

  3. ・挑戦
  4. 新NPC追加

  5. ・シナリオ
  6. 低難易度・中報酬のシナリオを追加予定
     春の甲子園がなくなったので地域オリジナル(初回は私の地元の奈良の予定)で作成します。

作者の現状認識

公式戦で優勝することを主体に、練習試合、連盟戦で他チームのユーザーといろいろ試行錯誤しながら、ゲームを進めていくことが楽しいと思っています。
あまり人と関わらなくてもいいし、関わってもいいゲーム体験です。基本はソロゲーですが。

ただし初心者に厳しい点が複数・・・、例えばシナリオの難易度が高すぎる点、特訓の内容(特訓、挑戦、探索)をどれを選んでいいかわからない点、UIや機能の説明がない点などがあります。
そのため、初心者から長く続けてプレイしていただくことが非常に難しいようになっています。

それぞれの機能の位置づけがわかれば、1年くらいは毎日プレイしても頭打ち感を感じにくい(何をしても強くなり、上手くいく)状態になるので、そこを目指したくなるようなゲームの見せ方に変えていきます。
見え方が違うだけで、サービスの体験が変わるのは本業でも経験しておりますので・・・。

あと、私事ではありますが、本業(コンサルタント:エンタメ業界担当)がマネジメント層に昇格した他に、副業(方針設定・アドバイザー?他雑務担当兼エンジニア:生物情報科学系)も始めたので、少々Meisyoの開発が遅くなる可能性があります。
申し訳ありませんが、末永くよろしくお願いいたします。