【教材紹介】前処理大全

前処理はデータ分析で重要な事項です。なぜなら、有用な特徴情報を上手く抽出できていなければどんなモデルであれ無用の長物です。ただ、前処理は体系だった学問としては存在せず、実務の中で学んでいくことが多いため、気づかずミスを犯していることが多いのです。

名称


前処理大全

データ分析のためのSQL/R/Python実践テクニック

著者

本橋智光

概要

本書は系統立てて前処理を学んでいきます。そこで、SQL/R/PythonのAwesomeなコードとNot Awesomeなコードの実例をもとに、Awesomeとは何かを考えます。

この本が理解でき、実践できるようになれば、データサイエンス初心者とは言えないでしょう。
*ただし、画像や音声、動画などの前処理は行いません。もちろん、発展的な時系列解析などの前処理も扱いません。

必要知識

入門程度のプログラミングの知識(関数等が分かる程度)
入門程度の統計学の知識(統計学3級程度)

得られるスキル

前処理, 抽出, 集約, 結合, 分割, 生成, 展開, Python, R, SQL
数値型の前処理, カテゴリ型の前処理, 日時型の前処理, 文字型の前処理, 位置情報型の前処理

その他の教材紹介ページはこちら → Skill Stacks

【教材紹介】BERTによる自然言語処理

自然言語処理の応用モデルであるBERTを今すぐに使いたい、機械学習の概要を知っている担当者レベルに向けた書籍を紹介します。

名称


BERTによる自然言語処理

著者

ストックマーク株式会社
近江崇宏、金田健太郎、森長誠、江間見亜利

概要

自然言語処理で難易度の高いタスクがあり、BERTを使うことでどうにかしたいという担当者向けの技術的な書籍です。
機械学習や自然言語処理の説明はそこそこに、BERTを自分で使えるようにするために色々なレクチャーが行われます。

必要知識

基本的な機械学習の知識(データ準備→学習→検証等)

得られるスキル

Python, Pytorch, BertModel, Tokenizer, 事前学習, ファインチューニング, 文章の穴埋め, 文章分類, 固有表現抽出, 類似文章分類

その他の教材紹介ページはこちら → Skill Stacks

【教材紹介】深層学習 2020年度春学期 · ニューヨーク大学データ・サイエンス・センター

米国大学のコンピューターサイエンスの講義を無料で、かつ日本語で公開されている教材がありましたので共有いたします。

名称

深層学習 DS-GA 1008 · 2020年度春学期 · ニューヨーク大学データ・サイエンス・センター

主催

ニュー欲大学データ・サイエンス・センター
Yann LeCun & Alfredo Canziani

概要

深層学習の最新技術(基礎・応用)について無料で学ぶことができる。
応用技術のベースとして、教師あり・教師なし深層学習、ベクトル埋め込みや距離学習の方法、画像認識で重要な畳み込みニューラルネットワーク(CNN)、時系列処理で重要な再帰型ニューラルネットワーク(RNN)、近年の自然言語処理の躍進を支えてきたAttentionなどを学ぶ。応用技術として、画像認識、BERTをはじめとした自然言語処理、グラフ構造ネットワークを予測するGCNなどを、理論だけではなくPythonのコードも記載されているため、動かしながら学ぶことができる。

必要知識

基礎的な機械学習及び数学の知識
・機械学習の流れが分かっていればOK
目的設定 → データ準備 → モデル設定 → 学習 → 検証
・大学教養課程の線形代数や微分
特に偏微分がふんだんに使われる

得られるスキル

深層学習, CNN, RNN, GCN, EBM, Attention, BERT, Auto Encoder

その他の教材紹介ページはこちら → Skill Stacks

【教材紹介】Python機械学習プログラミング(第3版)* 文量多め

今回の書籍は内容理解する難易度が高めですが、機械学習の基礎(用語・位置付け・アルゴリズム)が網羅できる、Pythonでの機械学習を学ぶためのおすすめ教材を紹介します。

正式名(ISBNコード)


[第3版]Python機械学習プログラミング 達人データサイエンティストによる理論と実践(ISBN978-4-295-01007-4)

内容量

648ページ

評価

総合評価

データサイエンティストになりたい方向けです。教材としては、機械学習の初歩からすべてを網羅的に説明している本です。網羅的であるため、内容量が圧倒的に多くなっています。プログラミングをしてみるだけではなくアルゴリズムの説明があるため、理解難易度は高くなりがちです。

注意したいことは、次の方は本書全てを読むことはおすすめしません。たとえば、専門分野や自分の仕事が確定していて、データサイエンスをビジネス活用したい人。
ただ、数学的な理論は読み飛ばすのであれば、ビジネス活用するための全般的な前提知識を得ることに適しているかと思います。つまり、コンサル会社や自社内のデータサイエンティストに仕事を委託するものの、中身はある程度分かっていたい方にもおすすめです。

評価:初学者

★☆☆☆☆
はっきり言って数学的な前提知識が多く、データサイエンティストになりたい人以外は難解な内容です。

評価:中級者

★★★★★
数学の基礎知識がある方には本書をお勧めします。その他の方では、機械学習に全体的に触れたあと、現場の知識をベースに理論で理解したい人におすすめです。

理解難易度

★★★☆☆
アルゴリズムの理解には行列、偏微分などの数学(線形代数)の知識が必要です。

必要知識

線形代数

行列(用語や基礎的な内容のみ)
偏微分
共分散

獲得可能スキル

技術

内容および獲得可能スキル

1.「データから学習する能力」をコンピューターに与える

基礎, 教師あり学習, 教師なし学習, 強化学習
基礎, 教師あり学習, 回帰, 分類
基礎, 分類, 二値分類, 多クラス分類
基礎, 回帰, 線形回帰
基礎, 強化学習
基礎, 教師なし学習, クラスタリング, 次元削減

2.分類問題-単純な機械学習アルゴリズムの訓練

人工ニューロン, パーセプトロン, アルゴリズム, 学習規則
線形代数, ドット積, 行列, 行列の転置, ベクトルの角度
Python, オブジェクト指向, Numpy, pandas, matplotlib
Irisデータセット
ADALINE, 勾配降下法, 偏微分, 標準化, バッチ勾配降下法, 確率的勾配降下法, オンライン学習

3.分類問題-機械学習ライブラリscikit-learnの活用

Python, scikit-learn, パーセプトロン, 正解率, 過学習, 決定領域
ロジスティック回帰, アルゴリズム, シグモイド関数, 尤度, 勾配上昇法
過学習, 正則化, バリアンス, バイアス, 共線性, L2正則化
サポートベクトルマシン, SVM, マージン, アルゴリズム, スラック変数, カーネルSVM
決定木, ランダムフォレスト
k最近傍法, 次元の呪い

4.データ前処理-よりよいトレーニングセットの構築

欠測値, CSV, pandas, DataFrame, dropna, 欠測値補完, 順序特徴量, 名義特徴量, one-hotエンコーディング,
データセット分割, 訓練データセット, テストデータセット, 標準化, 正規化, L1, L2
逐次特徴量選択アルゴリズム, 次元削減, knn, ランダムフォレスト, 特徴量の重要度

5.次元削減でデータを圧縮する

特徴量抽出, 主成分分析, 線形判別分析, カーネル主成分分析
主成分分析, アルゴリズム, 共分散,
線形判別分析, Linear Discriminant Analysis, LDA, scikit-learn
カーネル主成分分析, カーネル行列, カーネルトリック, SciPy, 射影

6.モデルの評価とハイパーパラメータのチューニングのベストプラクティス

ホールドアウト法, k分割交差検証, 復元抽出, 非復元抽出
層化k分割交差検証, バイアス, バリアンス, 学習曲線, 検証曲線
グリッドサーチ, 入れ子式の交差検証, 適合率, 再現率, F1スコア
混同行列, 真陽性, 真陰性, 偽陽性, 偽陰性, 誤分類率, 正解率
ROC曲線, 曲面下面積, 適合率-再現率曲線
マクロ平均法, マイクロ平均法, 一対全分類, クラスの不均衡

7.アンサンブル学習ー異なるモデルの組み合わせ

アンサンブル法, クラス分類, 多数決, 相対多数決
重み付け, Python, argmax, bincount
バギング, ブートストラップ標本
ブースティング, アダブースト, scikit-learn, 勾配ブースティング, XGBoost

8.機械学習の適用1-感情分析

自然言語処理, 感情分析, 極性, 書き手の意見, 意見マイニング
Bag-of-Words, BOW, TF-IDF
正規表現, トークン化, 英語, ワードステミング, NLTK, ストップワード
アウトオブコア学習, リカレントニューラルネットワーク, CountVectorizer, TfidfVectorizer, HashingVectorizer, Word2Vec
トピックモデル, Latent Dirichlet Allocation, LDA, Expectation-Maximization, EMアルゴリズム

9.機械学習の適用2-Webアプリケーション

SQLite, Flask, sqlite3, HTML, WTForms
モデル永続化, pickle
デプロイ, PythonAnywhere

10.回帰分析-連続値をとる目的変数の予測

回帰分析, 単線形回帰, 重線形回帰, 相関行列, 多項式回帰
リッジ回帰, ラッソ回帰, Elastic Net(L1+L2)
決定木回帰, 情報利得, ランダムフォレスト回帰

11.クラスタ分析-ラベルなしデータの分析

教師なし学習
k-means, k-means++
ハードクラスタリング, ソフトクラスタリング
エルボー法, シルエット分析
階層的クラスタリング, 凝集型, 分割型, 単連結法, 完全連結法
DBSCAN

12.多層人工ニューラルネットワークを一から実装

多層人工ニューラルネットワーク, バックプロパゲーション, フィードフォワード, アルゴリズム

13.ニューラルネットワークの訓練をTensorFlowで並列化する

TensorFlow, CUDA, OpenCL, テンソル
シグモイド関数, 双曲線正接関数, ソフトマックス関数, ReLU活性化関数

14.TensorFlowのメカニズム

計算グラフ, TensorFlow 1.X, TensorFlow 2.X, Keras
自動微分, 連鎖律, 損失関数
決定木ブースティング

15.画像の分類-ディープ畳み込みニューラルネットワーク

畳み込みニューラルネットワーク, CNN, サブサンプリング層, ドロップアウト
オプティマイザ, Adam

16.系列データのモデル化-リカレントニューラルネットワーク

リカレントニューラルネットワーク, T-BPTT, 系列データ, 再帰, LSTM
Transformer, Self-Attention, Multi-Head Attention

17.新しいデータの合成-敵対的生成ネットワーク

オートエンコーダー, AE, VAE, エンコーダ, デコーダ
GAN, 価値関数, バッチ正規化
全変動, KL情報量, JS情報量, EM距離, 勾配ペナルティ, DCGAN, モード崩壊

18.複雑な環境での意思決定-強化学習

強化学習, 環境, エージェント, 報酬, マルコフ決定過程, モデルフリー, モデルベース
動的計画法, モンテカルロ法, TD学習
グリッドワールド

補足

この本は文量が多すぎたため、他の教材では1分で読める文量にしています。

その他の教材紹介ページはこちら → Skill Stacks

Meisyo+とMeisyoのアクティブ人口比較

野球ゲームMeisyo+リリースから3か月目に入りました。


アクティブ人数(日ごとのログイン人数:DAU)を比較したところMeisyoを超えました。
IP等を見た限り、並行で遊んでいただいている方が多く、順調と思われます。

その原因としては、どうやら「ユーザーの知人紹介」で増えたようです。
※チャットにコメントが来てました。ありがとうございます。

認知度が限りなく低いので、少しずつ見えるところに置いていきたい・・・と思い色々試行錯誤中です。
チャネルを増やすってことですね。

より多くのユーザーの方に楽しんでいただけるよう更新を行っていきますので、コメント等もよろしくお願いします!

Flask-Babelを使って、Pythonアプリで多言語対応を行う

Pythonで多言語対応してみたいなーと思っていました。
思っていましたが、実際になかなか使うタイミングがない・・・。
今回自作ゲームでユーザー数の増加がみられ、かつ海外からのアクセスも複数確認できたので追加することにしました。

目的

名将と呼ばれた者達+のアクティブ人口を増やすために、少しアクセスがあった中国語と英語に対応する。

バージョン情報

flask-babel==2.0.0

作業

5が一番つらい

1. 翻訳ファイルテンプレート作成
pybabel extract -F babel.cfg -k lazy_gettext -o translations/base.pot .

2. 各言語の翻訳ファイルを定義
pybabel init -i translations/base.pot -d translations -l ja
pybabel init -i translations/base.pot -d translations -l en
pybabel init -i translations/base.pot -d translations -l zh
pybabel init -i translations/base.pot -d translations -l ko
# 日本語, 英語, 中国語, 韓国語に対応

3. テンプレートを翻訳ファイルに定義
pybabel update -i translations/base.pot -d translations

4. view, functions, templatesのファイルを書き換える
・view, functions
from flask_babel import gettext
gettext(”)

・templates
{{ gettext(”) }}

5. 各言語の.poファイルを書き換える
gettext(‘文字列’)内の文字列がリストアップされて、自分で翻訳文を書く。自動翻訳ではない。つらい。

6. .poファイルをバイナリ.moファイルに書き換える
pybabel compile -d translations

Flaskの構成


Flaskの詳細な構成については、VPSでつくるPythonでのWebアプリ運用環境(連載記事)をご覧ください。基本的な設計思考は同じです。

下記をapp.pyのreturn app前に定義してください。

    # 多言語対応
    babel = Babel(app)
    @babel.localeselector
    def get_locale():
        return request.accept_languages.best_match(['ja', 'ja_JP', 'en', 'zh', 'ko'])

※ja_JPがないとバグが起こる可能性もあるようなので追加しています
※ko(韓国語)は記載例。他の言語も同様に追加可能です。

どれだけ変わるの?

メイン画面で比較してみました。

日本語

英語


各ボタンのpossible要らないねえ…

中国語


ガバ翻訳すぎた

注意することは何?

コードの書き方です。
コードの書き方如何で作業量がかなり変動します…。

さいごに

今回はFlask-Babelで多言語対応を行いました。
目的はあくまでアクティブ人数の増加、それを目指すためのアクセス数の増加です。
そちらの続報については1~2か月後に記事を書きます。

[Meisyo+] データ分析その1 能力値ベースの打率予測

監督視点の野球ゲーム Meisyo+でデータが貯まってきたので、打率の予測をしてみました。

打率は高ければ高いほどいいですが、実際のところどの能力値を重要視していいかわかりません。
そのため、今回はどの能力値を重要視すれば、打率の向上によさそうかの判断基準を作りたいと思います。

使用データについては、ゲーム内の機能の分析室にデータ出力機能がありますので、そちらのデータと下記のコードを使うことで自分のチームの傾向を分析できるようにしています。

実験方法

コードの詳細については、Github:meisyo_analysis/ver1をご覧ください

使用データ

・選手の属性
・選手の能力値
・選手の打撃結果(集計値)

使用データの前提

野球は投手vs打者で打撃結果(打率含む)が決定しており、打者と投手の相性は少なからず存在します。(ように作ってます)
ただ今回は、選手の打撃結果が集計値のため、投手起因の値は丸め込まれていて予測できません。
つまり、野球でよく言われる「いい投手に対してかなりの打席数があったので、この打者の打率は低かった」や「この投手のカーブにこの打者は弱い」、「2ストライクになるとミートが下がるので打率が下がる」などは無視されています。
下記の結果は全体の傾向でしかない点にご注意ください。

使用データの対象

いつ?

2021/10/24現在の情報

どのチーム?

集計対象チームは、管理者(れい)のチームとNPCチームのみ。

どの球場?

全球場。
グランドの大きさ・フェンスの高さに違いがあるので、球場別に分析した方がいい気がする…。

何のデータをもとに?

選手の打撃に関わる属性値、能力値(合計値)

何を予測?

打率(回帰分析)
各種打撃結果の集計値はあるので、他の指標(OPSやWARなど)の分析は可能です。
※変数名が分からない場合はコメントください。テーブル定義書を作成します。

結果

示唆1:全体傾向

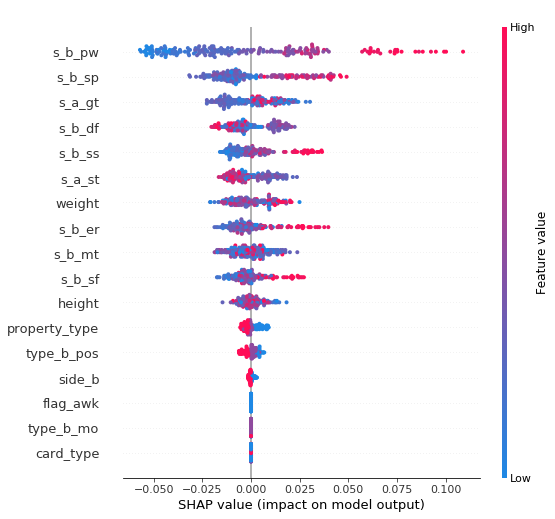
SHAPを利用して分析しています。

図の見方は、赤くなるほど打率が高く(青くなるほど低く)、右に行くほど変数の値も大きいです。
そのため、各説明変数がどのように目的変数に寄与しているか確認することができます。

効果がありそう:
パワー(b_pw)、走力(b_sp)、反応(b_ss)、エラー回避(b_er)
→ 当たり前の結果。
属性(property_type)、打席位置(type_b_pos)、打席(side_b)
→ 意味のある数字が出ているように見えるが、よくわからないので個別に確認する。

マイナスの効果がありそう:
体力(a_st)、守備(b_df)、
→ このステータスを重視すると、選手ごとの能力値の合計を一定にしているため、打率の向上に効果があるステータスが低下するためだと考えられる。

効果がなさそう:
根性(a_gt)、体重(weight)、身長(height)、肩力(b_sf)
→ 直接関係するところではない。
ミート(b_mt)
→ 驚くところかもしれないが、ゲームの進捗として変化量が多い投手が少ないのでまだ出番ではない。

変動なし:
覚醒有無(flag_awk)、打撃モーション(type_b_mo)、選手タイプ(card_type)
→ 打撃モーションは設定しているものの、未実装のため。

示唆2:個別傾向

詳細は上記Githubの分析コードファイルでご覧ください。

属性(property_type):
心(H)技(T)体(B)のうち、なぜか体が有利。
投手に有利属性の心(H)が多いからか?(データはない)

打席(side_b):
左打席の方が一塁に近いため、ほんのちょっと出塁しやすい。

打席位置(type_b_pos):
前(F)中央(C)後ろ(R)のうち、なぜかCが有利。
後ろは速球に対して反応しやすいが、変化球に弱くなりがち。→速球投手が居ないので、今のところ出番がない。
前は速球に弱いが、変化途中を打つので大きな変化球に対応しやすい。→大きな変化球を持つ投手がほぼいない。
なるほど・・・その結果、中庸の中央が強いのか。

身長・体重:
まだ試合に反映していません・・・。

まとめ

意外や意外、打率にはミートがほとんど寄与していない傾向にあることがわかりました。
今のところパワー is 力になっていますが、投手が育ってくると速球・変化球のどちらか、またはどちらもに対応する必要が出てくるため、ミート(変化球)と反応(速球)が必要になってきます。

ただし、打撃ばかりに注力していると守備特化や走塁特化にボロボロにされる現象が出てきます…。
NPC早波高校が良い例だと思います。あいつらは強い。
どちらかというと現状は守備を優遇した計算にしているつもりですが、バランスが悪い場合はバランス調整が入る可能性があります。

それでは、また~(^^ノ

Appendix

Light GBM sample_weightの有効性確認

有効性があると考えられる結果となりました。
詳細は上記Githubの分析コードファイルでご覧ください。

コードの記法

    # btr_pa(打数:重み)を取得する
    X_train_weight = X_train['btr_pa']
    X_train = X_train.drop(columns=['btr_pa'], axis=1)
    X_valid = X_valid.drop(labels=['btr_pa']) # X_validがSeriesのため、dropの記法が独特

    # lgb
    lgb_train = lgb.Dataset(X_train, y_train, weight=X_train_weight)
    lgb_valid = lgb.Dataset(X_valid, y_valid)

    # model
    model = lgb.train(params, lgb_train, num_boost_round=num_round)

weight=X_train_weightだけでいいのか・・・うせやろ・・・。
logistic_regression等にもsample_weightは実装されています。他のモデルでも使える普遍的な考え方ということですね。

結果

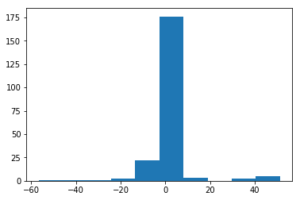
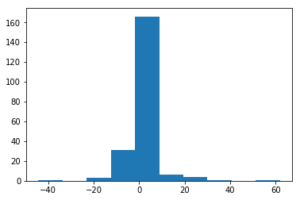
dw = diff(打率と予測打率の誤差) * weight(打数)として重み付けをした誤差で、どちらのモデルの方が予測精度が良い(=誤差が小さい)のか判定した。

sample_weightなし

図は各サンプルの誤差の分布を示しています。

MEAN: 0.6766849656317994
MAE: 4.013002739923537
STD: 10.142118959652125

sample_weightあり

図は各サンプルの誤差の分布を示しています。

MEAN: 0.614371189810878
MAE: 3.328403506460046
STD: 7.6495407120552015

補足1

理想的にはdwは0になるといい。
ただし、そんなことはあり得ないので打数で重み付けして、打数が多い場合の誤差に罰則を大きくしている。

補足2

sample_weightの重要性は最近下記の本で目覚め、
お仕事(DX人材教育(ライフサイエンス系))で、この疾病の予測で重要視すべき患者はどの人か?などの回答に使えると思っています。使い方としてはアンダーサンプリングしない不均衡データ予測、計算方法はIPWなどとよく似ている…?似てないか。

その他のお仕事でもsample_weightを導入することで、予測精度の改善に寄与することを確認しました。

補足3

sample_weightの考え方は重要度が増してくると思うので、再度調べて記事を書きたいと思います~。
どうすれば上手く使えるかなあ。

(VPSでつくる) セキュリティ設定

連載第十四回目です。

セキュリティ設定について何もわからん状態なので色々と漁っていました。
PythonやFlaskなどの個別のモノに対してのセキュリティ設定の書籍は中々多くないので、Linuxなどの基礎的なセキュリティ設定について学習する方がいいと思われます。

その学習には下記のようにシステムの構成図を書いて、どこがセキュリティを設定しきれていないか確認しながら進むといいでしょう。

抜け道で言うと、プロに聞くのが最短ですね。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

すべての基本

バージョンアップしよう。
基本的に、脆弱性はバージョンアップすると減る。

CentOS7のセキュリティ設定

参考記事:接続時のセキュリティの設定(CentOS 7)(さくらVPS設定マニュアル)

1. さくらVPSのデフォルトではファイアウォールが起動されていないことがある。

ファイアウォールの起動コマンドは下記の通り。

systemctl start firewalld

さくらVPS独特のパケットフィルタという厄介な設定もあるので注意。

2. ファイアウォール中にサービスの利用を許可するコマンドを使わないと、自作のサービスが動かない

ファイアウォールの許可を追加するコマンドは以下の通り。

firewall-cmd --permanent --zone=public --add-service=許可するサービス名

許可を追加しても、ファイアウォールをリロードしないと設定は反映されません。

参考記事:サーバ作成直後に設定しておくべき初期セキュリティ設定(さくらのVPS)

本来の参考記事はさくらVPSでDjangoアプリを公開する手順の備忘録(note:夕月悠里さん)ですが、公式がベースになっているので記載。

  1. ROOTユーザーは使わない
  2. SSH接続用の公開鍵暗号方式を使う
  3. HTTPS(SSL)使おうぜ
  4. HTTPSに必要な独自ドメインは無料で取れるサービスもあるし、HTTPSでないと安全でないサイトと表示されるのでやりましょう。
    → 記事参照:Let’s EncryptでVPS上のWebサイトをSSL(HTTPS)接続にしよう

あくまで基本やけど、個人開発で全部をカバーできている所は多くない気がする。

Nginxのセキュリティ設定

表示

1. レスポンスにNginxのバージョンを表示させない。

Nginx設定ファイル(/etc/nginx/conf.d/default.conf)に下記を追加。

http {
    server_tokens off;
}

バージョン情報=脆弱性情報ですからねえ・・・。

FTPのセキュリティ設定

ファイル送信にはSFTPかSCPを使おう。

Pythonのセキュリティ設定

Python2はやめてPython3を使おう。
かつ、メジャーバージョンでもできるだけ新しいバージョンを使おう。

そのためには、Nginx Unitさんは早く、公式でPython3.6.8以外の対応をできるようにすべき。Dockerでどうにかなるらしい(未確認)が面倒。
GunicornやuWSGIは、バージョンを気にしなくてOKなのが楽。ただしWindows上では試験的に使えないのは面倒。WSL2等で特別に設定すればできるが面倒。

Flaskのセキュリティ設定

参考記事:Flaskのセキュリティ対策(simon’s noteさん)

特に注意すべきは下記3点。1番が一番抜けやすい気がする。

  1. 自分で変数を埋め込んだHTMLを用意する場合にはescapeを使う
  2. コンテンツセキュリティポリシー(CSP)
  3. X-Content-Type-Options

Flaskバージョンアップ

Flask2が出たのでそちらを使った方がいいかもしれない。

Flaskのセキュリティ設定に関するバグ(?)

1. データベースとの通信に使うapp.SECRET_KEYの乱数生成文字列の設定に要注意

CentOS7+Python3だとデフォルトはascii。
asciiで対応できない文字列(例:日本語等)を入れると、エラーは表示されないが、ログイン時のクッキー操作等に異常が出る。

記事13で行った、文字コードのデフォルト設定をUTF-8にすると解決する。

phpMyAdminのセキュリティ設定

最低限、アクセス可能IPを制限する必要がある。
ディレクトリ名をphpMyAdminにしない。

おわりに

色々調べてみましたが、セキュリティ設定は難しい。。
不足している観点があればURLだけでもコメントいただけると幸いです。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次回以降は上記記事からご覧ください。

(VPSでつくる) Socket通信を使ったモダンなチャットアプリをFlaskで作ろう

連載第十三回目です。

今回は、チャットアプリを作っていきたいと思います。
チャットの想定としては、会員制、socket通信で滑らかにチャットできる、データベースにログを残すにしましょう。

ただのチャットとは言え、使いやすさも考えて構築を行います。
そのため、HTML、JavaScript(jQuery含む)、CSSなどでの記載も行います。
ただし、理解が簡単になるよう、コメントを多めに書いています。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

作業予定

まず、テストアプリプログラムファイルのダウンロードが必要です。
Github(https://github.com/R2002/flask_chat)
テストアプリフォルダ(app/flask_chat)は、VPS上の/usr/share/nginx/app/flask_chatにアップロードします。

作業予定としては以下を想定しています。
・Gunicorn+eventletの設定
・CentOS7日本語対応
・チャットアプリのsystemd上でのサービス化
・Nginxの設定
・公開(デプロイ)

socket通信には、Gunicornやeventletなどのサービスが必要になります。Webサーバー兼リバースプロキシのNginxだけでは対応できません。
そのため、いろいろと設定が必要になります。

続いて、どのような思考でそれぞれのプログラムが書かれているのか確認します。

構成


このアプリは、チャットアプリです。
滑らかなチャットを行うためにsocket通信を使います。

socket通信の担い手はWSGIサーバーであるGunicorn、その一機能のeventletです。
前回のアプリまで使っていたNginx Unitは、eventletに関する資料がなかったので使いませんでした。

ファイル構成


ファイルごとに関係を示します。

前回と比べconfig.pyなどが増えましたが、設計思考は同じです。
viewsとmodelsをディレクトリ化したのは、機能の増加を何度か行い記載量が増えた際に、コーディングの状況が一人開発ですら分かり辛くなるからです。例えば、app.pyにviewsの記載をべた書きしていると、複数人での開発は困難になります。

ディレクトリを分けることによって、機能の一時停止判断や、バージョンアップ・ダウンの切り替え作業が非常に簡単になります。

なお、Flaskアプリの起動にはrun.pyを利用しています。
すべてのファイルは、run.pyから見た絶対的または相対的な記述が必要です。
例えば、importやfromで指定するディレクトリはどこか、パスはどう記載しなければ動かないか等です。

Gunicorn+eventletの設定

flask-socketioの公式を参考にします。

まずは、仮想環境(/usr/share/nginx/venv/flask_chat)を作り、その環境上でgunicornなどをインストールします。
gunicorn以外は、テストアプリに含まれるrequirements.txtをご利用ください。

pip install gunicorn==20.1.0

※バージョンは変更して問題ありません。

最後に、アプリフォルダ(/usr/share/nginx/app/flask_chat)に移動して、gunicornでflask_chatを起動します。

gunicorn -k eventlet -w 1 run:application

ちなみに、Windows上ではgunicornは動きませんのでご注意ください。

CentOS7、Windowsどちらでも動く下記コマンドは優秀ですね!

python run.py

何度かテスト立ち上げをしていると、ポートはもう使われているというエラーが出ます。
その場合はポートを開けるために、プロセスを停止させる必要があります。

プロセスの検索は下記コマンドを利用します。

ps ax

pythonのプロセスを探して、PIDを指定します。

kill -9 [該当のPID]

CentOS7日本語対応

CentOS7はそのままの設定だと言語が英語になっています。
チャットでは日本語を使うのですが、チャット内容に日本語を含む場合エラーが発生します。
エラーが起こらないよう、言語設定を変更していきます。

まずは、環境変数(LANG)を確認します。
LANG=C(英語)となっていると思います。

env

設定ファイルも確認しておきましょう。

less  /etc/locale.conf

次に、使える言語を確認します。
ja_JP.utf8があるか確認してください。

locale -a

最後に、下記コマンドで設定を書き換えます。

localectl set-locale LANG=ja_JP.utf8

これで日本語入力ができるようになりました。

失敗例

下記ファイル群を書き換えても意味がありません。
~/.bash_profile
~/.bashrc
~/.profile

下記コマンドもシェル上だけで有効で、systemd上のサービスにすると日本語にエラーが出ます。

export LANG=ja_JP.utf8

チャットアプリのsystemd上でのサービス化

それでは、デプロイのために色々と設定を行っていきましょう。

Gunicorn

gunicorn.conf.pyを下記の通りに作成します。

workers = 1
worker_class = 'eventlet'
bind = 'unix:/run/flask_chat.socket'

上記のファイルは、以下のようにコマンド上で利用します。

gunicorn run:application --config gunicorn.conf.py

worker_classは、eventletかgeventを指定します。
bindは、どこのポートまたはソケットで立ち上げるかを設定します。今回はソケットを使います。
workerについては、CPU1個あたりworkerを2~4個用意するのがいいようです。1個だとたまにチャットのメッセージが消えます。

CPU数を出力するには下記コードをpythonインタプリンタ上で使用してください。

import multiprocessing
print(multiprocessing.cpu_count())

serviceおよびsocketの準備

flask_chat.serviceとflask_chat.socketを用意します。
※settings_envフォルダに入っているのでアップロードしていただいてもかまいません。

flask_chat.serviceの内容は下記の通りです。

[Unit]
Description=flask_chat daemon
Requires=flask_chat.socket
After=network.target

[Service]
User=root
Group=root
RuntimeDirectory=gunicorn
WorkingDirectory=/usr/share/nginx/app/flask_chat/
ExecStart=/usr/share/nginx/venv/flask_chat/bin/gunicorn --config /usr/share/nginx/app/flask_chat/gunicorn.conf.py run:application
ExecReload=/bin/kill -s HUP $MAINPID
ExecStop=/bin/kill -s TERM $MAINPID
KillMode=mixed
PrivateTmp=true
Restart=always

[Install]
WantedBy=multi-user.target

注意すべき点は、ExecStartを仮想環境上のgunicornに指定することです。
venvを直接指定しなくても、勝手に良い感じに読み込みをしてくれます。

flask_chat.socketの内容は下記の通りです。

[Unit]
Description=flask_chat socket

[Socket]
ListenStream=/run/flask_chat.socket

[Install]
WantedBy=sockets.target

2つのファイルをアップロードして、下記コマンドで指定位置にコピーします。

cp flask_chat.service /etc/systemd/system/flask_chat.service
cp flask_chat.socket /etc/systemd/system/flask_chat.socket

サービス起動

下記コマンドでサービスを自動開始設定・開始します。

systemctl enable flask_chat.socket
systemctl start flask_chat.socket

※socketを起動すると、自動的にflask_chat.serviceが起動するのでコマンドは不要です。

最後に、動作確認を行います。

curl --unix-socket /run/flask_chat.socket localhost

エラーが出ずに、HTMLが返ってくれば設定は完了です。

Nginxの設定

Nginx Unit設定ファイル(/usr/share/nginx/conf.json)を下記の通りに変更します。
使わないので空にしましょう。

{
    "listeners": {
    },

    "applications": {
    }
}

設定を反映します。

sudo curl -X PUT --data-binary @/usr/share/nginx/conf.json --unix-socket /var/run/unit/control.sock http://localhost/config
systemctl restart unit

Nginx設定ファイル(/etc/nginx/conf.d/default.conf)のlocationを変更します。

location / {
    proxy_set_header Host $host;
    proxy_pass http://unix:/run/flask_chat.socket;
}

再起動させましょう。

systemctl restart nginx

公開(デプロイ)

上記の手続きが問題なければアプリが起動すると思います。
おつかれさまでした。

あとは、前回と同様にデータベース(flask_chat)を用意しておく必要がありますが、今回は説明を割愛します。

問題がなければ、下記のように別ブラウザおよび別IPからで滑らかなチャットを行えます。

socket通信で問題となる、ブラウザ上では通信確立が上手くできたかわからないについても、通信が確立されるまではチャットを表示しないようにしています。

おわりに

今回は、socket通信を使った滑らかなチャットが可能なアプリをデプロイまで持っていきました。

次回以降は、これまで全く考えられていなかったセキュリティ設定等を行っていきます。
アプリをデプロイしても、頻繁に落ちたり、個人情報が取られたり・・・可能性は十分あり得ます。
そのため、HTTPS(SSL)接続などの設定も行います。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次回以降は上記記事からご覧ください。

(VPSでつくる) Python(Flask)でMariaDB(MySQL)へ接続できるアプリをもっと読みやすく改良してみよう

連載第十二回目です。

前回の記事で、Python3.6.8+FlaskでMariaDBに接続・データベースを編集するアプリを動作させる設定を行い、動作確認しました。

今回は、機能は前回と全く同じアプリを、もっと簡潔に読みやすく記述する方法を説明します。
コーディングの解説のみで、アプリの動作確認等は行いません。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

作業予定

まず、テストアプリプログラムファイルのダウンロードが必要です。
Github(https://github.com/R2002/flask_db_blueprint)

続いて、どのような思考でそれぞれのプログラムが書かれているのか確認します。

構成

このアプリは、データベース(MariaDB)を変更するアプリです。

HTTP接続でWebサーバ(Nginx)にアクセスし、APサーバ(Nginx Unit)を介してPythonアプリをvenvで起動しています。
Nginx UnitでのPythonのバージョンは導入が簡単なので3.6.8を選択しました。
phpMyAdminはWebサーバ(Nginx)上のPHP-FPMで動かしています。

このように図解することで、どんなアクセスに対し、それぞれの機能が対応しているかを分かりやすくしています。

ファイル構成

ファイルごとに関係を示します。
viewsとmodelsをディレクトリ化したのは、機能の増加を何度か行い記載量が増えた際に、コーディングの状況が一人開発ですら分かり辛くなるからです。例えば、app.pyにviewsの記載をべた書きしていると、複数人での開発は困難になります。

ディレクトリを分けることによって、機能の一時停止判断や、バージョンアップ・ダウンの切り替え作業が非常に簡単になります。

なお、Flaskアプリの起動にはrun.pyを利用しています。
すべてのファイルは、run.pyから見た絶対的または相対的な記述が必要です。
例えば、importやfromで指定するディレクトリはどこか、パスはどう記載しなければ動かないか等です。

ディレクトリ構成

前回に比べて、ディレクトリは増えましたが機能は変わっていないので、理解はそこまで難しくないと思います。

/usr/share/nginx 
 ┗ app アプリ用ディレクトリ
 | ┗ flask_db_blueprint テストアプリ用ディレクトリ
 |   ┗ models データベースモデル設定用ファイル(旧:models.py)
 |   ┗ templates HTML設定用テンプレートファイル
 |   ┗ views ビュー用ファイル(旧:app.py内に記載)
 |   ┗ app.py アプリ本体
 |   ┗ config.py 設定ファイル
 |   ┗ database.py データベース用関数ファイル
 |   ┗ run.py 起動ファイル
 ┗ venv 仮想環境用ディレクトリ
   ┗ flask_db テストアプリ用環境(前回アプリとインストール内容は同じ)

コード解説

それではflask_db_blueprintのディレクトリ内にあるファイルを一つずつ、コードを解説していきます。

run.py

オンラインではNginx UnitからWebアプリを起動するため、ローカルではflaskでローカルサーバーを起動するためのファイルです。

from app import app as application

if __name__ == '__main__':
    application.run()

Nginx Unitのデフォルトでは、application.run()が必要です。
そのため、app.pyを呼び出して、appをapplicationにエイリアスを変更してからrun()を行っています。
※conf.jsonの個別のapplicationのcallback属性でエイリアス(application)の変更が可能です。

app.py

run.pyから呼び出されるファイルです。
アプリ設定(Flask、設定、DB)の基本的な流れが書かれています。

from flask import Flask
import config, views
from database import init_database

# create_app
def create_app():
    # Flask定義
    app = Flask(__name__)
    # 設定反映
    app.config.update(config.cf)
    # DB設定
    init_database(app)
    return app

# app
app = create_app()

# Blueprint
# データベース参照(view): views/index.py
app.register_blueprint(views.index.app)

# 一行追加(insert), 一行変更(update), 一行削除(delete): views/database.py
app.register_blueprint(views.database.app)

create_appでアプリ設定をした後に別で表示用にBlueprintを定義することで、
・アプリとして起動したい場合は、ファイル全体を呼び出す。
・アプリのDB初期設定を行いたい場合は、app.pyのcreate_appのみを呼び出す。
という使い方が可能になります。

config.py

アプリの設定を全て統括するファイルです。
今回は追加していないですが、画像・JavaScript・CSSなどの静的ファイルのディレクトリ設定(絶対パス・相対パス問わない)などを設定すると良いかと思います。

import os

#--------------------------------------#
# 設定ファイル
#--------------------------------------#
cf = {} # 削除しないでください

# Flaskのデバッグ表示を有りにする
cf['DEBUG'] = 1

# DB設定
cf['SQLALCHEMY_DATABASE_URI'] = 'mysql+pymysql://{user}:{password}@{host}/{db_name}?charset=utf8'.format(**{
    'user': os.getenv('DB_USER', 'root'),
    'password': os.getenv('DB_PASSWORD', ''),
    'host': os.getenv('DB_HOST', 'localhost'),
    'db_name': 'flask_db_blueprint',
})

# TRACK_MODIFICATIONSを無効にしておく
cf['SQLALCHEMY_TRACK_MODIFICATIONS'] = False

database.py

DBの読み込み設定を行っています。
今回はflask_SQLAlchemy(DB接続方法)とflask_migrate(DB更新方法)を規定しています。
その他には、init_database()などの関数を定義しておくことで、DBロジックの変更に対して、このファイルの書き換え行うだけで対応が可能になります。

from flask_sqlalchemy import SQLAlchemy
from flask_migrate import Migrate

# DB規定
db = SQLAlchemy()

# db初期設定
def init_database(app):
    db.init_app(app)
    Migrate(app, db)

# 追加または更新
def db_insert(data):
    db.session.add(data)
    db.session.commit()

# 削除
def db_delete(data):
    db.session.delete(data)
    db.session.commit()

おわりに

今回はflaskアプリの中身について解説しました。
どう動いているのか、なぜこのような記載方法になっているのかを知ることで、このアプリではない他アプリをどう作るべきか考えるのに役立てれば幸いです。

その他にも下記のようなページが参考になります。
・【Flask】ディレクトリ構成を考える

次回は、このアプリを元に、Socket通信を用いた軽量チャットアプリを作成します。
Webアプリ(Flask)+Socket通信はまとまった解説がなく、かなり理解に時間が取られてしまったので、後の方はもっと楽してほしいなーと思っています。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次は、13. Socket通信を使ったモダンなチャットアプリをFlaskで作ろうです。