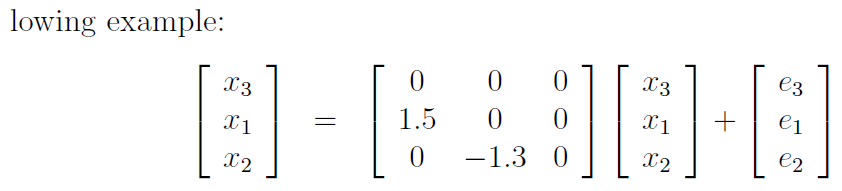
(VPSでつくる) PythonでMariaDB(MySQL)へ接続できるアプリを触ってみよう

連載第十一回目です。

Python3.6.8+FlaskでMariaDBに接続・データベースを編集するアプリを動作させる設定を行い、動作確認します。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

作業予定

作業予定としては、下記のアプリを作っていきます。
まず動かしてみて、その後でFlaskの各関数が何をしているか解説していきます。

ディレクトリ構成

/usr/share/nginx 
 ┗ app アプリ用ディレクトリ
 | ┗ flask_db テストアプリ用ディレクトリ
 |   ┗ app.py アプリ本体
 |   ┗ config.py 設定ファイル
 |   ┗ database.py データベース用関数ファイル
 |   ┗ models.py データベースモデル設定ファイル
 |   ┗ run.py 起動ファイル
 ┗ venv 仮想環境用ディレクトリ
   ┗ flask_db テストアプリ用環境

機能

・データベース参照(/)
・1行追加(/insert)
・1行変更(/update)
・1行削除(/delete)

作業内容

まず、テストアプリプログラムファイルのダウンロードが必要です。
Github(https://github.com/R2002/flask_database_test)
アップロードして使用しますので、適宜内容を見てご利用ください。

まずは、ディレクトリを移動します。

cd /usr/share/nginx

次に、アプリ用ディレクトリを作ります。

mkdir app/flask_db

仮想環境を作り、その仮想環境に入ります。

python3 -m venv venv/flask_db
source venv/flask_db/bin/activate

pipをアップグレードしておきます。

pip install --upgrade pip

ダウンロードしたファイルの中にあるrequirements.txtアップロードし、テストアプリに必要なPythonモジュールを下記コマンドでインストールします。仮想環境上でインストールするようにしてください。

pip install -r requirements.txt

ファイルをアップロードできない場合は、パーミッション変更を下記の通り行ってみてください。

chmod 0777 /usr/share/nginx

requirements.txtファイルの内容は以下の通りです。

flask==1.1.2
flask-sqlalchemy==2.5.0
SQLalchemy==1.3.23
pymysql==1.0.2
Flask-Migrate==2.7.0

簡易アプリ(main.py)作成し、複数アプリを同時並行でNginx Unitでデプロイできることを確認します。
まずは、アプリ用ディレクトリに移動します。

cd app/flask_db
[python]

続いて、<strong>main.py</strong>を作成します。
[python]
from flask import Flask

application = Flask(__name__)

@application.route('/')
def index():
    print('test')
    return "Hello Flask"

if __name__ == '__main__':
    application.run()

/usr/share/nginx/conf.jsonを編集し、flask_testに加え新たなアプリ(flask_db)を起動できるようにします。

{
    "listeners": {
        "*:8081": {
            "application": "flask_test"
        },
        "*:8082": {
            "application": "flask_db"
        },
    },

    "applications": {
        "flask_test": {
            "type": "python 3.6.8",
            "path": "/usr/share/nginx/app/flask_test/",
            "home": "/usr/share/nginx/venv/flask_test/",
            "module": "main"
        },
        "flask_db": {
            "type": "python 3.6.8",
            "path": "/usr/share/nginx/app/flask_db/",
            "home": "/usr/share/nginx/venv/flask_db/",
            "module": "main"
        },
    }
}

Nginx Unitの設定を更新します。

sudo curl -X PUT --data-binary @/usr/share/nginx/conf.json --unix-socket /var/run/unit/control.sock http://localhost/config

Nginxの設定ファイル(/etc/nginx/conf.d/default.conf)に下記を追記します。

    location /flask_db/ {
        proxy_pass http://127.0.0.1:8082/;
    }

再起動をしてみましょう。

systemctl restart nginx
systemctl restart unit

下記のURLでアクセスできるようになります。
http://XXX.XXX.XXX.XXX/sample/
→ 前回のテストアプリ
http://XXX.XXX.XXX.XXX/flask_db/
→ 同じようなテスト用アプリ

今後は、flask_dbを改良していきます。

それでは、ファイルアップロードのためのパーミッション変更を行います。

cd /usr/share/nginx
chmod 0777 app/flask_db

flask_db内にファイルをアップロードします。

conf.jsonを編集し、applicationsのflask_db、moduleをmainからrunにしてください。

{
    "listeners": {
       # 略
    },

    "applications": {
        "flask_test": {
           # 略
        },
        "flask_db": {
            # run
            "module": "run" # ここだけ変更
        },
    }
}

Nginx Unitの設定を更新します。

sudo curl -X PUT --data-binary @/usr/share/nginx/conf.json --unix-socket /var/run/unit/control.sock http://localhost/config

phpMyAdminで、新しいデータベースflask_dbを作っておきます。照会順序はutf8_general_ciで問題ありません。
http://XXX.XXX.XXX.XXX/phpMyAdmin/

最後に、アプリ設定ファイル(app/flask_db/config.py)を編集し、phpMyAdminで設定したユーザーのパスワードを記載します。

再起動をしておきましょう。

systemctl restart nginx
systemctl restart unit

ここまでで設定は終わりです!
おつかれさまでした。

あとは実際にアプリを触っていきます。

まず、データベースをcreateします。
そのためにflask_db仮想環境に入っておき、ディレクトリを/usr/share/nginx/app/flask_dbに移動します。

続いて、pythonコマンドでPythonインタプリンタを起動し、下記コマンドを入力します。

from app import create_app
from database import db
db.create_all(app=create_app())

データベースの内容(testテーブル)ができたことを確認してください!

続いて、データベースのMigrate(差分保存)初期設定を行っておきます。
Pythonインタプリンタから出て、下記コマンドを実行します。

set FLASK_APP=run.py
flask db init

※Migrateについての詳細は、Flask-migrateをご覧ください。

それではWebサイトにアクセスします。
まずはトップページ(/flask_db/)を確認します。

まだデータが入っていないため、テーブルは空です。
※このトップページはphpMyAdmin(flask_dbのtestテーブル内)と同じ表示になります。

では、データを入れていきましょう。
データ追加は、/insert/<入れたい値>にアクセスしてください。
テストでは100, 200, 300, 400, 5000の5つの数値をそれぞれ入力しました。

トップページ(/flask_db/)を確認すると、下記のようにデータベースに行が追加されました。

続いて、特定のidの値(data)を更新していきます。
更新は、/update/<id>/<変更したい値>にアクセスしてください。
テストでは/update/3/0, /update/4/100にアクセスしました。

トップページ(/flask_db/)を確認すると、下記のようにデータベースのid3および4の値が変更されました。

最後に、特定のidを削除します。
削除は、/delete/<id>にアクセスしてください。
テストでは/delete/3にアクセスしました。

トップページ(/flask_db/)を確認すると、下記のようにデータベースのid3が削除されました。

これにてテストアプリのテスト起動は終了しました。

締めに、アプリの解説を行います。
アプリの構造は以下の通りです。
HTTP接続からNginx、NginxからNginx Unit、Nginx Unit上でvenvを使ってアプリを起動し、MariaDBにアクセスする方法を取っています。

ファイルの内容については以下の通りです。
app.pyがアプリ本体です。conf.jsonに指定したrun.pyは起動用のアプリであって本体ではありません。

このような構成にすることで、ファイルごとに役割分担を明確にしています。かつ、Nginx Unit以外のAPサーバー(例:uWSGI)などでも動かせるような構成となっています。

おわりに

PythonでMariaDB(MySQL)へ接続できるアプリを触ってみようということで、今回いろいろと設定を行いました。
このアプリをWebサーバー上で起動できれば、その他の応用アプリも起動が可能になります。

ただ、当アプリはapp.pyにルーティングや表示のコードが記載されているため、このまま記載を続けるとapp.pyのコード量が肥大化します。
次回はファイルごとに役割分担を明確にしたFlaskアプリを作成するために、Flaskの機能であるBlueprintをこのアプリに導入していきます。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次は、12. Python(Flask)でMariaDB(MySQL)へ接続できるアプリをもっと読みやすく改良してみようです。

(VPSでつくる) Nginx Unit+venv+FlaskでHello World

連載第六回目です。

色々と設定を行ってきましたが、今の状態ではNginx(Webサーバー)上で動的なサイトを表示することはできません。
そのため、今回はNginx Unit(APサーバー)を用いて、簡単なPythonアプリを作成してWebサイトで公開してみましょう!

そもそもAPサーバーって何ぞ?という方はミドルウェア(Web、AP、DB)について知ろうをご覧ください。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

1. Nginx Unitのインストール

では、まずNginx Unitのインストールを行います。
Nginxと同じようにレポジトリ情報を作成します。

vi /etc/yum.repos.d/unit.repo

ファイルの中身は下記の通りです。
記入したら:wqコマンドで保存+終了してください。

[unit]
name=unit repo
baseurl=https://packages.nginx.org/unit/centos/$releasever/$basearch/
gpgcheck=0
enabled=1

※先頭の何文字かが欠ける不具合があります。

それではインストールを行います。

yum install unit

最後に、必要な機能をインストールしておきます。

yum install unit-devel unit-jsc8 unit-jsc11 unit-php unit-python27 unit-python36

※公式サイトを参考にしていますが、今回不要なものはインストールしていないので、あなたの環境に必要なパッケージはインストールされない可能性があります。

環境設定は後で行います。

2. Python3.6.8のインストール

(仕様かどうかわかりませんが、)pyenvをそのままNginx Unitに反映することは難しいようです。
そのため、pyenvでインストールしたバージョンと同じPython3.6.8をVPSにインストールしておきます。

今回は、Python3.6.8のインストールは上記でunit-python36をインストールしたため、すでにインストール済みで不要です。別バージョンが必要であればこのページの下部にある補足. Python別バージョンのインストール方法をご覧ください。
もし別バージョンをインストールしたい(Python3.6.8か2.7.5以外の)場合はNginx Unitは非推奨です。Nginx Unitを使うには、Dockerコンテナ等別途準備が必要です。(参考ページ)

3. Flaskアプリの作成、仮想環境作成

続いて、Flaskアプリをインストールします。

まずは作業ディレクトリを移動して、Nginx公開用のディレクトリにします。

cd /usr/share/nginx/

test_flask仮想環境を作っておきます。

python3 -m venv venv/flask_test

仮想環境をアクティブ化して、flaskをインストールします。

source venv/flask_test/bin/activate
pip install flask

pythonインタプリタを起動して、flaskのバージョンを確認しておきましょう。

python
import flask
flask.__version__

下記のように表示が出ればOKです。

このとき、仮想環境以外にはflaskをインストールできていません。
つまり、もし実行するとエラーが出るはずです。確認しておきましょう。

pythonインタプリンタはControl+Zコマンドで出て、仮想環境を下記コマンドで非アクティブ化します。

deactivate

pythonインタプリタを起動して、flask_test仮想環境以外でflaskがインポートできないことを確認してください。

python
import flask

下記のようなエラーが出ますが、問題ありません。

最後に、Flaskアプリを作成しておきます。
まずは、アプリ用ディレクトリを作成します。

mkdir app/flask_test

続いて、viエディタで下記ファイルを作成します。

vi app/flask_test/main.py

ファイルの内容は下記の通りです。
下記の2通りの関数どちらもをアプリの1機能として表示させられるようにします。

from flask import Flask

application = Flask(__name__)

@application.route('/')
def index():
    return "Hello Flask1"

@application.route('/test2')
def test2():
    return "Hello Flask2"

※application = ~としているのは、Nginxで動作させるときのデフォルト値なので守ってください。
※変更したい場合は、conf.jsonのapplicationsのcallable設定を変更ください。

想定では、Flaskアプリを下記URLで表示できるようにします。
http://XXX.XXX.XXX.XXX/sample/

http://XXX.XXX.XXX.XXX/sample/
“Hello Flask1”

http://XXX.XXX.XXX.XXX/sample/test2
“Hello Flask2”

動作確認として、flask_test仮想環境をアクティブ化した状態で下記コマンドを使用してください。

python app/flask_test/main.py

エラーが出なければ完了です!

4. NginxおよびNginx Unitの設定

Nginx Unitを起動します。自動起動設定もしておきましょう。

systemctl start unit
systemctl enable unit

続いて、Unitの設定ファイル(conf.json)を作成します。

vi conf.json

ファイルの内容は下記の通りです。コピペでOKです。

{
  "listeners": {
    "*:8081": {
      "application": "flask_test"
    }
  },

  "applications": {
    "flask_test": {
      "type": "python 3.6.8",
      "path": "/usr/share/nginx/app/flask_test/",
      "home": "/usr/share/nginx/venv/flask_test/",
      "module": "main",
    }
  }
}

Nginx Unitの構造として、
指定ポートへのアクセス
↓
Listener
↓
venv(test_flask)
↓
Application(test_flask)

となりますので、上記のように設定します。

各設定の解説としては以下の通りです。

{
  "listeners": {
    "*:8081": { // ポート番号設定
      "application": "flask_test" // アプリケーション名
    }
  },

  "applications": {
    "flask_test": { // アプリケーションごとに設定を記述できる
      "type": "python 3.6.8", // python3.6.8以外も可能だが、別途設定が必要
      "path": "/usr/share/nginx/app/flask_test/", // アプリディレクトリ
      "home": "/usr/share/nginx/venv/flask_test/", // 仮想環境
      "module": "main" // 作成したファイル名(.pyなしが正)
    }
  }
}

その他の設定について、詳しくは公式サイトをご覧ください。

設定ファイルの通りにNginx Unitの設定を変更します。

sudo curl -X PUT --data-binary @/usr/share/nginx/conf.json --unix-socket /var/run/unit/control.sock http://localhost/config

エラーが出る場合は下記コマンドでエラーログを確認します。

vi /var/log/unit/unit.log

Successと出れば問題ありません!

あとは、Nginxの2つの設定を行えば対応完了です。
nginx.confの設定を行います。

sudo vi /etc/nginx/nginx.conf

http{}内に下記を記載します。

    upstream unit_backend {
        server 127.0.0.1:8300;
    }

※ポート番号は他のモノと一致しないようにしてください。

記載例は以下の通り。

default.confの設定を行います。

sudo vi /etc/nginx/conf.d/default.conf

※バージョンによっては、nginx.conf内に記載する場合があります。どのファイルに記載があるかご注意ください。

server{}内に下記を記載します。

    location /sample/ {
        proxy_pass http://127.0.0.1:8081/;
    }

※ポート番号はUnitの設定と一致するようにしてください。

記載例は下記の通り。

最後に、NginxとNginx Unitを再起動しておきます。

sudo systemctl restart nginx
sudo systemctl restart unit

これにて設定は終了です!

5. Webサイトの動作確認

想定通りに表示できるか確認します。
http://XXX.XXX.XXX.XXX/sample/
“Hello Flask1”

http://XXX.XXX.XXX.XXX/sample/test2
“Hello Flask2”

問題ありませんでした。
おつかれさまでした!

参考サイト

【Python】CentOS7サーバ上にFlask+Nginx+Nginx UnitでWebアプリを構築する

補足. Python別バージョンのインストール方法

Python3.X(今回は3.7.0)をVPSにインストールしておきます。

まずは、pyenvを一旦非アクティブ化させるため、下記のbashファイルを編集します。

vi ~/.bashrc

~/.bashrcの内容の次の文字列を削除します。

export PATH="/root/.pyenv/bin:$PATH"
eval "$(pyenv init -)"
eval "$(pyenv virtualenv-init -)"

((VPSでつくる) Pythonのバージョンを3.Xにするの次の文字列(*1)に該当)

最後にリブートします。一旦CUIが閉じるで再ログインしてください。

sudo reboot

次に、yumにインストールしたいPythonのバージョンがあるか確認します。

yum search python3

Python3.6.8が最新のようですね…。

目的の3.7.0がないので、適当なディレクトリを作って、その中で作業をします。

mkdir /usr/share/nginx/temp
cd /usr/share/nginx/temp

続いて、ファイルをダウンロードします。

curl -O https://www.python.org/ftp/python/3.7.0/Python-3.7.0.tgz

※必要であれば、https://www.python.org/ftp/python/から検索できます。

ファイルを解凍して、ディレクトリに移動します。

tar xf Python-3.7.0.tgz
cd Python-3.7.0

インストールを行います。
このままインストールすると、Pythonは/usr/local/ディレクトリにインストールされます。

./configure
make
sudo make altinstall

もし、その他にインストールしたい場合は、./configure –prefixオプションを利用ください。

パスが通っていないのでパスを通しておきます。

sudo visudo

下記のように変更します。
かなり下の方にあるので、/コマンドでsecureを検索すると楽です。

Defaults    secure_path = /sbin:/bin:/usr/sbin:/usr/bin
↓
Defaults    secure_path = /sbin:/bin:/usr/sbin:/usr/bin:/usr/local/bin

バージョンを確認します。

python3 -V

python3へのパスが3.6.8に通っていることが多いので、これも変更しておきます。

sudo ln -sf /usr/local/bin/python3.7 /usr/bin/python3

※python3ではなく、pythonにパスを通すのはおすすめしません。yumなど他の環境を壊してしまう可能性があるため、非推奨です。

もし指定したいバージョンのpythonへのパスが分からない場合は、下記で検索を行います。

whereis python

バージョンを再度確認します。

python3 -V

下記のように表示されればOKです。

最後に、ディレクトリの削除などの整理を行っておきます。

cd ../../
rm -rf temp

削除したこの内容を再度記述します。
→ ~/.bashrcの内容の次の文字列を削除します。

export PATH="/root/.pyenv/bin:$PATH"
eval "$(pyenv init -)"
eval "$(pyenv virtualenv-init -)"

シェルを再起動させます。

exec $SHELL

注意点としては、venvを作成した時のバージョンと、動作環境のpythonのバージョンは一定でなければなりません。
pyenvでバージョンを切り替えながら仮想環境を作ると、たまにミスするので取り扱いに注意してください。

おわりに

どうにかNginx Unitとvenv、Flaskを使ったアプリケーションができました。
ただ、Webアプリに重要な機能がまだ構築できていません。
データベースとFTPです。

データベースはこれまで使う必要がありませんでしたが、MariaDB(MySQLの完全互換)使えるように設定します。
データベースをGUI上で簡単に使えるように、phpMyAdminを導入します。
FTPは、viエディタでチマチマ記載していたものを転送で簡単に送ったり、アプリをデプロイするときに使います。
それぞれ、少し手間はかかりますが、今回ほどではないので一緒に頑張りましょう!

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次は、7. Nginx+PHPでHello Worldです。

(VPSでつくる) Python仮想環境venvの導入

連載第五回目です。

前回の4. Pythonのバージョンを3.Xにする記事で、Pythonのバージョン管理をディレクトリごとに行えるようになりました。

ただし、アプリごとにモジュールのバージョンは変えることができません。
特に、機械学習や統計学関係だとモジュールを変える必要がたまにあります。
そのため、今回はvenvを使って、アプリごとにモジュールの管理を行えるような環境を作りましょう。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

1. 環境の確認

3. NginxでHello Worldで簡単に確認した内容を再確認します。
今回確認したいのは、Nginxの公開ディレクトリ関連のフォルダです。

パス 説明
/etc/nginx/ Nginxの設定ファイルが色々と入っている
/etc/nginx/nginx.conf Nginx設定ファイル
/var/log/nginx/ ログ保存ディレクトリ
/usr/share/nginx/html/ WEBサイトの公開ディレクトリ

なぜかというと、「アプリをどのディレクトリに入れて、どの仮想環境で実行するか」を系統立てて決めておいた方が後の管理が楽だからです。

今回構想しているディレクトリ構成は以下の通りです。

/usr/share/nginx
 ┗ app アプリ用ディレクトリ
 | ┗ アプリA
 | ┗ アプリB
 | ┗ アプリC
 ┗ venv 仮想環境用ディレクトリ
 | ┗ アプリA用環境
 | ┗ アプリB&C用環境
 ┗ html 静的ファイル設置用

そのため、以降は上記に従ってアプリAを動かせるようなアプリA用環境を作っていきます。
そのために、まずは基本的なディレクトリを作っておきます。

mkdir /usr/share/nginx/app
mkdir /usr/share/nginx/venv

2. venv環境の作成

まずは、アプリA用環境のためのディレクトリを作成します。

mkdir /usr/share/nginx/venv/app_a

下記コマンドで仮想環境を作成します。

python -m venv /usr/share/nginx/venv/app_a

※完了した表示は一切出ませんが、エラーが出なければ問題ないです。

3. venv環境の利用

venv環境をアクティブにします。

source /usr/share/nginx/venv/app_a/bin/activate

アクティブ化に成功すると、下記のように(環境名)[ログインユーザー名@ログイン場所 ディレクトリ名]が表示されます。

仮想環境を使うことで、その環境内でインストールしたPythonモジュールはその環境内でのみ有効となります。
どこまでがアプリA用の環境であるのか区分がはっきりするので非常に扱いやすくなります。

仮想環境内でpythonインタプリタを実行する場合は下記コマンドを使用します。

python

pythonファイルを実行する場合は下記コマンドを使用します。

python XXX.py

仮想環境を非アクティブ化するには下記コマンドを使用します。

deactivate

その他の詳細はvenv公式サイトをご覧ください。

おわりに

今回はvenvを使い、モジュールの管理を簡単にすることができました。
しかし、今の状態ではNginx(Webサーバー)上で動的なサイトを表示することはできません。
そのため、次回はNginx Unit(APサーバー)を用いて、簡単なPythonアプリを作成してWebサイトで公開してみましょう!

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次は、6. Nginx Unit+venv+FlaskでHello Worldです。

(VPSでつくる) Pythonのバージョンを2.7.5から3.6.8にする

連載第四回目です。
CentOS7にインストールされているPythonのバージョンが2.7なので、バージョンアップをします。

そうしないとPythonのアプリが動きません。
なぜなら、Python2と3はプログラムの記法が違います。そりゃ動かないですよね。。

今回はpyenvを使ってPythonのバージョンを上げます。
バージョンはNginx Unitで使われている3.6.8を利用します。
3.6.8以外にする場合は、Dockerコンテナ等別途準備が必要です。(参考ページ)

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
その他については上記ページをお読みください。

1. pyenvのインストール

まずは、Pythonのバージョンを確認します。
2.X.Xだと思います。

python -V # python --version も可

※もし3.X.Xになっている場合は下記工程は不要です。

続いてgitをインストールします。

sudo yum install git

pyenvのインストールを実施します。

curl https://pyenv.run | bash

実は、ウラで下記のようなコマンドが実行されています。(公式サイトより)
gitをインストールすることで、このコマンドを有効にできます。

curl -L https://github.com/pyenv/pyenv-installer/raw/master/bin/pyenv-installer | bash

※上記のインストール後に、下記工程で入力すべき文字列(*1)が表示されるので参考にしてください。

続いて、シェルの起動時にpyenvを自動的に起動するようにしておきましょう。
ファイル~/.bashrcを下記コマンドで開いてください。

vi ~/.bashrc

最後に、~/.bashrcの内容に次の文字列(*1)を追記(赤枠)します。

export PATH="/root/.pyenv/bin:$PATH"
eval "$(pyenv init -)"
eval "$(pyenv virtualenv-init -)"


※PATHの/root/部位が環境によって異なる場合があります。ご注意ください。

※シェルを再起動させた時、WARNINGが出る場合は2行目をeval “$(pyenv init –path)”に変換してみてください。
(参考:pyenv(Github) issue #1906)

シェルを再起動させます。
上記の変更が反映され、pyenvが使えるようになります。

exec $SHELL

確認のため、pyenvのバージョンを表示してください。
問題なくインストールされていれば、下記コマンドでバージョンが表示されます。

pyenv --version

2. Python3のインストール

まずは、Python3をインストールする前に、Python3に必要なモジュールをインストールします。

sudo yum install zlib-devel libffi-devel openssl-devel

続いて、インストールできるバージョンを確認します。
もしPython3.6.8以外を選ぶ場合はこちらの手順を参考にしてください。

pyenv install -l

それでは、指定されたバージョン(3.6.8)をインストールします。

pyenv install 3.6.8

少し時間が掛かるので注意が必要です。フリーズしているわけではありません。

それでは、インストールされたかどうかを確認します。
今回指定したバージョンが出力されればOKです。

pyenv versions

3. Python3に切り替える

Python2から3に切り替えます。

まずは現在のバージョンを確認します。
何もしていなければ2.7.5から変わっていないはずです。

python -V

続いて、下記でPythonのバージョンをGlobal環境で切り替えます。

pyenv global 3.6.8

※local(指定ディレクトリ以下)も可能です。

3.6.8に変わっているか確認します。

python -V

変わっていれば終了です!
おつかれさまでした。

追加でPIP(Pythonのパッケージ管理ソフト)をアップグレードをしておいてください。

pip install --upgrade pip

アップグレードしておかないと、必要なモジュールをインストールできない時があります。

おわりに

今回の方法以外で、venvを使わずにPython2と3を同じ環境に入れて切り替える方法もありますが、かなり面倒だったので今回はこちらの方法を使いました。

もし、Pythonで使いたいバージョンやモジュールのバージョンの組み合わせが複数通りあると困りますよね?
Pythonのバージョンだけなら、指定ディレクトリでpyenv local 3.X.Xのコマンドを打てばいいのですが、それではモジュールのバージョンは管理しきれません。
そのために、次は各々のアプリ用のモジュールバージョン管理用にvenvを導入していきます。

この記事は、VPSで作るPythonでのWebアプリ運用環境の連載記事です。
次は、5. Python仮想環境venvの導入です。

VPSでつくるPythonでのWebアプリ運用環境(連載記事)

今風のWebアプリをリリースするにはレンタルサーバーでは物足りない!

例えば、PythonやRubyに対応しているレンタルサーバーはあまりありません。加えて、データサイエンスや機械学習に強いプログラム言語Pythonは頻繁にアップデートされますので、レンタルサーバーではアップデートに対応して即時に変更反映・・・なんてものはできません。

例えば、私はPython3.Xが入っていないから、変更後のライブラリ〇〇が使えない…ことを何度も体験してきましたorz

そこで、VPS(Virtual Private Server)を使って開発環境を丸ごと借り、自由度の高いサーバーを構築していきます。今回はさくらVPS(https://vps.sakura.ad.jp/)を使っていきます。

VPSにした理由は、クラウドサービスに比べVPSは割安だからです。

よく例に挙がるAWSやGCPは利用料金が高いです。本格的に収益の上がるサイトができた場合は移行するといいかもしれません。

AWSは、1ノードを20日程度放置していただけでも月3万の請求が来ていました。AWSの勉強をしてただけなのに怖いですね。GCPも、仕事で使う分には気にならない程度で、機械学習・データ分析用途でアクセスが多く(1000程度)ても月10万PV行かないくらいで3万以上です。個人開発では高いですね。

なんと、VPSは最小構成で月約650円です。レンタルサーバーに比べて自由度が高いので、ある程度満足できる金額ではないでしょうか。

さくらにした理由は、レンタルサーバーを借りていた際に満足できる経験をしたからです。
①2年以上運用していたが、サーバー停止など大きなトラブルがなかった。
②さくらサーバーからエックスサーバーへの移行時(利用停止時)にさくらのカスタマーサポートに相談したが、その時でさえサポートが充実していた。

まずは、構築環境を下記の通りに示します。
構築する環境はあくまでアプリに合わせて選ぶものなので、あなたのアプリに合わない場合は適宜変更してください。

続いて、具体的に何をするのか目次をリストアップします。
大きな目的である直接の運用コストを減らすためにVPSを採用していますが、VPSはセキュリティ等を含め全てを自分で管理する必要があります。
そのため、手間を減らす必要があるので、自動起動・アップデートの自動化なども忘れずに導入しておきます。

最後に、VPSの総括を行います。
良い点、悪い点、引っかかりやすいポイントなどなど。

補足として、この記事内に作者のバックグラウンド(Webサーバー関連の理解度など)も記載しておきます。ご参考に。

(1)構築環境

基本構成

OS:CentOS7

CentOS8までの中でサポートが一番長い。事例が多い。

Webサーバ:Nginx

Apacheより動的なアクセス処理が得意(らしいので)、今回のWebアプリに最適。

APサーバ:Nginx Unit

より新しく(2018年リリース)、Nginxと併用されやすいGunicornより導入が簡単だった。

その他構成

サーバーへのアクセス:SSH

サーバー管理・設定変更の安全のため。

FTP

サーバーへのファイル転送のため。

SSL接続(HTTPS)のみ

HTTPはNginxの設定で遮断。SSLは独自ドメインの取得が必須。

アプリ

ソーシャルトラッキングアプリ(目標管理+ルームチャット)です。
目標管理に加え、オンラインもくもく会や勉強会ができる感じのアプリです。
→ ある程度小さいデータのやり取りを何度も行う想定。
→ 将来的にレコメンドなどの機械学習システムを導入したい。

Python3.6.8(Flask)+pip3+MySQL

構築がより簡単なため。
Python3.6.8か2.7.5以外の場合はNginx Unitは非推奨。(理由は後述)

Flask+BluePrint

機能拡張を行うために、BluePrintを導入。

MySQL(MariaDB)+PHP+phpMyAdmin

GUIでデータベースを操作したい。(CUIでの操作は面倒…)

(2)利用環境

OS:Windows10

サーバーへのアクセス:TeraTerm

FTP:WinSCP

データベース管理:phpMyAdmin

仮想環境:pyenv+pip

以上が構築環境、利用環境です。
続いて、目次に移ります。

(3)目次

全体構成としては、下記の図の通りです。それを一つずつ構築していきます。

基礎設定

1. VPSへのログイン
2. CentOS7のインストール

PythonでHello World

3. NginxでHello World
4. Pythonのバージョンを2.7.5から3.6.8にする
5. Python仮想環境venvの導入
6. Nginx Unit+venv+FlaskでHello World

データベース+PHPインストール

7. Nginx+PHPでHello World
8. MariaDB(MySQL)インストール
9. phpMyAdminインストール

FTP

10. WinSCPでFTP接続

Pythonアプリ導入

11. PythonでMariaDB(MySQL)へ接続できるアプリを触ってみよう
12. Python(Flask)でMariaDB(MySQL)へ接続できるアプリをもっと読みやすく改良してみよう
13. Socket通信を使ったモダンなチャットアプリをFlaskで作ろう

その他

14. セキュリティ設定
15. Let’s EncryptでVPS上のWebサイトをSSL(HTTPS)接続にしよう

総括

総括・変更履歴

(4)作者のバックグラウンド

具体的には、このWebサーバー構築前はAPサーバーって何やねんってレベルでした…
インフラわからん!
趣味でレンタルサーバーを借りていて、Webサイト(ApacheでCakePHP2(PHP5+MySQL))を10年近く運営しています。
ただ、今回のWebサーバ(Nginx+Nginx Unit(or Gunicorn)でFlask(Python3+MariaDB))を構築するのに1か月近くかかった程度のレベル感です。orz

執筆時の状況は、仕事はエンジニアではなく、コンサルティング(データ・AI系)なので前知識ほぼありません。基本情報技術者レベルの知識はありました。

さいごに

最後までお読みいただき誠にありがとうございました。

試行錯誤の末にどうにかVPSでWebサーバーを動かせるようになりました…。
これまでは、個人ではレンタルサーバー任せ、仕事ではクラウド任せだったので、APサーバーなどを全く意識せずに使っていて今回かなり引っかかりましたorz
このページのように情報を統合して書いておくと、他の人も時間を無駄にしなくて済むといいな~と思って書いています。

分かり辛い点や解釈がおかしい部分があればコメントいただけると幸いです。
よろしくお願いいたします。

for内で選手個人データをSQLで呼び出すより、辞書型を利用した方が読み込みは早い

for内でSQLを呼び出すと遅い…。
自作野球ゲームMeisyoでは、明示的にデータを呼び出すためにfor内でSQLを利用していました。

CDs = {} # Cardデータ(選手id, 選手データ)を入れた辞書
for key in CDs:
    CD = CDs[key] # 選手IDで選手カードデータを呼び出し
    CD_BR = read_bt(key) # 打撃データ呼び出しSQL
    CD_PR = read_pc(key) # 投球データ呼び出しSQL
    print("キャラクター結果")

今回の改修で、下記のように書き換えました。

CDs = {} # Cardデータ(選手id, 選手データ)を入れた辞書
CD_BRs = reads_bt(my_id) # my_idが所持するカードの打撃データ(選手id, 打撃データ)を入れた辞書
CD_PRs = reads_pc(my_id) # my_idが所持するカードの投球データ(選手id, 投球データ)を入れた辞書
for key in CDs:
    CD = CDs[key] # 選手IDで選手カードデータを呼び出し
    CD_BR = CD_BRs[key] # 打撃データ呼び出しSQL
    CD_PR = CD_PRs[key] # 投球データ呼び出しSQL
    print("キャラクター結果")

こうすることで、「負荷の小さいSQLを何回も実行する」のではなく「1回で全てを取り切り、分割して表示する」ことになります。
ただし、辞書型を利用するため、あまりにも対象が多すぎるクエリの場合はサーバーのメモリ許容量に達しかねないので注意してください。

[Python] PDFファイルから文字抽出

「大量にPDFファイルがあり、そこから文字を抽出したい。」
そんなお悩みにPython(プログラム言語)でお答えします!

まずは、PDFの種類を確認し、それぞれに対応コードを例示します。

* 今回、構造化データは英語文書のみを対象としていますのでご注意ください。
* 構造化データを日本語対応にしたい場合は「pdfminer.six」モジュールの利用をお勧めします。

対応したいファイル
・パスワード付きのファイル
・その他読み込みが難しいファイル

Twitter:R@へDMいただけると助かります!

想定読者

・Pythonを使ったことがある人
・プログラム言語を書いても良いなと思う人

プログラムは意外と簡単なので、Anaconda Navigatorを使えるようにしてみてください。
下記のコードは、お手持ちのパソコンで全て実行可能です。スペックは不問です!

PDFファイルの種類

  1. 構造化データ
  2. 「文字がどこに配置されているか」が明確に決まっているPDFファイル。

  3. 非構造化データ
  4. 「文字がどこに配置されているか」が明確に決まっていないPDFファイル。画像を埋め込んだものが主。

1. 構造化データ

構造化データは、処理する方法が決まっています。

コマンドラインでPyPDF2のインストール

pip install PyPDF2

Jupyter NotebookまたはPython上でPython関数の定義

import PyPDF2
# 構造化データ読み込み
def open_pdf_text(file_name):
    text = ''
    with open(file_name, "rb") as f:
        reader = PyPDF2.PdfFileReader(f)
        for page_no in range(reader.numPages):
            page = reader.getPage(page_no)
            if page.extractText():
                text += page.extractText()
    return text

下記コードの実行

file_set = "PDFs/構造化データ.pdf"
open_pdf_text(file_set)

構造化データの場合、open_pdf_text関数からfile内の文字データが出力されます。
そうでない場合、空の出力(または改行のみ)が行われます。そのため、2番の非構造化データ抽出を行いましょう。

2. 非構造化データ

非構造化データの場合、画像として読み込んだ方が手っ取り早いです。
以降はPDFを画像化し、OCR(光学文字認識)で読み込む方法です。

TesseractとPyOCRのインストール

OCRをあなたのパソコン上で使うために、インストールを行います。
詳細はPythonでOCRを実行する方法のうち、TesseractのインストールとPyOCRのインストールをご覧ください。

PDFを画像化し、画像をOCRで読み込むPython関数の定義

PDFを画像化した際に保存しておくフォルダを「Image」とします。なければ作ってください。

import pathlib, pdf2image, glob, os, pyocr, PIL

# poppler/binを環境変数PATHに追加する
poppler_dir = os.path.join(pathlib.Path().resolve(), "src/poppler/bin")
os.environ["PATH"] += os.pathsep + str(poppler_dir)

# 画像読み込み
def open_pdf_image(file_name):
    ## pdfから画像化
    img_dir = pathlib.Path('Images')
    # 存在する画像ファイルを削除
    for p in glob.glob(os.path.join(img_dir, "*.png")):
        if os.path.isfile(p):
            os.remove(p)
    # 画像ファイル抽出
    images = pdf2image.convert_from_path(file_name, grayscale=True, size=1800)
    for index, image in enumerate(images):
        image.save(img_dir/pathlib.Path('{}.png'.format(index + 1)), 'png')
        
    ## 画像を加工したい場合はこちらに記述する

    ## ocr読み込み
    tools = pyocr.get_available_tools()
    tool = tools[0]
    builder = pyocr.builders.TextBuilder(tesseract_layout=6) # 1~6まで存在する
    # テキスト抽出
    text = ''
    for p in glob.glob(os.path.join(img_dir, "*.png")):
        if os.path.isfile(p):
            img = PIL.Image.open(p)
            text += tool.image_to_string(img, builder=builder)
    return text

エラーが出る場合は、上記と同じようにpipでインストールしてください。

実行は上記と同じように行います。

file_set = "PDFs/非構造化データ.pdf"
open_pdf_image(file_set)

画像を加工する方法

特定部分以外の文字が必要がない場合は、画像のトリミングを行います。
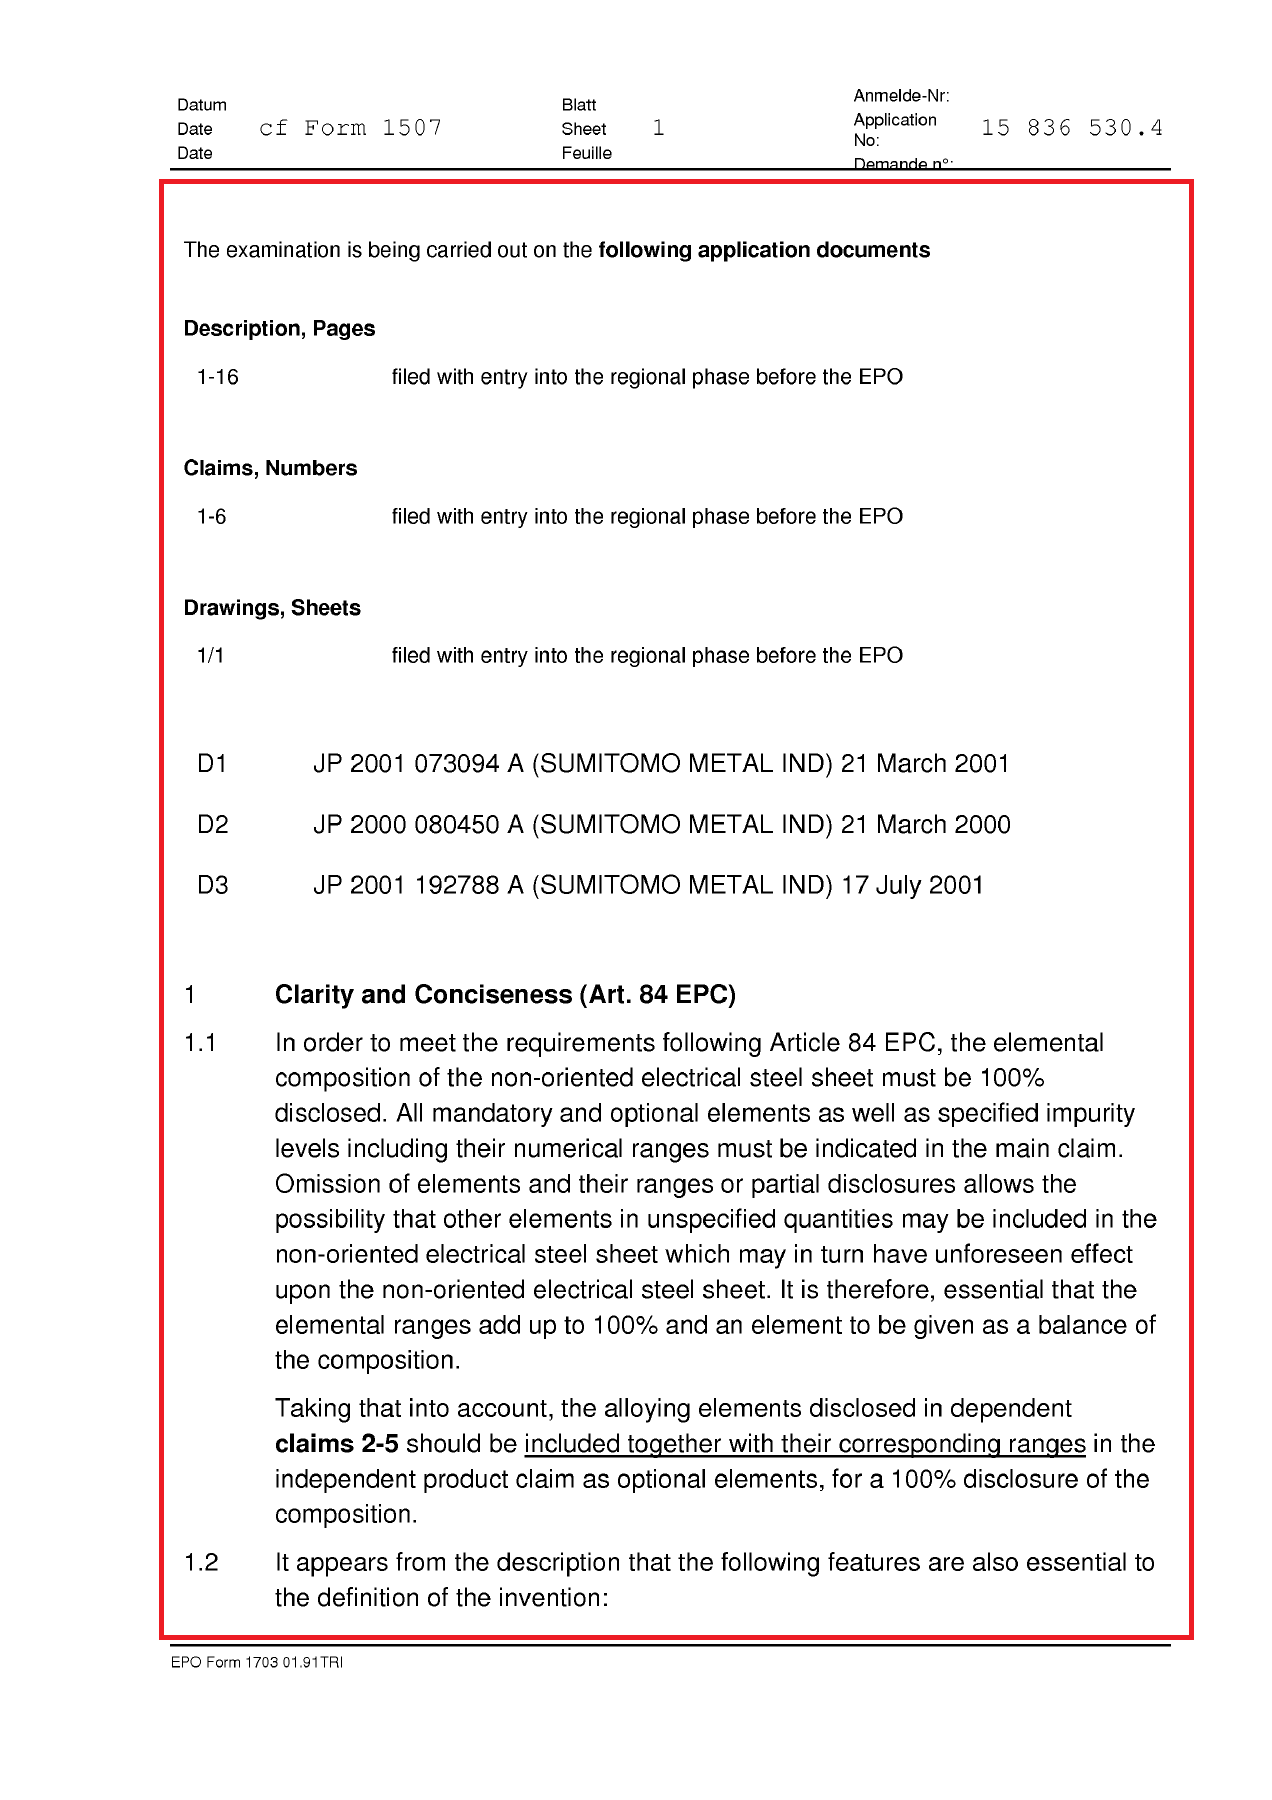
たとえば、下記のようなPDFの場合、赤枠内の文字しか使いません。

下記は例ですが、どのファイルにも応用が可能です。

## 画像ファイル加工
img_dir = pathlib.Path('Images')
for p in glob.glob(os.path.join(img_dir, "*.png")):
    if os.path.isfile(p):
        ## 画像1枚の加工
        img = PIL.Image.open(p)
        # 切り抜き版を(left, upper, right, lower)で指定
        img_crop = img.crop((160, 180, 1200, 1640))
        img_crop.save(p)

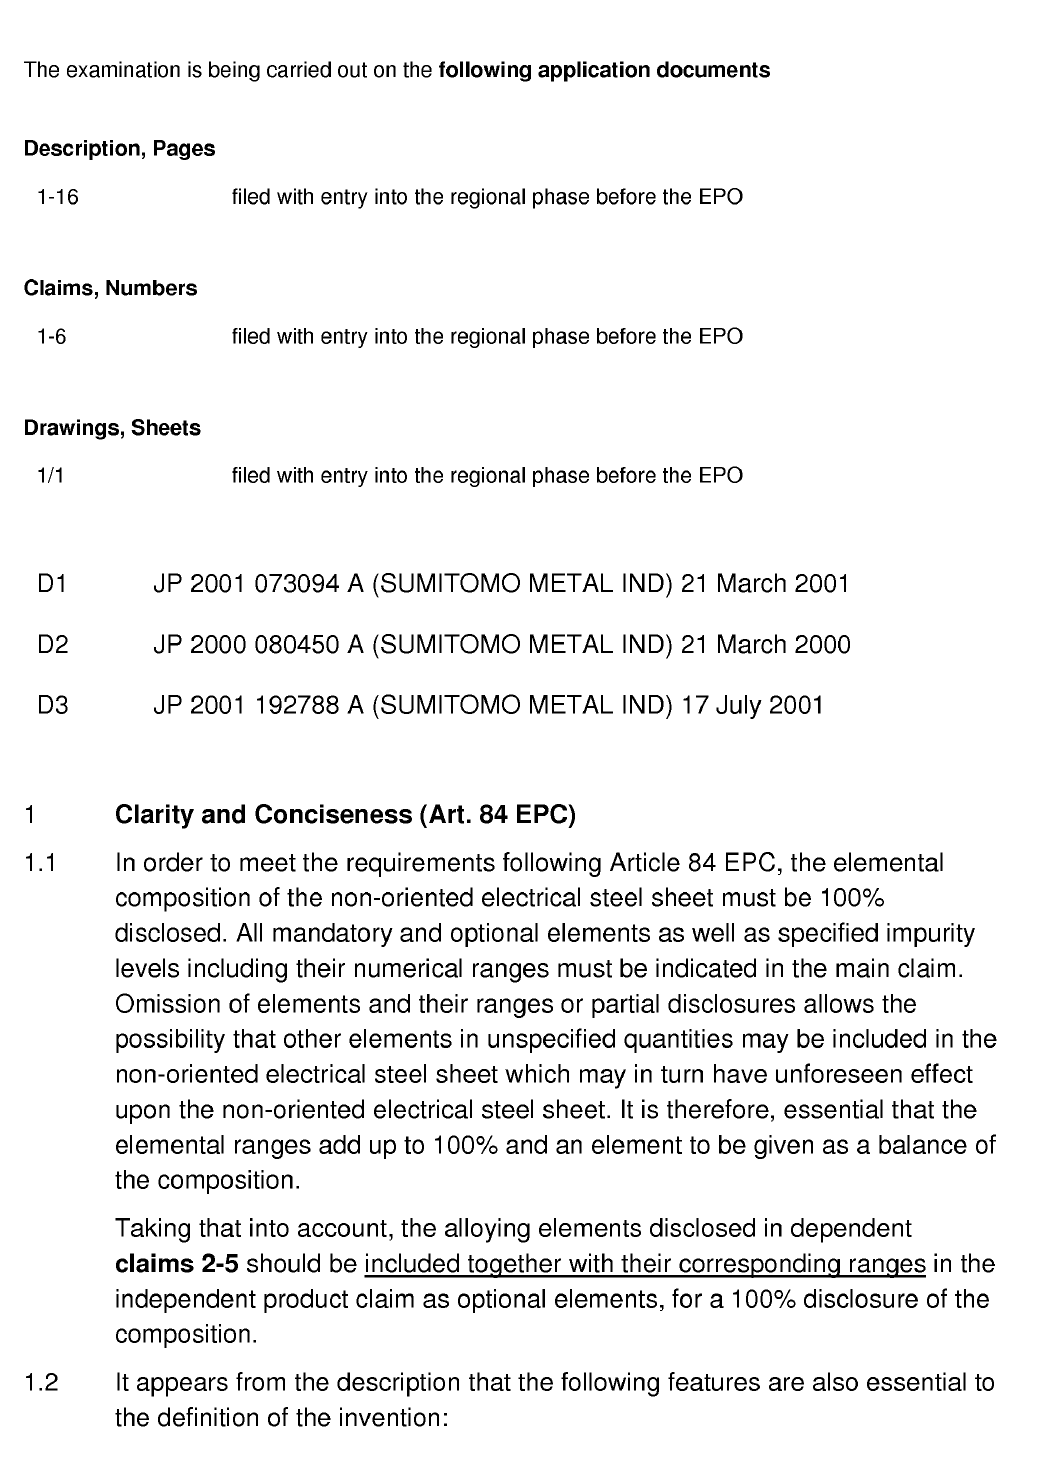
上記の画像ファイルは下記のように加工されます。

加工することで、無駄な情報がかなり減ります。
例として、加工前と加工後の文字を比較します。

画像加工後にも存在, 画像加工前のみ存在

Datum Blatt Anmelde-Nr:\nDate cf Form 1507 Sheet 1 ppelcation 15 836 530.4\nDate Feuille °° .\nThe examination is being carried out on the following application documents\nDescription, Pages\n1-16 filed with entry into the regional phase before the EPO\nClaims, Numbers\n1-6 filed with entry into the regional phase before the EPO\nDrawings, Sheets\nq1 filed with entry into the regional phase before the EPO\nD1 JP 2001 073094 A (SUMITOMO METAL IND) 21 March 2001\nD2 JP 2000 080450 A (SUMITOMO METAL IND) 21 March 2000\nD3 JP 2001 192788 A (SUMITOMO METAL IND) 17 July 2001\n\n1 Clarity and Conciseness (Art. 84 EPC)\n\n14 In order to meet the requirements following Article 84 EPC, the elemental\ncomposition of the non-oriented electrical steel sheet must be 100%\ndisclosed. All mandatory and optional elements as well as specified impurity\nlevels including their numerical ranges must be indicated in the main claim.\nOmission of elements and their ranges or partial disclosures allows the\npossibility that other elements in unspecified quantities may be included in the\nnon-oriented electrical steel sheet which may in turn have unforeseen effect\nupon the non-oriented electrical steel sheet. It is therefore, essential that the\nelemental ranges add up to 100% and an element to be given as a balance of\nthe composition.\n\nTaking that into account, the alloying elements disclosed in dependent\nclaims 2-5 should be included together with their corresponding ranges in the\nindependent product claim as optional elements, for a 100% disclosure of the\ncomposition.\n\n1.2 It appears from the description that the following features are also essential to\nthe definition of the invention:\n\nEPO Form 1703 01.91TRI

加工方法が決まった場合、PDFを画像化し、画像をOCRで読み込むPython関数の定義内の「上記の画像を加工したい場合はこちらに記述する」に記述すると画像加工処理を組み込むことができます。

最後に

Pythonにより、かなり簡単にPDFから文字抽出を行うことができたと思います。
ある程度文書構成が決まっていた場合には、文字の自動抽出を行うことができるようになるでしょう。

このような技術があれば、医療・医薬品業界や司法関連業務の半自動化が進むといいですね。
ヒトは解釈など機械にできないことに時間を使うべきであって、単純作業に時間を取られるべきではないです。

参考

PythonでPDFからテキストを読み取る方法について
PythonでOCRを実行する方法
Python, Pillowで画像の一部をトリミング(切り出し/切り抜き)

統計的因果探索(LiNGAM)を分析実務観点で詳しく解説

統計的因果推論の一分野である統計的因果探索。
その研究の中で生み出された画期的なモデルLiNGAMの解説を行います。PythonによるLiNGAMの実装については、cdt15/lingamと、応用モデルおよびPythonモジュールの解説をご覧ください。

背景

これまでの統計学や機械学習の多くが、相関を元に関係性を把握してきました。

ただし、その変動は何が原因なのかという本当に知りたいことは不明でした。

因果探索とは、データから因果構造を推定する方法を指します。
それは、因果の方向性や大きさを含み、これまでの統計学や機械学習とは違った原因とは何かを探していく方法です。

ここでは、統計的因果探索の代表的なアプローチであるLiNGAM(Linear Non-Gaussian Acyclic Model)を紹介します。

数理的なアプローチは他の資料に譲るとして、実用にはどういった点を注意すべきか、どのような応用モデルがあるかについて中心に説明します。

LiNGAM適用の前提条件

LiNGAMを適用する前に、適用するデータの前提条件が4つあります。

(1)Linear

線形な(足し合わせで表現できる)構造方程式で示すことができるとする。

構造方程式とは、下記のような式です。

簡略化するとxは何で、yは何で表されるかを示すことができる式です。

(2)Non-Gaussian

構造方程式の誤差項は非正規(ガウス)分布である。

(3)Acyclic

非循環な因果グラフ(Directed Acyclic Graph)で表すことができるとする。

(4)構造方程式

未観測の要因が存在しない。つまり、構造方程式で因果構造全てを表すことが可能であるとする。
各誤差項は互いに独立であり、各変数は連続値であるとする。
*各誤差項はxやyなどで表せていない値の動きを全て表現できるとする。

調べていて、かなり強い前提を置いているのでは?というところが分かりました。

前提条件の理由

前提は4つありますが、一番気になるのはなぜ「構造方程式の誤差項は非正規(ガウス)分布である。」のかでしょう。
*変数の独立性や分布のガウス性の成否は、一般的な方法で求めることができるので割愛します。

少し調べてみるとLiNGAMはセミパラメトリックアプローチとされています。セミパラメトリックアプローチの定義は、関数型には仮定を置くものの、構造方程式の誤差項(外生変数ともいう)の分布には仮定を置きませんとされています。

LiNGAMは誤差項を「正規分布以外」という仮定であるので、それ以外の分布はすべて取りうる(=仮定を置いていないのと同じ)というスタンスを取っているため、セミパラメトリックアプローチに分類されています。

そうすると、何が嬉しいのでしょうか?
そうしなければ、何に困るのでしょうか?

答えは、誤差項が正規分布であると因果の方向が推定できないのです。

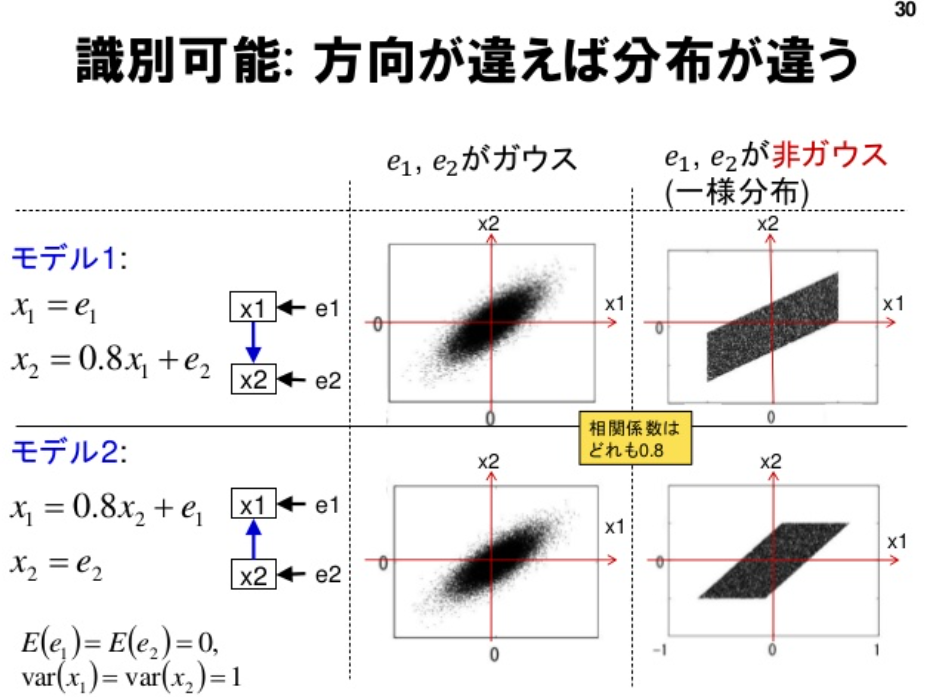
下記の図をご覧ください。

(因果探索: 基本から最近の発展までを概説 P.30)
変数の平均や分散が同じで、正規分布であるとx1かx2どちらがどちらか判断がつきません。

そのため、LiNGAMの誤差項は非正規分布であるという仮定を置いていると読み解けます。

実用時の懸念点

上記に記載した4つの前提で気になる点は複数あります。

(1)Linear

線形な(足し合わせで表現できる)構造方程式で示すことができるとする。

懸念点

本当に因果関係は線形で表せるのか?
例えば、コンビニで購入する経験と行動変容について、下記の条件で行う1回の差は同じだろうか?
・初めて(1回目)の購入(感触:これ良さそう! → 経験:いいなこれ!)
・2回目の購入(これ良かったよね! → やっぱり良いね!)
・3回目の購入(これやっぱり良いよね! → ずっとこれにしよう!)

LiNGAMでは同じと計算されます。

(2)Non-Gaussian

構造方程式の誤差項は非正規(ガウス)分布である。

懸念点

正規分布は、実世界のデータではなかなか見かけないので問題ないのだろうか。特に、購買関係は正規分布は少ない。

実世界のデータで、機器の波形データなどに正規分布があることは周知の事実です。因果グラフ上に正規分布のデータがもし存在した場合は、その変数を除外するのか?正規分布でなくなるように加工するのか?は不明です。

(3)Acyclic

非循環な因果グラフ(Directed Acyclic Graph)で表すことができるとする。

懸念点

一般的に因果は循環しうるのではないか?例えば、購買活動で良い体験が得られた場合は、もう1度経験しようとする動機が生まれるのではないか?

(4)構造方程式でかつ…

未観測の要因が存在しない。

つまり、構造方程式で因果構造全てを表すことが可能であるとする。各誤差項は互いに独立であり、各変数は連続値であるとする。

懸念点

すべての要因を観測できていることはありうるのか?ということですね。無理だと思います。

こちらは。統計的因果推論の傾向スコアマッチングでも問題になりますね。

以上、上記のようにいろいろな疑問点が浮かんできますね。
そのまま推定すると、前提条件から外れているため、因果構造の推定精度が落ちることは予想されます。

その対処には、複数の応用モデルが存在します。

応用モデルおよびPythonモジュールの解説


下記で簡単にインストールが可能です。

pip install lingam

テストコードはLiNGAM – Githubのexampleディレクトリで利用可能です。下記で紹介しているモデルの他にもさまざまなモデルが存在します。

コードの実行については、その他の資料に説明を譲ります。

方法論としてDirectLiNGAMはよく使いそうなので、解説を追加しておきました。

DirectLiNGAM

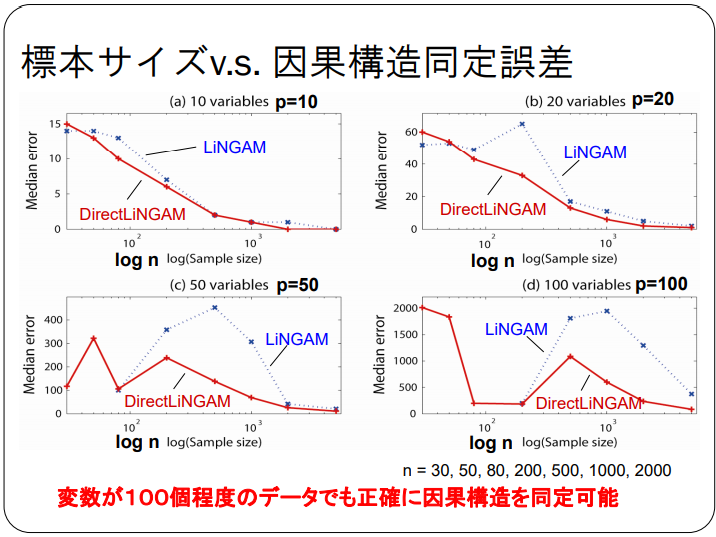
回帰分析の残差を利用したモデル。通常のICA-LiNGAMより性能が良いとされている。(ビッグデータに基づくモデリング -生体・医療への適用を例として-より)

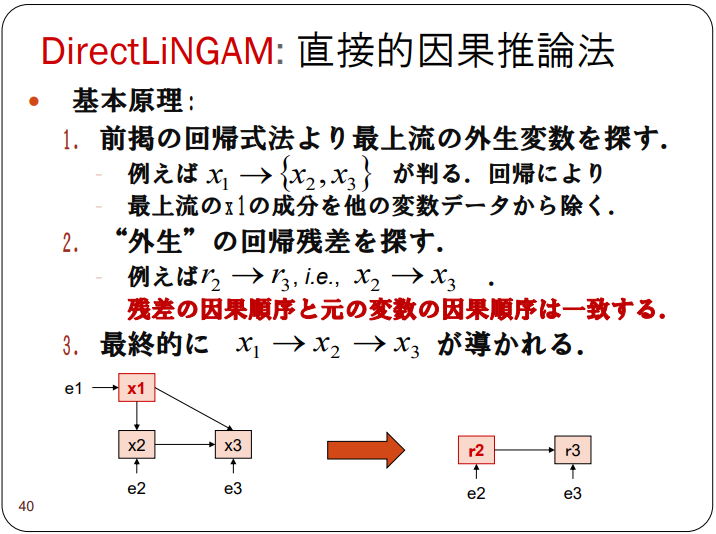
DirectLiNGAM アルゴリズム


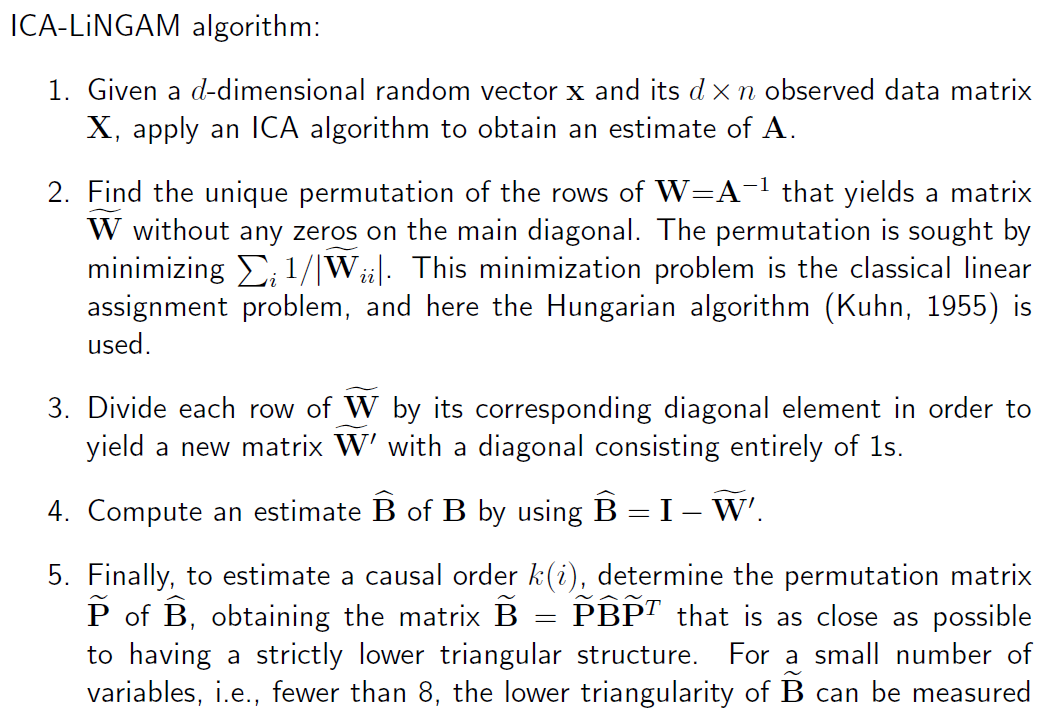
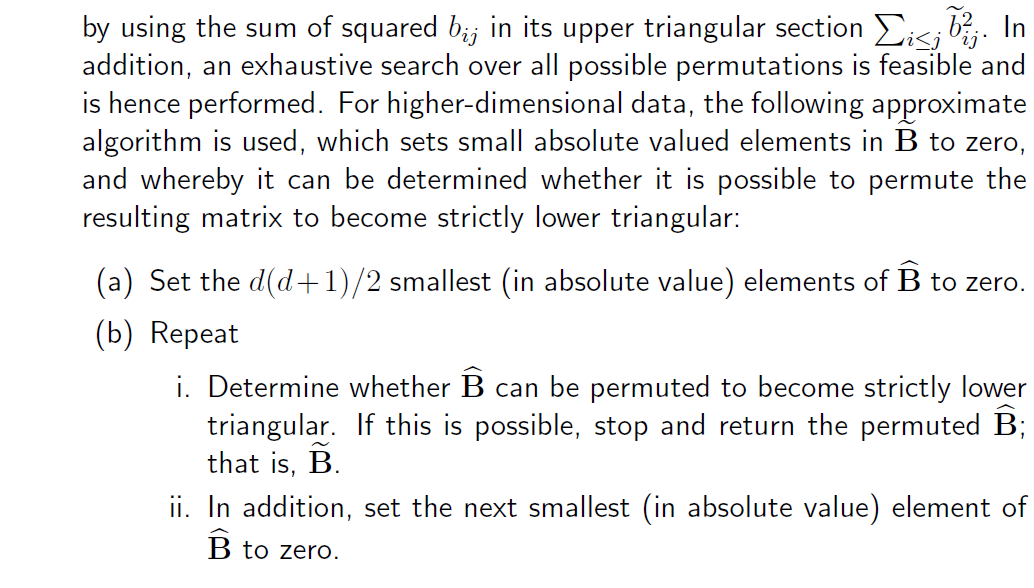
日本語で良い資料がなかったので同資料をコピーしています。
回帰分析を行い、その残差をさらに回帰分析することを繰り返す方法です。意外と簡単ですね。

非線形モデル

関数型を線形→非線形に切り替えます。

巡回モデル

因果を非巡回→巡回に切り替えます。

離散変数モデル

ベイジアンネットワークのように変数を離散変数として扱います。

未観測要因ありモデル(ParceLiNGAM)

外生変数に未観測要因があることを前提に計算します。

離散変数モデル

ベイジアンネットワークのように変数を離散変数として扱います。

時系列モデル(VARLiNGAM、VARMALiNGAM)

時系列(過去・現在)のロジックを追加します。

データ構造変化モデル(LongitudinalLiNGAM)

時間軸でのデータの構造変化を考慮します。

複数データグループモデル(MultiGroupDirectLiNGAM)

複数のデータグループが存在する時、単独でそれぞれLiNGAMを行うより、まとめて行う方がよい精度が出るように考案されたモデル。

以上、その他にも多くのモデルが提唱されていますので、ぜひ試して記事を書いてみてください!

注意点

コードを実際に動かしてみると、実務に簡単に適用できそうと思いました。しかし・・・実務のウラでテストしてみると、実務適用に難しい点が何点も出てきました。

グラフ構造を指定しないと、推定が全くうまくされません

特定のモデルでは、グラフの開始ノードと終了ノードが指定可能です。

ある実データ(売上データ)を使い実験してみました(5例すべて)が、構造を指定しないとうまく予測されませんでした。指定しない場合、一般的と考えられる因果構造と逆、例えばユーザー継続の原因が売上のような結果が出てきました。

データ量が少なすぎると、結果が出力されません

ある実データ(売上データ)で1年間・週ごと(48=4週×12か月)かつ20カラムのデータでは、結果が表示されませんでした。

検証方法がわかりません

カイ二乗検定を使います。つまり、期待値からどれくらい値が外れているか(=有意な差があるか)の指標で判断します。
(因果探索: 基本から最近の発展までを概説 P.37)

ただし、どれくらい値が大きくなれば適合している・していないと言えるのか基準がわかりません。使うとすれば、同じ取得条件のデータで、指標を比較して使うべきでしょう。

SEM(Structural Equation Modeling)との違いが判りません

比較したモデルは、Python LiNGAM(Direct LiNGAM)とSPSS AMOSです。

ある実データ(売上データ)で実験を行いましたが、グラフ構造を指定した場合はほぼ同じ結果(因果の方向、係数の相対的大きさ)が出てきました。ただし、係数の実数値は大きく異なりました。

おまけ:LiNGAMの解き方


1. 独立成分分析(ICA)

DirectLiNGAMと比較してICALiNGAM呼ばれる理由でもある。

2. 復元行列WをAの逆行列から求める

3. ハンガリアン法による最小化

4. 行の順序入れ替え

ICAは行の識別性がないので、入れ替える必要がある。

5. 単位行列Iを除く

6. 因果方向・効果量を特定する

結果. 構造方程式で示すことができる形となる

まとめ

今回は、統計的因果探索のLiNGAMを紹介しました。
「因果構造を把握することで、何をすれば購買につながるのか?」ということは全世界のマーケターをはじめ、購買に関係する社会人は知りたいでしょう。

ただ、実データで利用するとしても問題点があります。

科学的なデータとは違い、そもそもの答えが分からないのです。心理的な背景がどうなっているか、それがどうなるかは私たちの知りうる範囲ではありません。そのため、大規模に実験しづらい問題があります。

なぜなら、時間を掛けて上手く行くかどうかわからないことを試す余力はないからです。何度も何度も実証を重ねて、一般的な因果構造を理解するとどれくらい儲かるのでしょうか?投資対効果が全く分からないのです。

かつ、個人によって因果構造が違うのではないかという懸念もあります。一般的な科学的モデルであれば、因果構造は一定です。経験や環境によってヒトは判断を変えうるのです。それを推定できるのでしょうか?

そのようにいろいろと問題は山積していますが、私はまずは1つやってみなければ始まらないと思っており、データ分析案件実施上の空き時間でテストをしていました。

色々と認識違いがあるかもしれませんが、その際はコメントいただけると幸いです。皆さんもぜひ試してください!

参考文献

発明者の清水さんをはじめ、多くの方の書籍・文献を参考にさせていただきました。
統計的因果探索 (機械学習プロフェッショナルシリーズ)
因果探索: 基本から最近の発展までを概説
LiNGAM: Non-Gaussian methods for estimating causal structures.
つくりながら学ぶ! Pythonによる因果分析 (Compass Booksシリーズ)
etc…

より深く勉強したい方へ

【教材紹介】入門統計的因果推論で因果推論、グラフ理論の基礎を学んでから、清水先生著作の【教材紹介】統計的因果探索を学ぶことでより深い理解が可能です!

[社内コンペ] 間取り予測

これは何?

某社で行われている社内コンペのメモです。私の備忘録でもあります。

結果:3位
精度:60.7%

今回は学習データが12,000件ほどあり、ある程度多いデータ量での学習ができました。
学習データは評価データと分布が同じとされていましたが、それはちょっと怪しかったかなと思います。

今回の目的変数

「その部屋が何の間取りに種別されるか」のテーブルデータの多値分類問題です。

回答は、
・3LDK
・2K
・1K
などとよくある形です。目的変数の種類が多い(最大38個)ことを除けば。

今回の評価指標・ベースレート

Accuracy(精度)です。

出題者によると、お試しの意味も込めてAccuracyだそうです。
普通なら複合指標による評価が妥当とされています。
Precision(適合率:真の陽性をいかに漏れなく見分けられたか)やAUC(認識性能の高低を表す)、MAP(Mean Average Precision、Precisionの応用)などなど。

ベースレートはAccuracy50%でした。

僕は、検証の際はAccuracyを用いていました。
今回は別の目的があり、全く工夫をしませんでした。

今回の説明変数の特徴

テーブルデータ

訓練に使用できるのは12,000データ

同じような目的変数がある

 3LDK、3DK、3K・・・違いが判らん!
 それらのデータの特徴量も似たようなものでした。
 つまり、ルールベースで分けたほうが精度が上がる目的変数のグループも存在しました。
 ルールベースで分けること自体はKaggleやSIGNATEではあまり言及されませんが、現場ではよく使われる手法です。実データはデータ量が足りない場合も多く、環境が整っていないからその手法採用されているだけで、本来のデータが潤沢にある状況であれば予測すべきです。

説明変数の作成が手入力(で雑)

 家探ししているとよく見かけるのですが、敷金、礼金は家賃の〇か月分ってありますよね?
 その値が手入力のようで、一致している場合もあればしていない場合もありました。

 例を挙げると以下のようになっていました。
 ・家賃:8万
 ・敷金(家賃の〇か月):2
 ・敷金額:12万円 ← What’s?????

今回の目標

特徴量生成のみで乗り切る。
(一応3位なんで乗り切れたと思いたい。)

今回行った特徴量生成の方法

データの適正化

手入力が多かったので上記のようなことが起こっていました。

グループ平均との差分を取り、標準偏差で表す

例えば、「その地域の家賃平均から高ければ高いほど、大きな部屋である可能性が高い」を数値化しました。

グループ内での順位を取る

上記と同じ考え方です。

業者の電話番号は業者ごとに存在すると考え、ラベルエンコーディングで特徴量化しました

建設業者はそれぞれの得意な分野(大きさ、形、場所)があり、棲み分けがされているようでした。
施設管理・施設設計をしていた経験からそう判断しています。施設の発注代がとても高かった記憶があります。(‘A`)

UMAPでの次元削減

t-SNEと同様でしたが、計算速度が速い・・・ハズ。
ただ、計算リソースが少ないPCだと結構エラーが出るので面倒でした。
Kaggleであった同様のコンペでは効果があったようですが、今回はあまり意味がなかったです。

K-Meansクラスタリングで教師なし学習結果を特徴量化

大分類で8クラスに分かれることが分かったので、それぞれの確率を特徴量としました。
あまり意味がなかったorz

その他の情報

モデル:XGB+LGBM(23:1)アンサンブルモデル
バリデーション方法:層別K-Fold(9:1)
パラメータチューニング:Optuna、Optuna LGB

その他の解法

パラメータチューニング

Kaggleで勝つデータ分析の技術P.318-320に載っているパラメータチューニング方法を、XGBにそのまま使うと大分上手くいったようです。

Optunaはベイズ最適化なのである程度は上手くいきますが、より精度を高めるのであれば手動をお勧めします。
それをしないと無理な境地がありそうです。
Deep Learningを含めて全部できるのはスゴイと思う。計算速度の良いPCが必要だ・・・お金足りないよ。
Optuna LGBは初めて使いましたが、Optunaに比べコードがかなり簡略化されており、初心者にも扱えそうで便利でした。

※個人的に、Kaggleはデータ分析というよりデータモデリングが主だと思っている。

スタッキング

よく使われるようになった手法。
ただし、今回はあまり効果がなかったようです。

※私は使ったことはない。

最後に

間取り予測して何に使うんですか?
目的がわかってない、分析では最悪なパターンです。

コンペに参加する目的が最近の手法の大枠を捉えなおすことなので、ボチボチ更新できたかなと思う程度でした。
日本語のはある程度読みましたが、海外の資料や論文は10も読まなかったかな。
この考え、動き方を社内でできる人を増やす方向で動いているので、あまり時間を割きたくないという理由もある。

やってみたではなく、何を考えたか、なぜそう考えたかを包括的に書いた記事が少ないので、少しずつですがアップしていこうと思います。
その他コードやデータサイエンス関連の質問はR:Twitterまでお願いします。

決定木分析(Python CHAID)を解釈する

意思決定のために使用される決定木分析

Scikit-learnでの決定木にはCART(指標:giniまたはentropy)他が採用されています。
CARTは下記の2点を含め、さまざまな理由から使われていません。

  1. 2分岐のみのため単純すぎる
  2. 過学習させるアルゴリズムのため、小さすぎる区分が出現するので扱いにくい

コードは以下の通り非常に簡単です。

from sklearn import tree
clf = tree.DecisionTreeClassifier(max_depth=3)

(参考:scikit-learn で決定木分析 (CART 法))

実務では各種BIでのCHAID(指標:カイ二乗値)が使われています。
利点としては、以下の2点が大きいです。

  1. 多分岐
  2. 過学習する前に学習を止める

Pythonには決定木(CHAID)の一般的なライブラリがないので、今回はライブラリCHAIDを紹介します。

概要

下記のツイートにまとめています。
まずはREADMEを読んでCHAIDをインストールしてください。
GraphvizとOrcaのインストールは項目Exporting the treeをご覧ください。

Graphvizインストールできない問題の対策

Windows10の場合、pipではなくcondaで入れるとうまく行きました。

conda install graphviz
conda install python-graphviz

Graphvizのbinとdot.exeまでの環境パスは通しました。

CHAIDテストコードにCSVを読み込ませる方法

下記コードで対応可能です。

df = pd.read_csv('sample.csv')

col_answer = 'flag_keizoku'
ndarr = df.drop(columns=col_answer).values
arr = df[col_answer].values

検証

CHAIDとBIツール(今回はSPSS)との差分を検証しました。

検証方法

実データから決定木を出力してみる。

説明変数

ある2週間(1-14日)にログインしたユーザーの総ログイン日数
*開始日を1日目としてカウント
*値=1~14

目的変数

ユーザーごとの15-28日目の継続有無
*ログインしたかどうかで判別
*値=0 or 1

結果概要

SPSSだとある程度グループ化されるのでしきい値の判断はしやすいが、CHAIDはグループ化されず数値が前後してしまうため解釈が難しい。
解釈のために使っているのに、解釈が難しいとは・・・使えないやんって話です。

結果詳細

SPSS


グループは7個できました。
[1], [2], [3-5], [6-8], [9-11], [12, 13], [14]

CHAID


グループは11個できました。
[1], [2], [3], [4], [5, 7], [6, 8], [9, 10], [11], [12], [13], [14]
*個体数nが描写されない問題。コードでの確認は可能ですが、可視化したグラフとしては使いにくい。

結果解釈

前の2週間のログイン日数が多いほど、次の2週間でいずれかの日にログインしている可能性が高い。

うん、そうだね・・・(当たり前)としか言えないのですが、どれくらいの日数ログインしていないと継続しにくいか?を知るには良い結果となります。

14日ログインしている人のうち、3.8%がログインしてないってまずくない?という感じで解釈していきます。

その他には、時系列で比較することで、継続率の効果検証を行うことができます。

仮説:継続を構成するユーザーのうち、どの層のユーザーの継続率が上がったのか?
→ 全体的に上がったのか?
→ 特定のユーザー層にのみ効果があったのか?

のように細かく調査することができます。

このCHAIDの何が問題か

決定木分析はあくまで、いい感じで区分を作り、その結果を解釈して施策に繋げるために行っているので、グループ化があまりに細かく、理解しにくいモノだと使えません。

SPSSに比べ、CHAIDのカイ二乗値は高いですが、適切なグループ化をしていないので、人が使うためには、このCHAIDはめちゃくちゃわかりにくい。

結局、意思決定のために分析をしているのに、読み取れない…のようなことが起こりえます。

そういった懸念点があっても、このCHAIDは無料ですので、コスト面を考えると使う価値はありますね。SPSSはライセンス料がかなーり高いので、個人で要因分析する分にはCHAIDで問題ないでしょう。