試合で一球ごとの分析用DBを追加しました。
なぜかというと、試合での投手vs打者における投球と打撃結果の因果関係が分からなかったからです。
もっとカンタンニシテ・・・
例えば・・・
どのコースは打たれにくいのか?
変化球で打たれにくい球種はあるのか?
ヒットになるとすればどのコースに飛んでいるのか?(守備はどこに重点を置くべきか?)
に答えるためです。

とりあえずは作りました。(使えるとは思うけど・・・)
今からデータ収集するので使えるようになるには半月くらいかかりそうですね。
Webサービス制作のための技術情報を。データ分析(Python、機械学習コンペ他)や自作野球ゲームMeisyoのこと中心。
試合で一球ごとの分析用DBを追加しました。
なぜかというと、試合での投手vs打者における投球と打撃結果の因果関係が分からなかったからです。
もっとカンタンニシテ・・・
例えば・・・
どのコースは打たれにくいのか?
変化球で打たれにくい球種はあるのか?
ヒットになるとすればどのコースに飛んでいるのか?(守備はどこに重点を置くべきか?)
に答えるためです。
とりあえずは作りました。(使えるとは思うけど・・・)
今からデータ収集するので使えるようになるには半月くらいかかりそうですね。
他のサイトの説明が釈然としなかったので投稿。
以下のref0~2番のホストを抽出したいとする。
ref[0] = "http://www.other.com/path1/index.php?k1=v1&k2=v2#Ref1"
ref[1] = "http://www.other.net/path1/index.php?k1=v1&k2=v2#Ref1"
ref[2] = "https://www.other.com/"
*ホスト名 0 = www.other.com
SQLでは以下の通り。
substring(ref from 'https?://([^/]*)')
出力は[0] = www.other.com
関数:
substring(抽出文字列, 開始桁, 切り取り文字数)
正規表現:
(1)https?
「?」の使い方:「X?」=Xを0or1文字
httpの後に「sを1文字」または「何もつけない」という意味。
[http|https]と同義。
基本SSL準拠でないと警告が出る仕組みになったので、今後はhttpsが増えてくると思います。
(2)([^/]*)
分解して考えると、[^/]に*が付いて、その外側に()。
手順1. [^/]は「^ = ではない」「/」を[](1文字)なので、
「/」ではない「1文字」と読み替える。
手順2. *は直前の文字の0回以上の繰り返し(最長一致)なので、
「/」ではない文字が出てくるまでの文字列が出力される。
手順3. そこに() = フォーカスする。
ということで、0ではwww.other.comが出力される。
手順3をなしにしてみると・・・
substring(ref from 'https?://[^/]*')
[0] = http://www.other.com が出力される。
さらに、変な位置に()をつけると、
substring(ref from 'https?://([^/])*')
「/ではないの文字列の最後の一文字」を出力できる。
つまり、0の場合comの最後のmだ。意味があるのかは置いといて。
[^/]を[^.]に変えると、
substring(ref from 'https?://([^.]*)')
最初の「.」までのwwwが出力される。
とまあ、こんな感じで分解して考えるといいだろう。
「練習ごとに難易度が違いすぎるんですけど!!」という不満は把握しています。
ただ、これまでそこには触れてきませんでした。
なぜなら・・・まだデータ取れてないし、分析できないでしょ(言い訳)
・・・怠慢デスネ!
とりあえず大枠でざっくりと分析します。
データ取得開始~2019/02/28
| sub | action  1 |
point_avg | point_stddev |
|---|---|---|---|
| practice | 5 | 26 | |
| practice | game1 | 146 | 53 |
| practice | game10 | 142 | 45 |
| practice | game11 | 189 | 35 |
| practice | game12 | 112 | 55 |
| practice | game2 | 148 | 39 |
| practice | game3 | 169 | 53 |
| practice | game4 | 87 | 38 |
| practice | game5 | 134 | 53 |
| practice | game6 | 112 | 55 |
| practice | game7 | 142 | 41 |
| practice | game8 | 144 | 59 |
| practice | game9 | 133 | 35 |
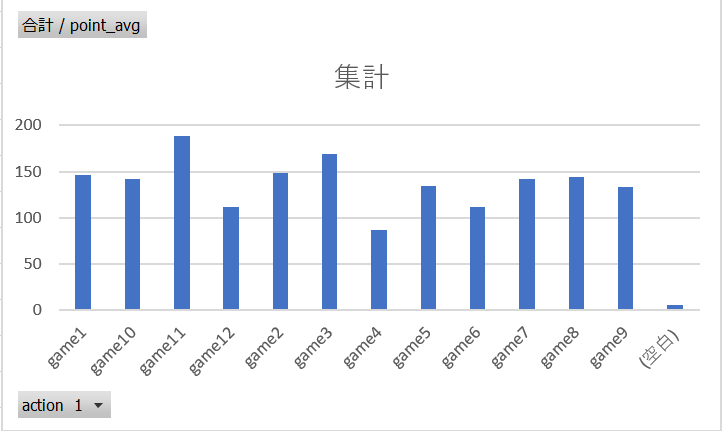
すると、game4が難しくて、game11が簡単なのでは?という疑問が生まれてきます。
game4

game11

「あっ・・・確かに。」とプレイしている身からは腹落ちします。
だってgame4で200ポイント=5ビンゴしないもん。無理。
game11は簡単すぎて笑えないし。
コードは以下の通り。
SELECT
	sub
    , SUBSTRING_INDEX(action, ',', 1) AS action
    , CEIL(AVG(SUBSTRING_INDEX(action, ',', -1))) AS point_avg
		, CEIL(STDDEV(SUBSTRING_INDEX(action, ',', -1))) AS point_stddev
FROM
	acts
WHERE
	sub = 'practice'
	AND time < '2019-03-01 00:00:00'
GROUP BY
	SUBSTRING_INDEX(action, ',', 1)
ORDER BY
	action;
今回の分析の目的は、「練習の得点をだいたい150%平均くらいにしたい」にします。
目的が決まっていないと、分析したけど「で?どうすんの?」という話なので。
下記の流れで進めます。
1・分布の確認。(現状把握)
2・目的達成へのアプローチを考える。(仮説設定)
3・分布の推移を見る。(効果検証)次回以降
このように、現状把握→仮説設定→検証→・・・の流れで進めます。
まあいたって普通な流れですね。
ゲーム:ストップウォッチで*秒で止める。

集計データ:
平均:146
標準偏差SD:53
「とりあえず目標は達成してるんじゃないかな?」と思います。
分布:

集計データから一転、「正規分布とは一体どこへ・・・」みたいな分布になっています。
「得点が正規分布する=ユーザーは成長しない」という前提に立っていることに注意してください。
「十分にプレイした後(=伸びしろがない状態)で集計する」なら正規分布するであろうと。
考えられる仮説としては、「最初はユーザーが慣れていなかったが、慣れたら簡単だった」という。
ならユーザー毎の時系列での成長傾向を調べようってなりますね。
\そもそも数が少ない/
数が少ないと継時変化のデータの取りようがない。
コードとデータは以下の通り。
データ:
meisyo_acts_20190303.sql
SQLです。PHP MyAdmin等に即インポートできます。(ゴミデータも混じってるので扱いには注意が必要)
SEQというseqカラムに0~999まで入れたテーブルを別途作成してください。
コード:
21行目の「game1」を変更すれば、全練習に対応可能です。
SELECT
	SEQ.seq as point
	, COALESCE(ACT.count, 0) as count
FROM
	(SELECT
		(seq * 10) AS seq
	FROM
		an_seq
	WHERE
		seq BETWEEN 0 AND 20) AS SEQ
LEFT JOIN
	(SELECT
		SUBSTRING_INDEX(action, ',', 1) AS act
		, CEIL(SUBSTRING_INDEX(action, ',', -1)/10)*10 AS point
		, count(*) AS count
	FROM
		acts
	WHERE
		sub = 'practice'
		AND time < '2019-03-01 00:00:00'
		AND SUBSTRING_INDEX(action, ',', 1) = 'game1'
	GROUP BY
		act, point
	ORDER BY
		act, point) AS ACT
ON SEQ.seq = ACT.point
ORDER BY
	SEQ.seq
;
実施内容:
とりあえず150点くらい取れるので、game1は何もしません。
ゲーム:任意の桁数の数値を打ち込む
集計データ:
平均:148
標準偏差SD:39
とりあえず150近くだし問題ないよね
分布:
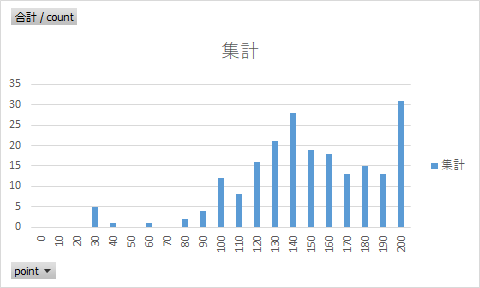
200が多いのが気になる。30もあるのか・・・。
ただし、平均が140あたりで正規分布の山を作っていると仮定すると、
真の200が15、210が10、220が5(合計30)と予想できるので、それが200に積まれている・・・のかな?
問題なさそうですね。
実施内容:
何もしなくてOK。
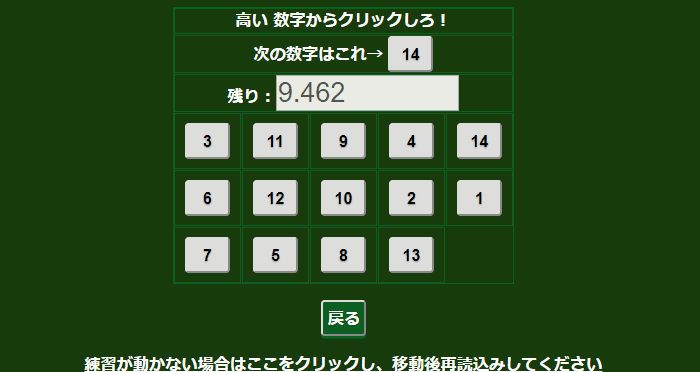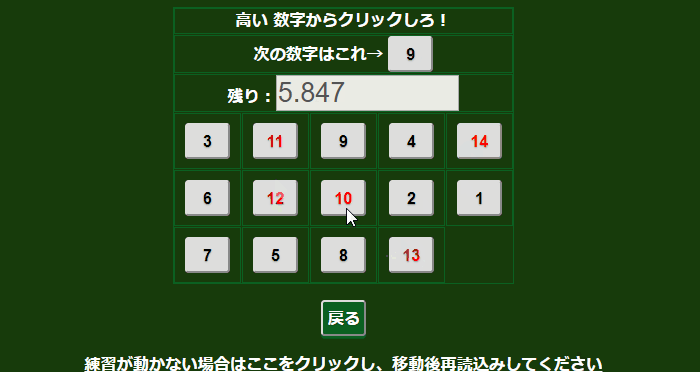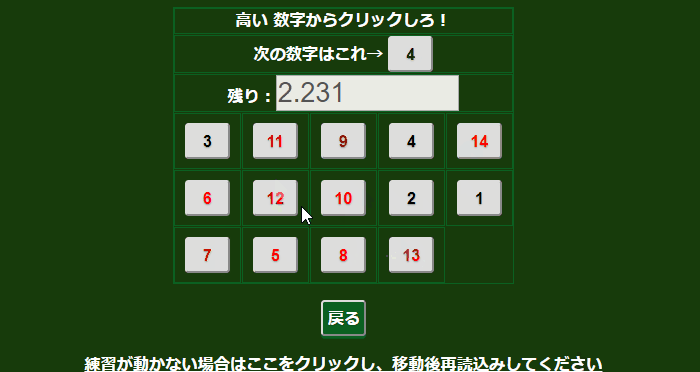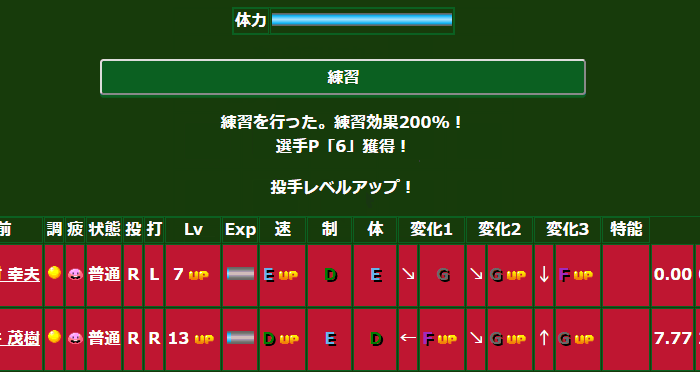
ゲーム:指定された順番に文字をクリックしていく
集計データ:
平均:169
標準偏差SD:53
ちょっと高いような気がするので、下方修正を掛けたい
分布:
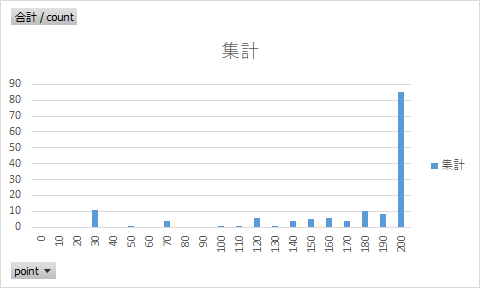
簡単すぎたワロタ・・・
集計データと全然印象が違いますね。
現在は1数字=0.8秒で計算しているので、それを調整します。
では、何秒にすればいいのか?
ちょっとよくわからないですが計算してみます。(正しいかどうかは置いといて)
現在は147回中、得点が200に85回(57.8%)集中しているので、
真の中心は200より右にあることが想定できる。
加えて、グラフの通りこの分布は一様分布(各得点の分布が同じくらい)であることを仮定できる。
一様分布のため、真の200が10程度(6.8%)とすると、210以降に分布する確率は50%となる。
そのため、平均値は200~210の間になる。
現在の1数字あたり0.8秒であると、平均値は200~210(205とする)。
1数字あたり0秒とすると、平均値は0になる。(そりゃそうだ。実際は最低補正25が入るんだけども。)
数字あたりの秒数が平均値と正比例すると仮定すると、係数は「256.25 * 秒」となる。
この値が150程度になってほしいので、
256.25 * 秒 = 150
ゆえに、秒=0.585
実施内容:
1打=0.585秒に修正する。
結構無理やりな気がする。ただ効果の検証を行えれば、この仮定(数字あたりの秒数が平均値と正比例する)が正しいか確認できる。
で、200から下に分布の中心が来たら、正規分布等々の推定ができる。
今はどっちもわからないので、とりあえず試そう。
ゲーム:スロットマシン。すべての数字を一致させたい。(願望)
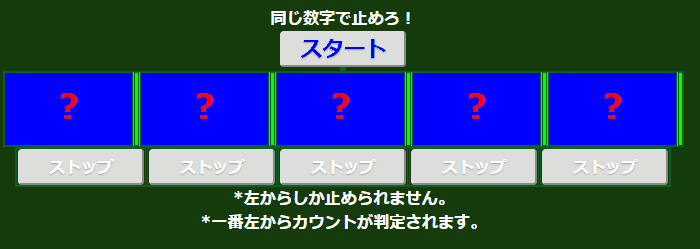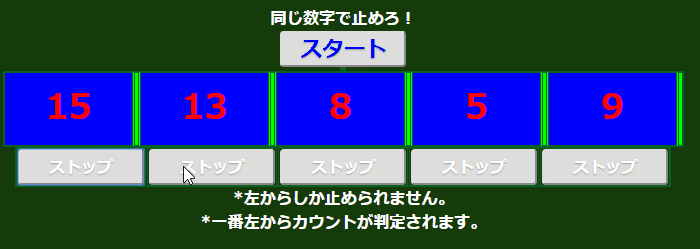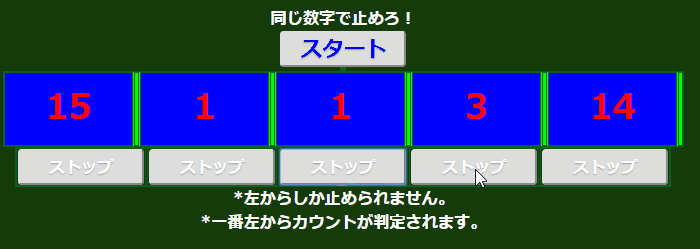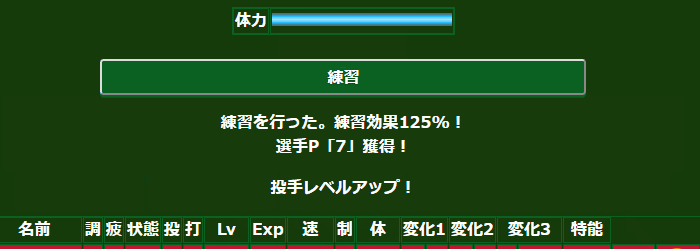
集計データ:
平均:87
標準偏差SD:38
とりあえずヤバい(語彙力)
ちなみに得点最下位なので、てこ入れは必須ですね。
分布:
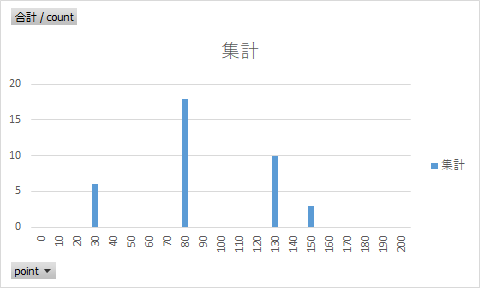
意外とまともな分布かもしれない。平均値は置いといて。
200も一応存在するんですが、誰一人として到達しませんでした!
条件:
・数字は1~15。
・スロットの数は5個。
・得点(ビンゴ数)は、25(0),75(1),125(2),150(3),200(4)の通り。
・各スロットの速度(更新速度(ms))は、120,100,80,65,50。
合計試行回数37って少なくない・・・?他は200まで行っているものがあるのに。
毛嫌いしてるんでしょうか。僕もコレ嫌いです。
ビンゴ3個(X-X-X-X-n)で約8%。
場合分けで考えられないのが厳しい・・・。
なぜなら、それぞれのスロットの速度が異なるから、目押し成功率との相関係数を仮定しないと計算できないため。
更新速度が早ければ早いほど、狙う数値(±0)からの誤差が大きくなって分布の形が平べったくなっていく。
-2:|
-1:|||||
±0:|||||||||||||||||||
+1:|||||
+2:|
↓ 速度が早いと・・・
-2:||||
-1:||||||
±0:|||||||||
+1:||||||
+2:||||
ということで、更新速度をすべて統一し、100msとします。
もし、反応速度が200±10msならば、狙っていさえすれば1回86.2%程度の確率で当たる。
(0~100msを10msごと(10個)に分け、正規分布をとるとすると、片側検定の考え方で、(4*100+2*97.5+2*83.5+2*50.0)/1000=0.862)
で、面倒なこととしては、スロットで外れた値も当たり値としてカウントが可能なところ・・・と思っていたら、そんなことはなかった。
一番左の数に当たっているか?当たっていたらその数値が最優先される。
つまり、「15」「1」「15」「1」「1」でも2HITになる。
4回当てる可能性は・・・0.862^4 = 55.2%
(ん?これで計算合ってるの?)
ちなみに、ヒトの光刺激に対するボタン押し反応の速度は209ms(SD:10)(反応時 間研究の歴史と現状)だそうです。集団で反応速度を計測しており、個人として平均±SDを出しているわけではないので本当は参考にしてはならない。
実施内容:
更新速度をすべて統一し、100msとします。とりあえず。
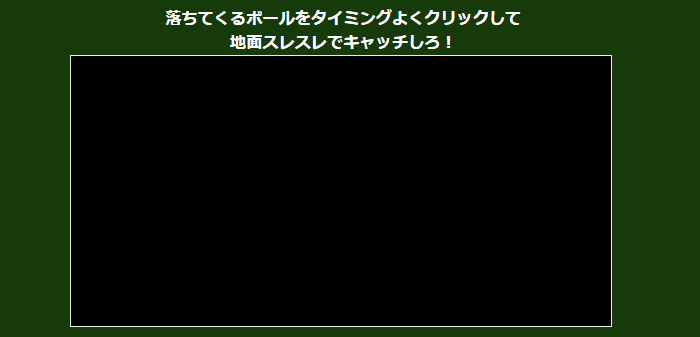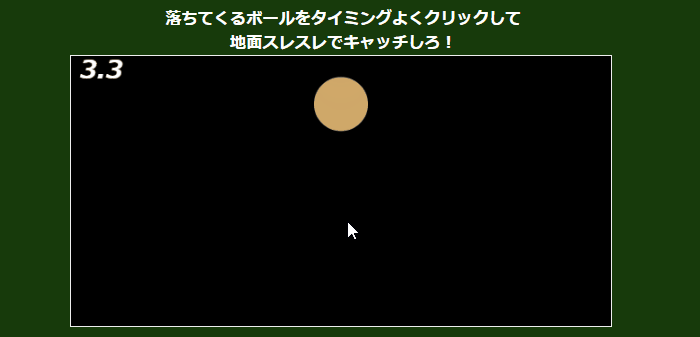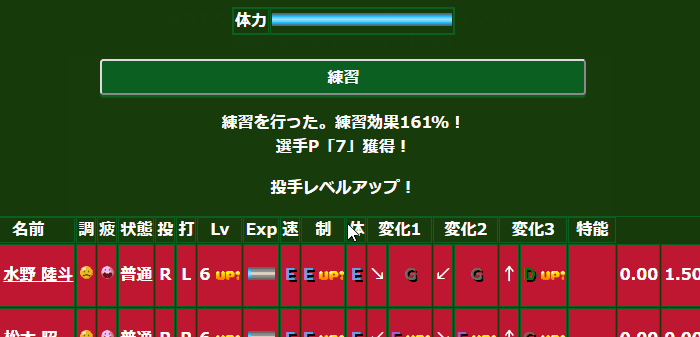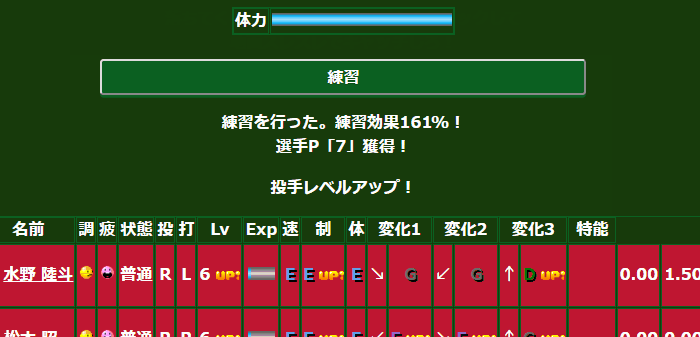
ゲーム:落ちてくるボールをタイミングよく中心でキャッチする。
集計データ:
平均:134
標準偏差SD:53
少し(10%)低いような気がします。
分布:
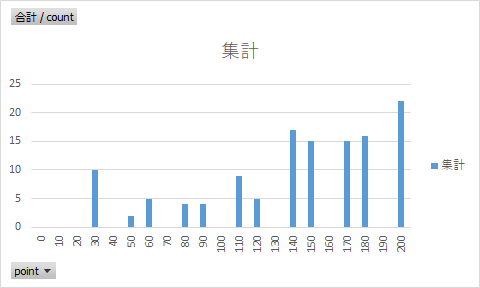
何とも言えないのですが・・・。
分布もまあまあ悪く・・・ないのか?何と言えばいいのかわからない。
ポイントの計算式は、goal(誤差ms)に-300を掛けるというおおざっぱなモノです。
myGame = -300 * Math.abs(goal) + 200;
平均134ということは、-66 = -300*(goal)
AVE(goal) = 0.22s
goal係数 * NEXT = -50にしたいので、
goal係数 = -227
実施内容:
goal係数を-227にします。
ゲーム:落ちてくるボールをタイミングよく中心でキャッチする。(縮尺変更、距離変更あり。)
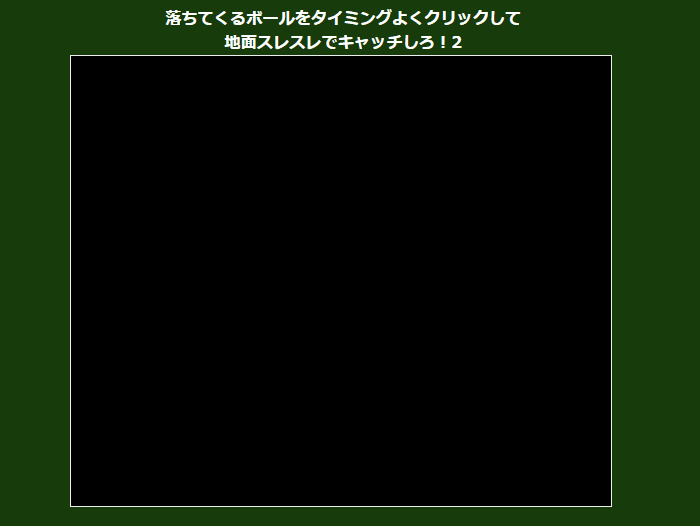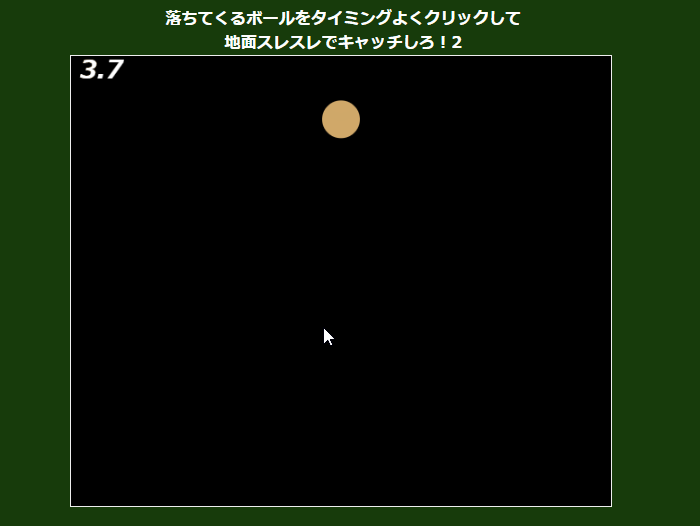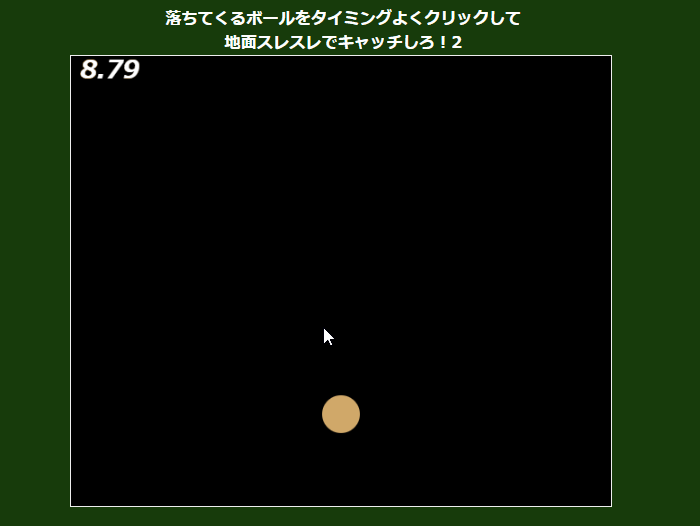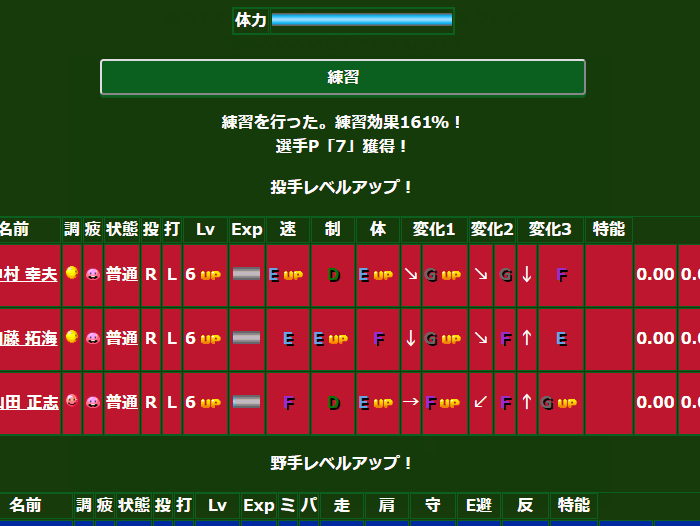
集計データ:
平均:112
標準偏差SD:55
ん~・・・正規分布なら、標本内の20%程度しか150を超えていない。
上方修正が必要そうですね。
分布:
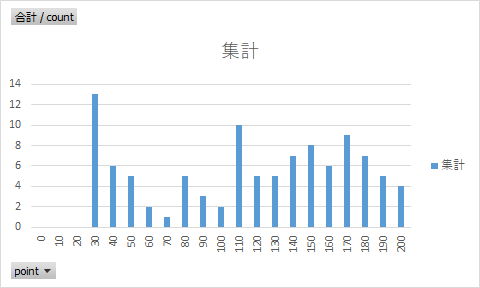
結構25が多そうやな?
縮尺(落ちる距離)がランダムで変化するので、プレイしてる側からしてもちょっと対応が難しいかもしれません。
チリみたいなのがたまに出るので・・・アレほぼ見えないです。
データ数が少ない!!
あとランダム性があるので、それをすべてまとめて分析しても因果関係が不明。
困った・・・。
というわけでgame5と同じことをします。(安直)
実施内容:
goal係数を-227にします。
ゲーム:振り子2つを中心に合わせられるようクリックする。

集計データ:
平均:142
標準偏差SD:41
とりあえず平均的だしいいよね。
分布:

ああ・・・なんだかとってもいい分布(錯乱)
割ときれいに分布しており、平均値もぼちぼちいい感じなので、
とりあえずこのままで。
実施内容:
何もしません。
ゲーム:ちょっとだけ違う色(濃淡)を判定する。

集計データ:
平均:144
標準偏差SD:59
これもまずまず。変更しなくていいかも。
分布:
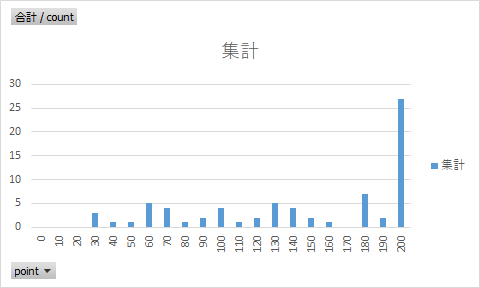
200多くない・・・多くない?(37.5%)
感想としては、そんなに早く見分けつくかなあと思いました。
携帯とかだと特にわからん気がするんだが。(色識別は苦手かもしれない)
何とも言えないのでこのまま置いときます。
実施内容:
何もしない。
ゲーム:色のついたタイルを高速でクリックする。
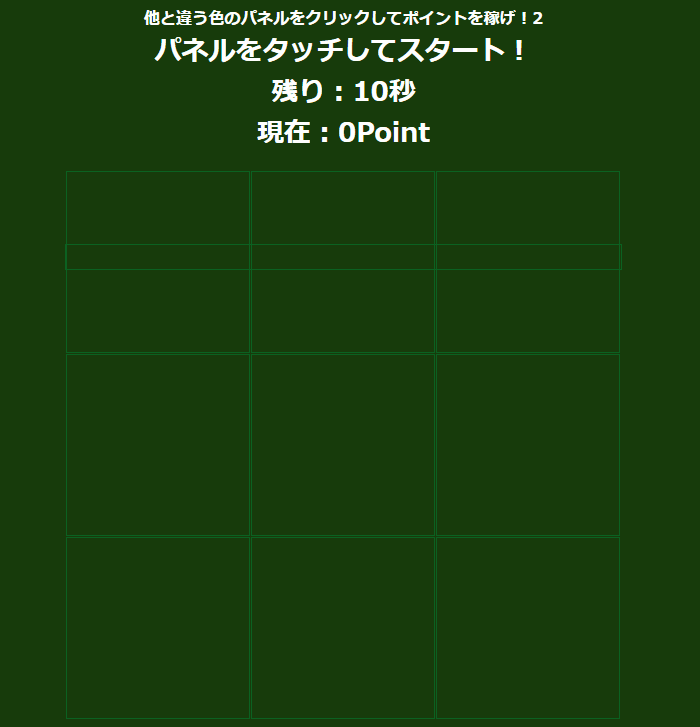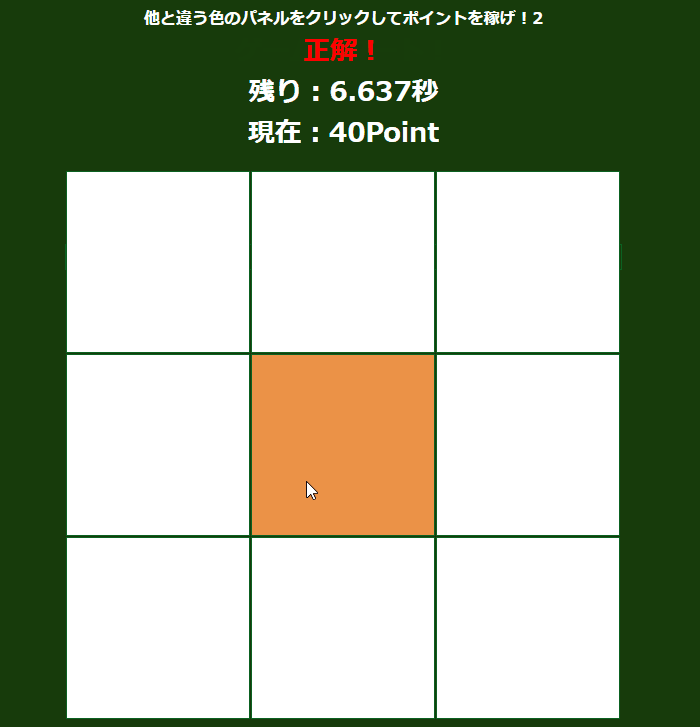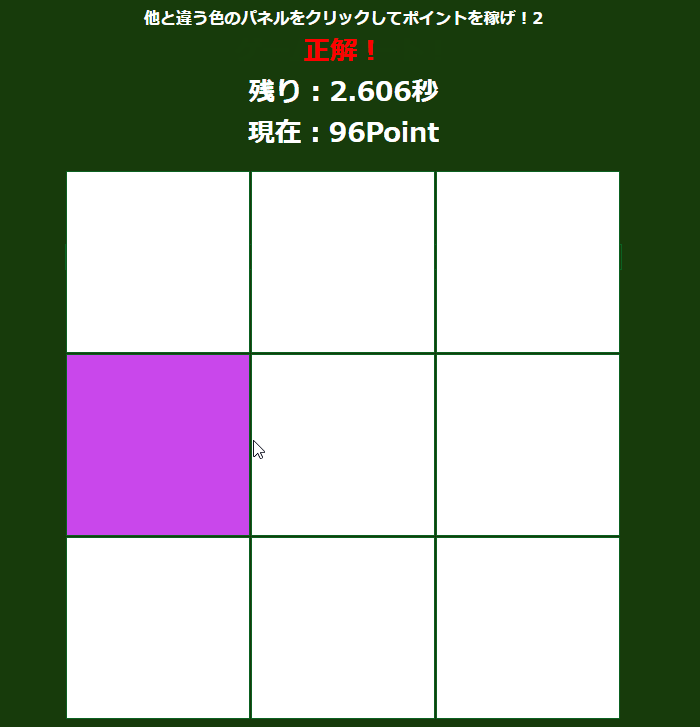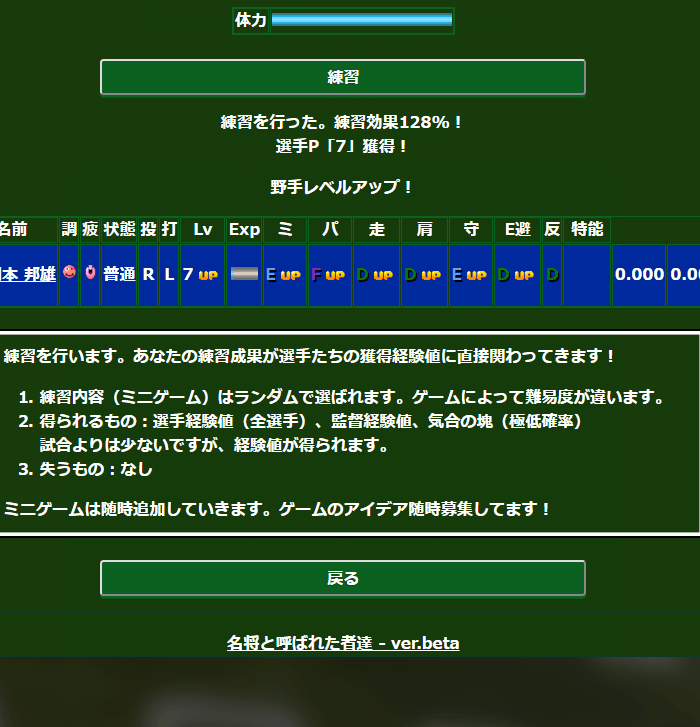
集計データ:
平均:133
標準偏差SD:35
少し(10%)上方修正すべきかな?
分布:
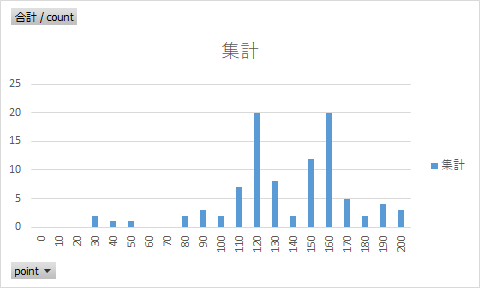
正規分布してそうだけども・・・。
ゲームとしては正解1個辺り8Pずつたまっていく。
10秒で終了。
200P=25回って0.4sに1回正解するのか。すげえな・・・。
120と160が高い理由としては、もしかして8P(10Pではない)に関わるのでは?
得点は、80, 88, 96, 104, 112, 120, 128, 136, 144, 152, 160, 168, 176, 184, 192, 200を取る。
やはり・・・120と160に割り振られる値は2個ありますね。(144が欠損してそう)
そうして見ると、山がちょうど150になってそう。
何もしなくていいかなと思いました。
実施内容:
何もしません。
ゲーム:わしが考えた最強のマインスイーパーもどき。(クリックするとゴールまでの距離が出る。)
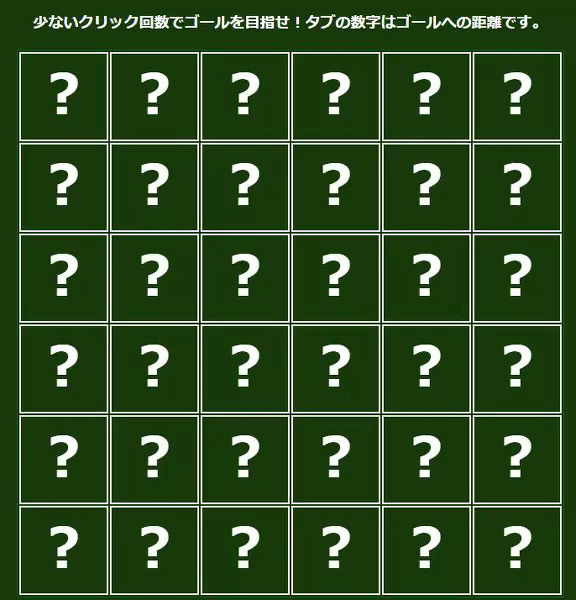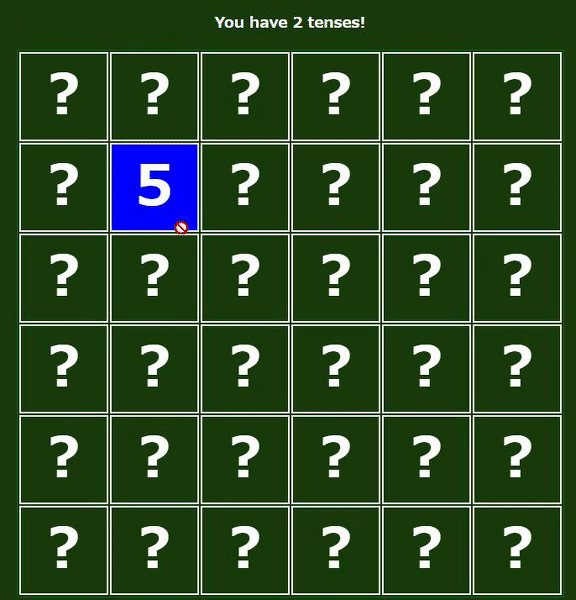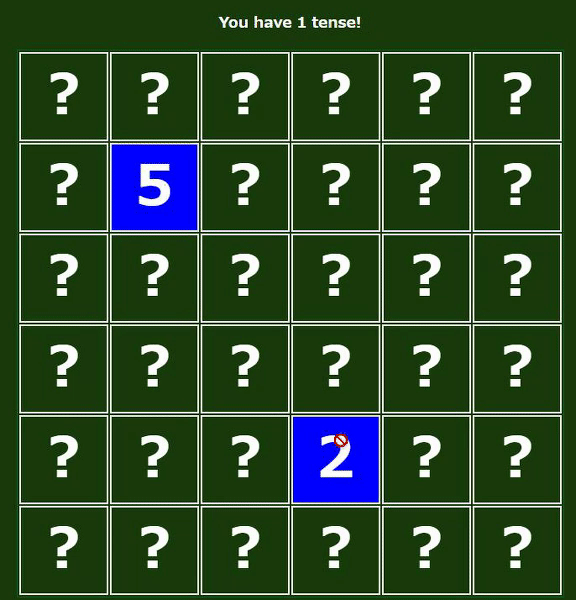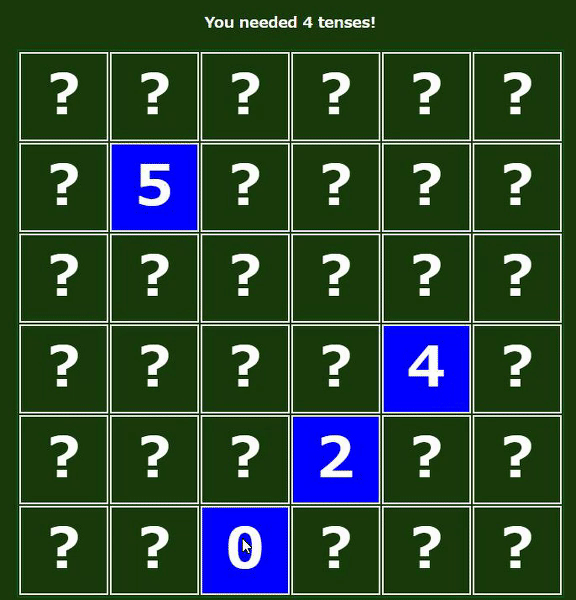
集計データ:
平均:142
標準偏差SD:45
大丈夫だ。問題ない。
分布:

まあ良さそう。
これは得点(正解までの手数)を25(5~),50(4),100(3),150(2),200(1)を取ります。
分布としてもまあまあ合格点だと思います。
意外と頭使うのと、運要素が大きいかも。
これを機械に探索させると面白そうですね。
実施内容:
何もしません。
ゲーム:他と違う数のパネルをクリックしていく。
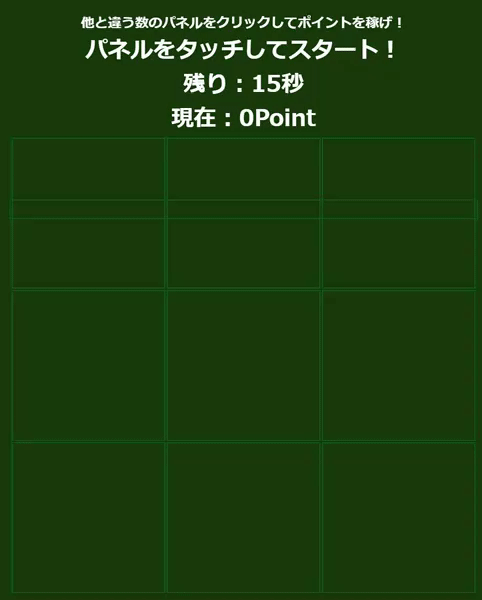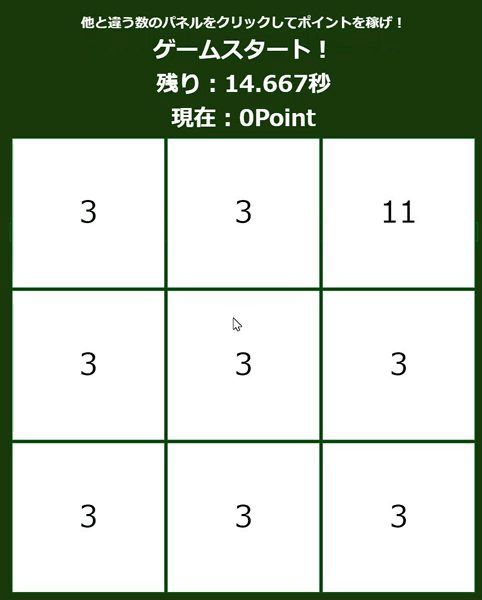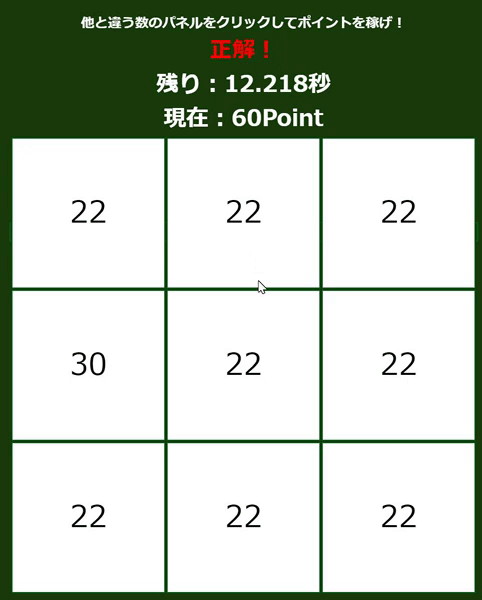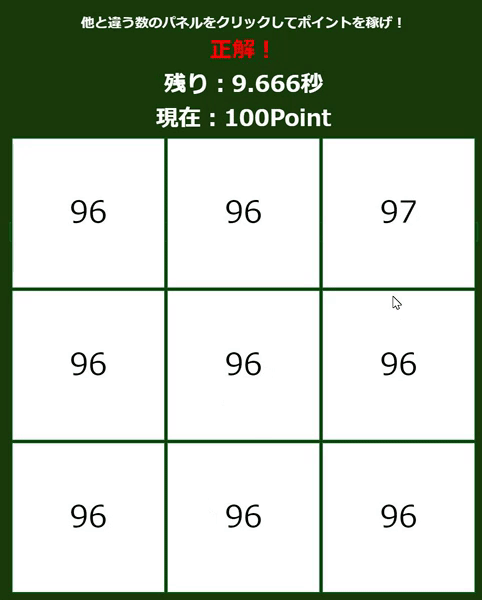
集計データ:
平均:189
標準偏差SD:35
簡単すぎぃ!
分布:
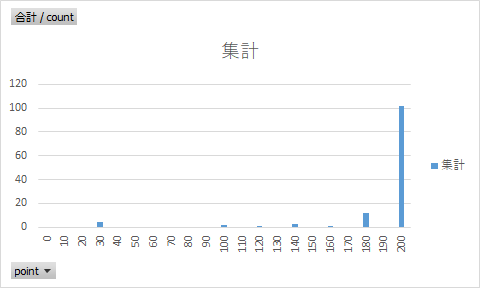
簡単すぎぃ!
ということで、ゲームの基礎情報のおさらい。
ゲーム時間:15s
ポイント:1回正解で20p
・・・たった10回正解すればいいのに、15sもあるの?
game9は0.4sに1回(10s、1回8p)なのでそれと同等にしよう。
(あっちは色判別だけなのに、こっちは文字識別が必要・・・だぞ?)
実施内容:
ゲーム時間:15s→10s
ポイント:20p→10p
ゲーム:反応速度ゲー

集計データ:
平均:112
標準偏差SD:55
ちょっと上方修正必要では・・・
分布:
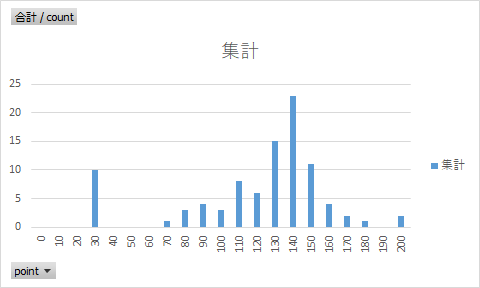
悪くはないけど、ちょっとシビアかなあ。
左裾が伸びている。(だからどうした)
まあミスしてる人も多いのでこんな感じかと。
得点は以下の数式で与えられる。
myGame = (0.8 – Math.abs(myTime)/1000) / 0.7 * 200
反応が0.1s以内なら200点以上・・・って。
いやちょっと待て。人間の限界は0.15sくらいのはず。FPSの上手い人でもその程度だった気がする。
計算すると平均112が反応速度0.40s・・・?
この前提から考えて、式を変更してみる。
myGame = (0.8 – Math.abs(myTime)/1000) / 0.7 * 200
↓
myGame = (0.9 – Math.abs(myTime)/1000) / 0.7 * 200
これでだいたい平均が142になるはず。
実施内容:
(得点の変更)myGame = (0.9 – Math.abs(myTime)/1000) / 0.7 * 200
game1~12までのデータを分析し、練習難易度の不均衡是正を目指しました。
とりあえずこの内容を今日から施行し、1か月後(4/1ごろ)に3/4~4/1のデータを分析したいと思います。
因果関係がわからないランダム要素を入れてしまうと、詳細な分析ができない・・・。
これは新たな発見でした。
もともと問題視していた育成方針の選択数の不均衡。
なぜそれが起こるのかというと・・・、
使えない(と思いやすい)育成方針があるってことなんですよね。
詳しく見ていきましょう。
各方針の能力上昇(2019.02.23)
◎=上昇大、○=上昇小、無印=上昇微小
| 略称 | 速 | 制 | 体 | 変 | ミ | パ | 走 | 肩 | 守 | E避 | 反 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 速・肩 | ◎ | ◎ | |||||||||
| 投球技術 | ◎ | ◎ | |||||||||
| 巧打 | ◎ | ○ | ◎ | ||||||||
| 長打 | ○ | ◎ | ○ | ||||||||
| 走・体 | ○ | ◎ | ◎ | ○ | |||||||
| 守備 | ○ | ○ | ◎ | ◎ | |||||||
| バランス |
投手では、投球技術が圧倒的に有利に見えます。
以前の分析で制球(と変化量)が、防御率・WHIPを下げるためにはとても良いという結果が出ていました。
それがどっちも◎です。
そうなれば速・肩とか選ばないですよね。
投手に関係あるのが◎1つって・・・。
その不均衡がどのような状態にあるのかを調査し、
それをどう軽減できるのか方法を考えます。
対象:すべての選手。ただし、バランス型を無視。
解析方法:SQLでの抽出 → Excel(ピボットテーブル)での分析

巧打と投球技術が多いですね。
この集計には投手、野手が混ざっているので分けて考えます。

やはり投球技術が圧倒しています。
魅力度(比率)では以下の通り。
投球技術(p):70.16908213
速・肩(sp):15.70048309
走・体(st)14.13043478

巧打が圧倒しています。意外と守備が選ばれていますね。
魅力度(比率)では以下の通り。
巧打(mt):50.61728395
守備(df):20.59483726
長打(pw):16.89113356
走・体(st):8.978675645
速・肩(sp):2.918069585
能力値上昇の◎を2、〇を1、無印を0とした場合、
能力値ごとにそれぞれ異なった重み(判断を上昇させる効果)があるのではないか?
ということを考えました。
ちょっと分かり辛いので噛み砕いて、どうぞ・・・。
投手で言うならば、
データから見て、速球上げるより制球上げたほうが良くね?
という考えを拡大解釈したものです。
速・肩は速球1個しか◎ついてないし、制球◎変化量◎がついてる投球技術選ぶよな!
という判断基準を数値に落とし込む考え方ですね。
ゲームやってる以上負けたい人はいないだろうし、あくまで理性的に行動するだろう、ということを前提にしています。
そのため今回は無選択(バランス型)は抜いています。ノイズになりやすいので。
それを踏まえて重回帰分析を行います。
投手成績を重回帰分析を行いました。

・・・いかん。
なぜダメかというと、
X4(変化量)への相関が0のためです。
つまり、投球技術は制球◎変化量増加なしでも、制球◎変化量◎でも選ばれる率は変わらない。
んーだったら、X2とX4の相関は同等とします。
仮定(偏回帰係数):
X1:7.85
X2:17.5
X3:7.05
X4:17.5

こんな感じで調整して、と。
野手も調整しました。

こうすればかなりまともになるのでは?と思います。
Meisyoは、
「どうすれば勝てるのか?」を考えるゲームです。
どうすれば勝てるのか?は育成から始まります。
育成方針の選択肢が少なければ、まったく選択肢はなくなります。
この調整でどの方向でも進めるし、自分が考えた戦略を実現しやすくなった、ということですね。
では!
練習試合のバグ修正を修正しました。
練習試合で大阪桐蔭2018(NPC)と当たるってマジ?
久々のバグ報告(ありがたい!)で、なんでこうなるかなーと思ってみたら、
下記のようにしたつもりが・・・
$vid = null;
if(!$vid){
    // レーティング処理
}
実際こうなってました。
$vid = null;
if($vid){
    // レーティング処理
}
想定:
$vidが選択されていないときにはレーティング処理(練習試合レートによる適正なマッチング)を行う。
現実:
$vidが存在するとき$vidを選択する!!
→そもそも$vidが存在しないからレーティングが発動しない。
→しゃーないから適当に対戦相手選べよ!!
→大阪桐蔭爆誕
悲しいなあ・・・。
レーティングの中身も少々おかしかった。直した。
というわけで、問題なく対戦できます。
これまでなかったレーティング付きで。
ふじなみ様
ご連絡ありがとうございます!画像を確認しましたが、これはバグです。
当該バグを修正いたしました。なお、気持ちだけですが模擬戦チケットを1枚送付しました。
また何かございましたらご連絡ください。
プレイしていただきありがとうございます。
実力不足感が否めませんが、Kaggleのチュートリアル的なTitanicにおいてランダムフォレストで正答率約80%を出せたのでコードを載せておきます。
Colaboratory
実施期間:2019/02/07~02/19
的中率:46%→80%
使用識別器:ロジスティック回帰、ランダムフォレスト、SVM、K-means、カーネルSVM
グリッドサーチ:あり
注意したこと:
・データをよく観察する。
・欠損値はよく考えて埋める。適当に埋めない。
・1つずつ理由を考える。
問題点:
・識別器の違いが判らなかった。(だいたい分かるようになってきた)
・分析のためのコードの書き方がわからなかった。
・名前の分類凝りすぎた感。(+αするなら男の名前と女の名前で列を分けたほうが良かったかも?)
・データ正規化の自作関数、data_normalize()がWarning出てしまう。
・NNとかCNN、LGBなどの優秀な識別器を自作できなかった。理解が足りない。
・ほぼほぼモノマネに終始してしまった。
・上のColaboratory URL完成してない!
・「もし乗客になった場合、死亡確率を下げるにはどうしたらいいの?」という問いに答えられない。
感想:
・時間かかったけど楽しかった。
・KaggleはPythonに慣れるのにはよさそう。
・他の人のコードをもっと読みたい。(カーネル読もね)
・Pythonやデータサイエンスの理解を深めたい。で、仕事で使いたい。
【追記:04/30】
LightGBM、XGBoostをさらに試したところ、84%の精度が出ました。
・・・とは言え、単純な「データ加工→学習→出力」ではチューニングしたランダムフォレストが一番精度高かったです。
2つのBoosting系は、出力後の結果を再度取り込んで学習させるなど、さらなる精度を求めるならよさそうです。(なお、ノンチューニングなので真価は発揮していない)
回答が非常に長い気がするのはなぜだろうか。
/* 自己結合を用いた場合 */
SELECT DISTINCT K1.名義, K1.口座番号,
       K1.種別, K1.残高, K1.更新日
  FROM 口座 AS K1
  JOIN 口座 AS K2
    ON K1.名義 = K2.名義
 WHERE K1.口座番号 <> K2.口座番号
 ORDER BY K1.名義, K1.口座番号;

/* 集計関数と結合を用いた場合 */
SELECT K1.名義, K1.口座番号,
       K1.種別, K1.残高, K1.更新日
  FROM 口座 AS K1
  JOIN (SELECT 名義, COUNT(名義) AS 口座数
          FROM 口座
         GROUP BY 名義
        HAVING COUNT(名義) > 1) AS K2
    ON K1.名義 = K2.名義
 ORDER BY K1.名義, K1.口座番号;
ワイ
SELECT 名義, 口座番号, 種別, 残高, 更新日
  FROM 口座
 WHERE 名義 IN (SELECT 名義
  FROM 口座
 GROUP BY 名義
HAVING COUNT(名義) > 1)
ORDER BY 名義, 口座番号;
自分自身のコードの傾向としては、以下の通り。
1・できるだけ短いコードを目指す。(美しいコードガイイヨネ)
2・「カラムA = A」は1つにしたい派。(同じこと複数書いてると入力間違えそう)
3・テスト問題はさっさと終わらせたい。(実際のデータに触れたいのであった=答えが見えている問題は興味がない?)
異常に奥が深いnumpyで遊びましょう!!
import numpy as np
a = np.arange(int(np.floor(np.random.rand()*1000)))
for i in range(1,len(a)+1):
     if len(a) % i == 0:
             np.reshape(a, (i,-1))
def test(n):
    return sum(range(n))

import timeit
timeit.timeit('test(100)', globals=globals(), number=1000)
amaxとmaxの比較
>>> timeit.timeit('np.amax(a)', globals=globals(), number=1000000)
3.069760522001161
>>> timeit.timeit('np.max(a)', globals=globals(), number=1000000)
3.094179121999332
環境と調子次第で0.3s(10%)くらい変動するのが気になる。
a = np.arange(12).reshape((3, 4))
b = np.reshape(a, (3, 4))
c = b ** 2
np.where(b % 2 == 0, b, c) # bが偶数でないときはcが出てくる
a = np.arange(120).reshape((1,2,3,4,5))
# a.T = a.transpose(4,3,2,1,0)
b = np.arange(120).reshape((2,3,4,5))
# b.T = b.transpose(3,2,1,0)
c = np.arange(24).reshape((2,3,4))
# c.T = c.transpose(2,1,0)
位置関係が逆転する訳だ
import matplotlib.pyplot as plt
x = np.linspace(-50, 50, 100000)
y = np.tan(x)
plt.plot(x, y)
plt.show()

tan()は何かかっこいい
from scipy.special import expit
x = np.linspace(-10, 10, 100000)
y = expit(x)
plt.plot(x, y)
plt.show()
sigmoid 関数は神(神経科学的な意味で)

x = np.random.randint(1000, size = 10000)
y = np.sin(x)
plt.scatter(x, y)
plt.show()

謎の模様・・・なぜだ?自己組織化に関連しているような・・・。
import numpy as np
import matplotlib.pyplot as plt
for i in range(1, 20):
  n = i * 100
  x = np.random.randint(n, size = 10000)
  y = np.sin(x)
  plt.scatter(x, y)
  plt.title("n = " + str(n))
  plt.show()
やばい(ヤバい)
import numpy as np
import matplotlib.pyplot as plt
for i in range(1, 20):
n = i * 100
x = np.random.randint(n, size = 10000)
y = np.sin(x)
plt.scatter(x, y)
plt.title("n = " + str(n))
https://t.co/VN8b2xoiQR() pic.twitter.com/b0vSA0ABzc— R (@R_farms) 2019年2月7日
投手起用と代打について
現状自分は投手起用を
こんな感じにしていて代打は6回以降にしたいのですが
投手の数の関係で9回以降に代打
を起用された場合に
野手が登板することになり
困っています。
代打起用を何回以降何回まで
と制限するか
控えの投手がいない場合に
代打を出さない設定がほしいです pic.twitter.com/yMhe7D8OpY— hage (@hage88983544) 2019年1月29日
確かに・・・。
野手が登板して試合壊れるとツマランしね。
1・交代投手がいるか?→いれば交代(代打・代走)可能
2・野手が登板しそう!→とりあえず普通の登板を実施。居なければ誰でもいいから投手出せい。
1、2はそれぞれ補完関係にあるから、どっちかだけの実装はマズいね。
投手交代のアルゴリズムを変更しました。
この変更で、野手が登板することは基本的になくなりました。
[詳細]
・投手への代打・代走は、投手の交代要員が一人以上居る場合のみ可能に。
・打者(type=B)が投手として登板しようとするとき、もし継投設定上誰も登板しない場合は、ベンチ登録済みで登板していない投手をランダムで登板させる。
実装しました。
はまったのは、投手の交代要員数の出力。
表と裏の選手Arrayを勘違いして同じように扱ってました。/(^o^)\
動くわけがない。
名将と呼ばれた者達のデータを使って、データサイエンスを学んでみましょう!
生きた&整えられたデータは中々公開されていないので、今回の野球ゲームのデータは分析に適していると思われます。もちろん、Kaggle等のデータもありだと思います!
野球ゲームの選手について、能力のミートが正規分布であるか(排出設定通りか)確認します。その理由としては、運営の観点から、バグなどの問題がなく、うまく選手が生成できているか?を答えたいと思います。
野手データ 20190204.csv
投手データ 20190204.csv
Jypyter Notebookで分析を進めていきたいと思います。
まずは、コマンドプロンプトを開いて、基本的なパッケージをインポートしておきましょう。
import os, sys, csv
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
次に、ゲームデータがあるディレクトリ直下まで行って、データを読み込ませておきます。
dfB = pd.read_csv('meisyo_b_20190204.csv', encoding='utf-16')
dfP = pd.read_csv('meisyo_p_20190204.csv', encoding='utf-16')
* 文字化け防止のためcsvはutf-16で出力しています。
データの状況把握のためにdf.info()を表示します。
dfB.info()
dfP.info()
つづいて、野手(dfB)のデータをメインで見ていきましょう。
Lvのデータをグラフ化しましょう。
plt.hist(dfB['lv'], bins=100)
plt.show()
* bins=100にしているのは、Lvが1~100の100分割で設定されているからです。
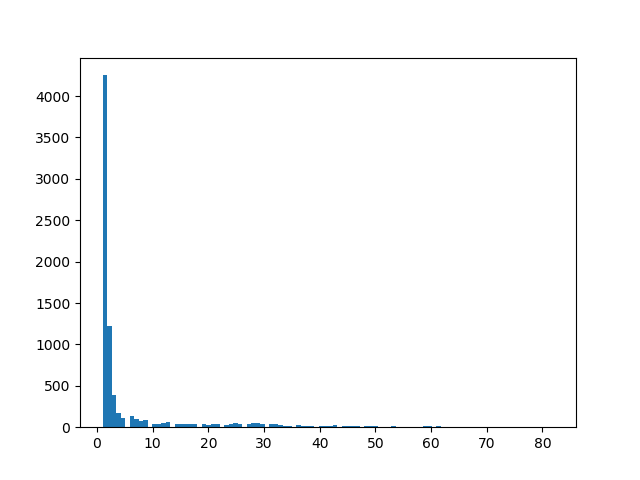
Lv0が多すぎるので、クエリでLv > 10と制限しちゃいます。
plt.hist(dfB.query('lv > 10')['lv'], bins=10)
plt.show()
dfは「Lv > 10 & Lv <= 100」などSQLみたいに書けるので、応用がいろいろできそうですね。
* 次回以降、plt.show()を省略します。
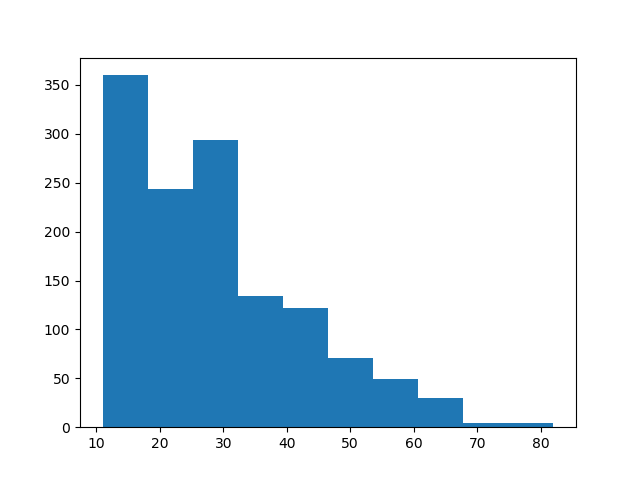
それでは、ミート(b_mt)を解析します。
まずはshape(データの行数・列数)とmean(平均値)、std(標準偏差)を表示します。
dfB.shape
dfB['b_mt'].mean()
dfB['b_mt'].std()
(7893, 96)
32.214493855314835
11.483961920286394
7893データ(n = 7893)、96カラムがありました。これだけでは、ミートがどのようなデータ分布をしているのかいまいちわかりませんね。
今回は(設定通り)正規分布してるのか?ということが気になるので、b_mtをヒストグラムにしてみます。
plt.hist(dfB['b_mt'], bins=30)
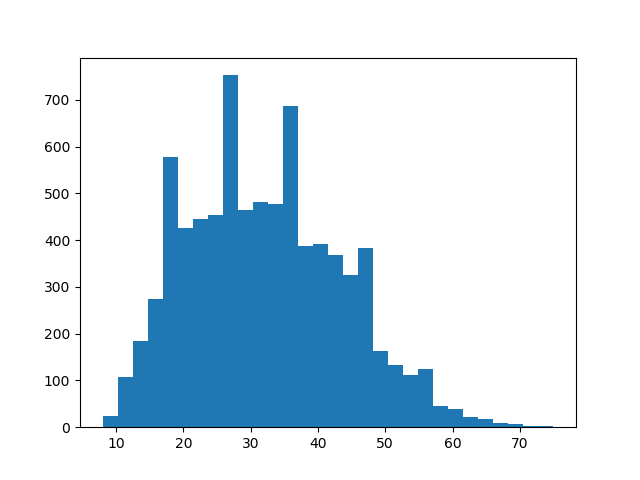
右と左のバランス感から、これは見た限りでは正規分布していないですね。
見た限りという主観的な意見ではなく、正規分布であるかどうか判断できる方法論である検定を行います。
正規分布の検定によく使われる手法です。こちらは可視化の方法論となります。
import scipy.stats as stats
stats.probplot(dfB['b_mt'], dist="norm", plot=plt)
plt.show()
直線上に乗ってることが正規分布を示すと考えてください。
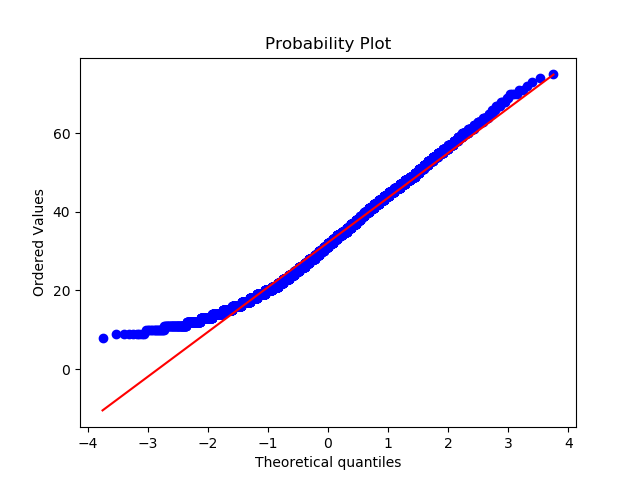
低い値の範囲が正規分布していないようですね。
他にも正規分布の検定方法はあります。定量化できるので、数値での比較が可能となります。
stats.shapiro(dfB['b_mt'])
C:\Users\saito\AppData\Local\Programs\Python\Python37-32\lib\site-packages\scipy\stats\morestats.py:1653: UserWarning: p-value may not be accurate for N > 5000.
  warnings.warn("p-value may not be accurate for N > 5000.")
(0.9833155870437622, 1.85650483425366e-29)
N>5000は正確でないよとアラートが出ていますね。データ量が多すぎたのかもしれません。
結果は、(検定統計量(W), p値)と出力されます。
今回は、p値 < 0.05のため、正規分布であることが棄却(≒正規分布ではない)されています。
歪度と尖度が正規分布に近い値か確認します。0になると正規分布ですが・・・
>>> pd.Series(dfB['b_mt']).skew() #歪度
0.364141699620992
>>> pd.Series(dfB['b_mt']).kurtosis() #尖度
-0.3620100293286428
今回は正規分布でないですね。
能力値をある条件下で区切って、正規分布であるかどうかを確認します。
stats.probplot(dfB.query('b_mt > 0 & b_mt < 60')['b_mt'], dist="norm", plot=plt)
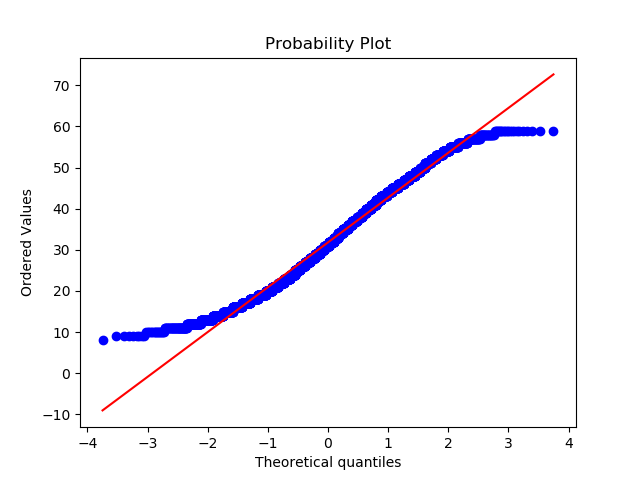
加工したほうが直線への乗りが悪くなってますね。
他のステータスb_pw(パワー)も見てみましょう。
plt.hist(dfB.query('b_pw >= 10 & b_pw <= 60')['b_pw'], bins=50)
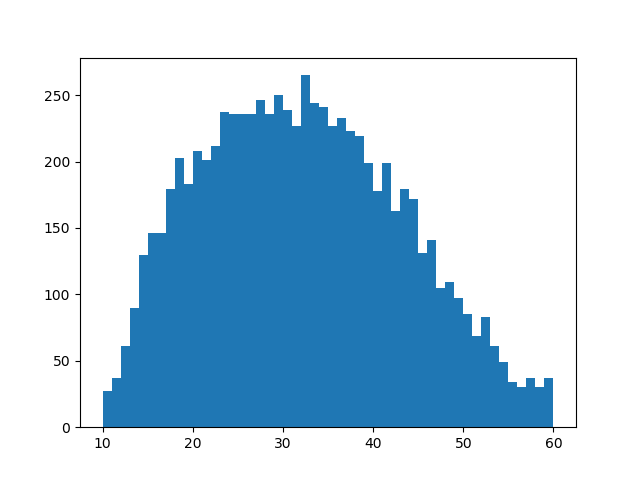
これは・・・ダメかもしれません。左すそは分布が急減していて、右すそは謎の山ができている。
上記を検定してみましょう!
>>> stats.shapiro(dfB['b_pw'])
(0.9832108020782471, 1.5380268896554336e-29)
だめですね!正規分布ではない。(‘A`)ンアー
正規分布していないという結論になりました。
なぜ正規分布していないかというと3点理由があります。
1・投手と野手では計算式が違うから
2・能力値値が低い選手は削除されるから
3・生成した結果のデータではなく、選手データをそのまま使っているから
1点目については、ミートもパワーも(結果的に打力が)高い投手が出現するなら、野手が要らなくなるよね?それは阻止したい。ということで、「野手能力は野手>投手」、「投手能力は投手>野手」になるように生成の制限をかけています。
それは後述のヒストグラムで確認可能です。
2点目については、ゲームをプレイしているユーザー側の都合ですね。
相対的に弱い選手は淘汰される。ただそれだけです。
そのため、正規Q-Qプロットでミートが低い値の範囲が正規分布していなかったことが予想されます。
3点目については、分析すべき対象データを間違っていたという致命的な内容です。
つまり、今回のデータや分析では何も言えないということです。答えがこれでは出せませんというのが答えという・・・。
さて、頭を切り替えて、野手と投手データを分けると、どう分布してるのか?を見ていきましょう。
plt.hist(dfB.query('type == "P"')['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='r') # 投手
plt.hist(dfB.query('type == "B"')['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='b') # 野手
plt.hist(dfB['b_mt'], bins=10, alpha=0.3, histtype='stepfilled', color='g') # 全体
ヒストグラムを半透明にして、緑=全体、青=野手、赤=投手で表示しています。
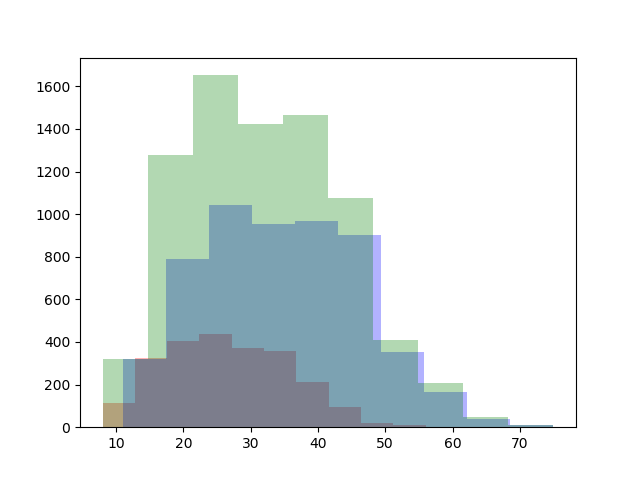
投手と野手の分布が違うことがわかりやすいのではないでしょうか。とはいえ、このように前提知識がないと効果的な洞察は得られません。
野手と投手の分布が違うことをさらに裏付けましょう。
マン・ホイットニーのU検定(中央値の検定)では、投手と野手ではやはり中央値は異なると出ますね。これこそ設定通りですね。
stats.mannwhitneyu(dfB.query('type == "P"')['b_mt'], dfB.query('type == "B"')['b_mt'])
MannwhitneyuResult(statistic=3865093.0, pvalue=4.898308872342808e-180)
加えて、one-way ANOVA(1元配置分散分析)を試します。それぞれの集団が正規分布であることを前提にする検定です。平均値が同じであるかどうか?を分散の違いで検定しています。
よくやりがちなんですが、2群間の検定であるt検定を3群に対してそれぞれ行う(A=B、A=C、B=CだからOK!)という暴挙はしてはなりません。こちらは、統計の適用ミスとして失敗例によく挙げられます。
まずは、3群(全体、野手群、投手群)が正規分布であるかどうかの検定を行います。
>>> stats.shapiro(dfB['b_mt'])
(0.9833155870437622, 1.85650483425366e-29)
>>> stats.shapiro(dfB.query('type == "P"')['b_mt'])
(0.984963059425354, 4.804016817054439e-15)
>>> stats.shapiro(dfB.query('type == "B"')['b_mt'])
(0.9849120378494263, 6.929926115617653e-24)
全然正規分布ではありませんでした。つまり、one-way ANOVAは使っちゃいけない分布です。
続いて、分散分析を行います。(使い方は間違っています)
>>> stats.f_oneway(dfB['b_mt'],dfB.query('type == "P"')['b_mt'],dfB.query('type == "B"')['b_mt'])
F_onewayResult(statistic=447.17232845769377, pvalue=1.25435911612848e-189)
一致するわけがないのでした・・・。
正規性を検定するシャピロウィルク検定(stats.shapiro())で、標準正規分布を生成するnumpy.random.randn()を検定してみましょう。正規分布を正規分布(正を正)と判断できるかをチェックしています。
>>> for i in range(1, 10):
...   temp = np.random.randn(10 ** i)
...   print("10^" + str(i) + ":" + str(stats.shapiro(temp)))
...
10^1:(0.9447452425956726, 0.6069143414497375)
10^2:(0.994074285030365, 0.9436165690422058)
10^3:(0.9983760118484497, 0.4763585329055786)
10^4:(0.9998458623886108, 0.7608375549316406)
10^5:(0.9999829530715942, 0.9663644433021545)
10^6:(0.999995768070221, 0.9852367043495178)
10^7:(0.9999997615814209, 1.0)
Traceback (most recent call last):
  File "<stdin>", line 3, in <module>
  File "C:\Users\saito\AppData\Local\Programs\Python\Python37-32\lib\site-packages\scipy\stats\morestats.py", line 1644, in shapiro
    a = zeros(N, 'f')
MemoryError
10^n個の標準正規分布を作らせて検定してみたところ、数が多くなればなるほどp値は1.0に近づきますね。
ただし、統計学では「正規分布していることを棄却できない(=判定を保留している)」だけであって、積極的に「正規分布している」とは言えないことに注意が必要です。
今回はゲームデータを用いて正規分布の検定を試してみました。
今回の結論からしても、やはり分析技術の理解とドメイン知識の両輪が必要ですね。
よく読まれるようなら、また別の内容を投稿したいと思います。