[Meisyo] 練習の不均衡是正

練習に不均衡が生じているので、アップデートで改善します。

ちなみに練習の方法自体を変更しようと思っています。
すぐには実装しません。(案が固まっていないです)

基本的に平均が150より大幅に高い(または200に局在している)練習が下方修正、
平均が150より大幅に低い練習が上方修正の対象になります。(game14(Tofu)だけ除外)

下方修正

・game11
 他と違う数のパネルをクリックしてポイントを稼げ!
・game13
 クリックして塗りつぶせ!
・game2
 正確に打ち込め!
・game8
 色を見極めてタッチしろ!
・game9
 他と違う色のパネルをクリックしてポイントを稼げ!

以上です。

練習の方法の変更について

「より現実に即した練習方法に変更するため」です。

現在は、「なぜその練習を行うのか?」という理由がないので、とてもちぐはぐに見えます。

例えば・・・

(1) 反応の練習をしたい
↓
(2) 反応練習をクリック
↓
(3) 練習「文字が見えたらクリックしろ!反応速度を極めろ!」が出てくる
↓
(4) プレイ結果で練習効率が上下し、反応関連の練習を行っている選手に追加ポイント付与

のように、ストーリー性がないのです。

「〇〇をしたい」から出ていないので、やらされ感が出る(→なんでやってるかわからない→止める)のではないかと。

そのため、下記のような練習を追加する予定です。
「打撃練習(ミート・パワー・反応)」→ 飛んでくるボールにミートを合わせて打つ(トスバッティング)、できるだけ素早く素振りする(タイミングよく)
「パワー」→ ものを持ち上げる(数多くタップする)、モノを持ち上げて下ろす(押しっぱなし~放すをタイミングよく)
「走力」→ 反復横跳び(キャラが移動したら次の〇をクリックする)、腿上げ(右左の〇を順番に早くクリックする)
「肩力」→ 遠投(パワーメーター+角度メーターでの結果)、キャッチボール(相手の距離を見越して投げる)
「守備力」→ 飛んだボールを取りに行く、落下地点を予測して取りに行く(複数回)
「反応」→ 文字が見えたらクリック、

以上です。
ちょっと時間かかるかもー(^o^)/

# 追記 2019/11/25
練習は挑戦に移行しました。
基本の考え方は同じです。

[Meisyo]ゲームのUIを改善し続ける意味とは

1ヶ月に3回はUIが変わっているMeisyo。

何故変え続けているのか。

説明しよう!

今悪いポイント

簡単に言うと新規登録ユーザーさんが定着しない!

チュートリアルでも最終ステップまでの到達率が75%程度。

29人→1W後に定着しているかも?がたった5名(17%)。

ただ、その5名は非常に良い定着率です。
1W後継続者の2ヶ月後継続率は50%!(大手のゲームだとここまで行きません)
・・・とはいえ、まだまだ改善する点があると考えています。

考えていること

ユーザーに対してもっとできることはないだろうか?
せっかくゲームを始めようとしてくれたユーザーにもっとストレスなく、ゲームを理解してもらえないだろうか?と。
理解して辞めちゃうならしゃーないと思ってます。
それはそのゲームが悪い。

ただ、このゲームのコアとなる「自分が見出した固有の選手」の育成要素、公式戦の楽しみ等・・・たぶん理解する前に辞めているユーザーが多いのではと考えています。
単純に自分がやって楽しいし。特に公式戦は楽しい。(勝てないけど)

加えて、プレイしてくれる(orしてくれた)ユーザーがコンテンツになる稀有なゲームかと思います。
一人一人育成方針が違うし、選手も違うしでなかなか勝てない。(パラメータ強ければ勝てるわけでもないし)

他のゲームはどうしてもキャラゲー(他の人も持ってるキャラを使わざるを得ない、キャラ格差、レアリティ(ガチャ)競争)になるので、・・・それをどうアピールするかがワカリマセンので改善を行っています。
個人的には「最強パーティ」が存在するのはダメだと思ってます。(最強を追っかけるのも疲れますし)
マネタイズどうすんねんっていう回答も探さないといけない。

見るポイント

仕事でデータを見ている感じでは、

まず、チュートリアルで辞めるユーザーが多い。

どこのポイントで離脱しているかを確認し、「離脱要因は何か?」を考える。
例えば、「ロード時間が長い」や「リセマラポイント」での離脱が多い。
ログを見ている限り、1分も待てないユーザーが多い感じがあります。
ただビッグタイトルでなければ、そこまでひどくはない傾向も。
(ユーザーの質でしょうか・・・そもそもそのゲームをインストールしようと思えない系ゲームもありますし。その時点でそりゃ辞めにくいですよね。)

キャラゲーやってるのでリセマラは仕方ないと思います。
同系統同Lvなのに「1キャラ入れ替えるだけでダメージ2~3倍余裕でした^^」的なのになっているので、最初に当てないと話にならないですし。
課金ユーザーでも本当に当たりが出なかったりでよく続けているな(しかも課金してるし)みたいなユーザーが数多くいます。彼らはスゴイ。

次に、そこまで定着させている原因が何かあると仮定し、定着ポイントを考えます。
何を中心にプレイしているか、プレイ比率の推移はどれくらいかを検討します。
ここらへんで機械学習に掛けたりします。
割と「プレイ回数が多い人は定着しやすい」とかいう当たり前な答えが出てくるのでそれはカットします。

「仮説を立てて、結果に意味がありそうなことをさらに深堀りし、解釈する」
難しいんですよね・・・

実施例

Meisyoでは、分析をそこまで深くはやっていない(というより一人ずつのログが見れる)です。

ただ、「公式戦をプレイしてくれるユーザーはだいたい継続してくれる」という結果が出ているので、
そこに新規登録ユーザーさんの意識を向けようということをやってみています。

まずMeisyoの育成系が多すぎるので「どこに触ればいいかわからない可能性が高い」と考えて、
08/18アップデートも育成をこうやるんですよ的なことを追加しました。

あとは理解しやすいストーリーになっているかどうか。
再度読んでみて突拍子もない話を排除したり、ユーザーが求めているモノ(仮説:自分の思い通りのチームを作りたい)に合わせてチュートリアルを組み立てたりですね。
あくまで数値は数値(結果)でしかないので、「ユーザーが何を考えたか」は人間にしか理解できないです。

まとめ

全てはユーザーのためにと言いたい所ではありますが、
ユーザーにできるだけこのゲームで遊んだのが無駄な時間だったと思わせたくない、後ろ向きな考えがあります。

UIを改善し続ける意味はユーザーのためでもありますし、自分のためでもあります。
本当にコレは面白いのか?をいつも問い続けたいですね。

[Python] 機械学習での変数選択自動化(SVRを例に)

今回、会社のコンペで255というとんでもない量の変数を扱うことになりました。
価格予想を行うコンペです。

今回のデータのおさらい

データ量は1500程度。8:2で分けると検証データが300しかないすごく小さいデータです。
1つ1つの変数は「価格(y)との相関関係がほぼない」という特徴を持っていました。
そのうえ欠損値だらけ。穴埋めするだけでタイヘン。

そのため通常行われる下記の1が使えませんでした。

1・変数増加法(前進的選択法、forward selection method)
2・変数減少法(後退的選択法、backward selection method)
3・変数増減法(stepwise forward selection method)
4・変数減増法(stepwise backward selection method)

1番は作ってみたのですが、1変数目から「すべて同じ正答率ですねー」と出て話にならなかった。
それで進めても正答率上がらず・・・。
ランダムに選んでるだけになっていたのでしょうがないか。

というわけで2番を実装しました。

前提条件

すでに前処理を行って、正規化済みの「X」と回答の「y」に分けてあります。
分ける前のデータフレームは「df_a」です。

ある程度実験的に分析してみた結果、一番当てはまりが良さそうなSVRを採用しています。
その他のモデルでも可能だと思います。

※Jupyter Notebook環境を想定しています。

コード

まず初めに、変数選択用のデータフレーム「df_auto_var」と回答の「y_auto」を作成しました。
データをpandasに入れ込んでいる理由は、自動で変数選択を行えるようにするためです。

df_auto_var = pd.DataFrame(data=X, columns=df_a.drop(['sum'], axis=1).columns, index=df_a.drop(['sum'], axis=1).index)
y_auto = df_a['sum'].values # yで良かった気がする

# モデル選択(チューニング済み)
from sklearn.svm import SVR
auto_model = SVR(C=50.5, cache_size=200, coef0=0.0, degree=3, epsilon=0.1, gamma=1.0, kernel='poly', max_iter=-1, shrinking=True, tol=0.001, verbose=False) # チューニング済SVR

次に、排除済み変数を入れる「auto_rank」と変数選択リスト「auto_var」を作ります。
あとは、最後に結果表示を行うための「auto_graph」「auto_columns」「auto_data」を作成しておきます。

# 自動用Series(途中保存可能)
auto_rank = pd.Series()
auto_var = pd.Series(df_a.drop(['sum'], axis=1).columns)

# 保存用list
auto_graph = []
auto_columns = []
auto_data = []

変数選択リストからカテゴリ変数を外したい場合は、下記のように「auto_var」から当該の変数を抜いておきます。
今回はダミー変数「***_0」では、欠損値であった行は「1」としているのでそれは削除可能にしておきます。

import re
# カテゴリ変数は削除しない(0は自己作成のため削除可能)
for col_var in auto_var:
    if re.match(r".*_\d+", col_var) and re.match(r".*_[0]+", col_var) is None:
        print(col_var, "Delete")
        auto_var = auto_var[auto_var != col_var]

続いて、本命の編集選択プログラムです。
最初はグリッドサーチ(GSCV)入りにしていましたが、
最終的に現コードの「全変数を入れたSVRでグリッドサーチ(ランダムサーチ)を入念に行い、auto_modelに入れて実行する」方法が上手くいきました。

なぜそのようにしたかと言うと、
(1)グリッドサーチを1つ1つ丁寧にできないので上手くいかない
・1変数外すのに255変数全部を検討できない
・1変数ごとに検討しても最低100検討はかかる
「そんなことより他の事をやったほうがいいのでは?」という。変数作成とかね。
(2)自動で丁寧にグリッドサーチすると計算回数(時間)が爆発する、
・グリッドサーチは少なくとも1回5秒かかるので、255変数すべてに行うとそれだけで20分近くかかる。predict等の計算時間も併せて考えると1変数選択で30分以上かかるようになる(上手くいったかどうかも確認できない)

SVRはパラメータによってフィット度合いが全く異なります。
今回の正答率(今回は価格の±10%以内に入ったか)も無チューニング→適当チューニングで15→25%に改善しました。
全然ダメなパラメータが選択されてしまうとその時点での変数選択もうまく行かず、後にも悪影響がありそうです。
というわけで「一番いいやつ」だろうパラメータで試してみて、変数が減ってもそんなに悪影響がなかったのでこの方法を取っています。
※注釈:
グリッドサーチの「scoring」があるので、そこを自己定義関数を使いうまく設定できると良いかも。

グリッドサーチが必要であれば下記を適当にいじってください。
今回は「poly」が上位に来ていたためpolyだけにして計算回数を節約していました。「sigmoid」は低かった。

# GSCV用
cv_param = {
    'C': np.linspace(1, 100, 5),
    'kernel': ['poly', ' linear', 'rbf', 'sigmoid'],
    'degree': np.arange(1, 10, 1),
    'gamma': np.linspace(0.1, 1.0, 5)
}

では本命のコードを。
今回はtrain_test_splitのrandom_stateを0にしています。再現性を取るためです。
変数1つ1つを0で埋めて正答率を比較しているだけです。もっと良い方法があるかもしれない。
最後に結果を各listに突っ込んでおくという処理です。

# AUTO_VAR
for i, col_var in enumerate(df_auto_var):
    auto_ranks = {}
    print('# Rank', i, 'Start.', 'Len:', str(auto_var.shape[0]),'Time:',datetime.today().strftime("%Y%m%d_%H%M"))
    # 変数を1残す
    if auto_var.shape[0] <= 1:
        break
    # GSCV前処理
    #col_datas = auto_rank.copy()
    #X_auto = df_auto_var.drop(col_datas.values, axis=1)
    #X_atr, X_ats, y_atr, y_ats = train_test_split(X_auto, y_auto, test_size=0.2, random_state=0)
    # GSCV
    #SVR_acv = GridSearchCV(SVR(), cv_param, cv=2, return_train_score=False, n_jobs=-1, verbose=2)
    #SVR_acv.fit(X_atr, y_atr)
    # 特徴選択(Backward Selection)
    for col_n, col in enumerate(auto_var):
        col_datas = pd.concat([auto_rank, pd.Series([col])])
        # X選択
        X_auto = df_auto_var.drop(col_datas.values, axis=1)
        # 選択されなかった変数は0埋め
        X_auto[col] = 0
        # TrainSplit
        X_atr, X_ats, y_atr, y_ats = train_test_split(X_auto, y_auto, test_size=0.2, random_state=0)
        # Fit
        auto_model.fit(X_atr, y_atr)
        # Check
        auto_acc = 0
        auto_pred = auto_model.predict(X_ats)
        #auto_pred = SVR_acv.best_estimator_.predict(X_ats)
        for j, n in enumerate(y_ats):
            acc_per = (auto_pred[j] - n) / n
            if abs(acc_per) <= 0.1:
                auto_acc += 1
        auto_ranks[col] = auto_acc / y_ats.shape[0]
        print(" (%s/%s) %.2f% [%s]" % (str(col_n).zfill(3), str(auto_var.shape[0]).zfill(3), auto_ranks[col]*100, col))
        
    # ソートして点数順(昇順)にソート
    auto_ranks_sort = sorted(auto_ranks.items(), key=lambda x:x[1])
    auto_result = [k for k, val in auto_ranks_sort[:]]
    # dropカラムに入れる
    auto_rank = pd.concat([auto_rank, pd.Series(auto_result[-1])])
    auto_var = auto_var[auto_var != auto_result[-1]]
    # グラフに追加
    auto_columns.append(auto_result[-1])
    auto_graph.append(auto_ranks[auto_result[-1]])
    auto_data.append(auto_var)
    print("→ [%s] %.2f%" % (auto_result[-1], auto_ranks[auto_result[-1]]*100))

工夫した点としては以下の4点。
(1)処理を中断しても途中から再開できる(カーネルが死ななければ、ですが)
(2)時間を先頭に書いているので、変数選択がだいたいどれくらいで終わるのか予想できる
(3)結果の推移をグラフ「auto_graph」(後述)で見れる
(4)良さそうな変数設定を「auto_data」から引っ張れる

特に(4)が良いです。
変数選択したけれど「結局どんなカラムでやればいいの?」という答えに即答できますね。
データを一々見るのは面倒ですよね。

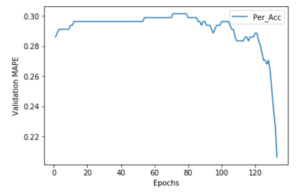
あとは結果の表示と、

# プロット
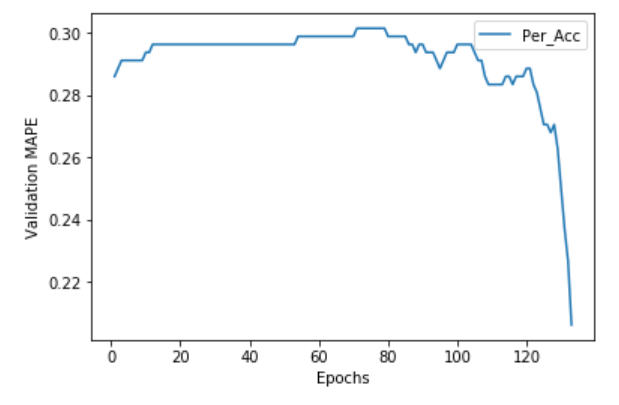
plt.plot(range(1, len(auto_graph) + 1), auto_graph, label="Per_Acc")
plt.xlabel('Epochs')
plt.ylabel('Validation MAPE')
plt.legend()
plt.show()

どんな順番で変数が抜かれたかを書いておきます。

for i, col in enumerate(auto_columns):
    print(str(i).zfill(3), math.floor(auto_graph[i]*10000)/100, col)

最後に、正答率が一番が良かった結果を表示します。

arg_max = int(np.argmax(auto_graph))
print('No.', arg_max, 'Per:', auto_graph[arg_max])
print('Columns:', auto_data[arg_max])

グラフだけ見ても「ふーん、で?」としかならないので。
まとめ

 今回は変数選択法の変数減少法(後退的選択法、backward selection method)を少々無理やり実装しました。ある程度変数の数が少なければ、手動で選択をかけても良いと思います。(意味のある変数が多ければ!)
 手作業でちょこちょこやるのは時間あるときはいいのですが、これだけ多いと無理があります。変数作成や問題に合いそうなモデルの選択、グリッドサーチ等、精度に直結することに時間を掛けたいものですね!

[Python] tensorflow_datasetsで詰まったとき

「図解速習 DEEPLEARNING」で自己環境(Windows)で学習していました。
tensorflow_datasetsって何だ・・・?

import tensorflow_datasets as tfds
SPLIT_WEIGHTS = (8, 1, 1)
splits = tfds.Split.TRAIN.subsplit(weighted=SPLIT_WEIGHTS)

(raw_train, raw_validation, raw_test), metadata = tfds.load(
    'cats_vs_dogs', split=list(splits),
    with_info=True, as_supervised=True)

tensorflow_datasetsはtensorflow 1.13.0以上が必要!
↓
じゃあアップグレードすっか!
↓
!pip install tensorflow-gpu==2.0.0-alpha0
↓
[Python] tensorflowが「ImportError: DLL load failed」で困った件について
(tensorflow-gpuのみアップデートしたのでバグったやつ)

となるので見切り発車はヤメテおきましょう。
もし、tensorflowもtensorflow-gpuもインストールしているなら、両方更新しましょう。

30分も無駄にした(‘A`)

環境がColaboratoryに合わせて作ってるから、自分の環境でインストールすることを想定していないゾ~。

[Python] tensorflowが「ImportError: DLL load failed」で困った件について

ImportError: DLL load failed: The specified module could not be found

おおん・・・?
今回Tensorflowの新バージョン2.0.0入れたりしてたら、上記のエラーが出た。

Jupyter上での当該コマンドはこちら。

!pip install tensorflow-gpu==2.0.0-alpha0

動かねえ・・・というわけで調べてました。

Github

特に重要そうなコメントが、
I finally solve the problem by installing cuda 9.0 instead of 9.2 or 10.0 with tensorflow 1.12.0 and cudnn 7.4.1.5
です。

なるほど。
原因は「複数モジュールのバージョン不一致でなんか読めねえ!」か。

というわけで再度インストールし直すと。
今回はtensorflow-gpuしか調整してないので・・・

こちらはコマンドラインで

pip uninstall tensorflow-gpu
pip install tensorflow-gpu==1.12.0

バージョン指定はしてもしなくてもOK。

これで解決!

ログがサービス改善の命

Meisyoでは常にログを取って、「ユーザがどこで困ってそうかな」を探し続けています。

探す方法はいたって簡単。

(何か問題があると考えて)ログを眺める

今回のアップデートでは、アイテムの購入数を選択できるようにしました。

なぜそうしたかというと、
ログを眺めていて「一人で複数回も連打してるやん・・・これ・・・」という状態に気づいたからです。

スマホゲームにはよくあるんですけどね。
1個ずつしか買えず、複数個購入したいときダルい

それは面倒なので個数の選択肢を追加しておきました。

(大手のゲーム会社になると、もともとゲーム用のソースコード群があって、それを入れ替えているだけのところも多いのでUIがなかなか改善しないのではと思います。)

カードアイテム版

監督アイテム版

※画像を加工しすぎていてよくわからない状態になっているログ

ユーザIDごと、時間(またはログNo.)ごとにORDER BYすればいいだけなんですが、
ログがないサービスも多いと思います。

とりあえずログ取っていきましょっていう。

ユーザのストレスは少しずつ蓄積していって、閾値になるとすっぱり辞めてしまうので。

ログからストレスの蓄積度合いを取りたいんだが、難しいなあ。

[Meisyo] 最近のアップデートの総括

最近のアップデートで失敗したかなと思ったもの

  1. 特訓
  2. 結構多くの人が使うと思って追加した。
    けれども、蓋を開けてみると日で1~2割くらいの方しか使ってもらえていない。
    選択肢がないより良いが、選手をある程度発掘できたユーザには刺さらないのかもしれない。
    「カードを引いた時のめぼしい選手」や「カードを引いたまま放置していたらなんか育った選手」にぜひやってみてほしい。

    頑張りようのない(運ゲーの)練習を粛正できたので良しとするか。

  3. プレミアムアカウント
  4. 経験値50%UPのチケット。名将P500で2週間使える。
    練習は最大効率200%であるが、200%×1.5倍→300%までブーストできる。
    試合にも同様の効果がある。
    使われない理由は、単純に名将Pが貯まりにくいのと、他に使う先(気合、やる気UP、選手・監督リセット)があるからだろう。

    ちなみにシナリオで全国優勝するともらえるので、獲得したらぜひ使ってみてほしい。
    公式戦優勝者・準優勝者にも配る予定。

    課金要素にするつもりだったが、そもそも使われないのは想定してなかったNE・・・(‘A`)

  5. 対戦ありがとう
  6. 確かに「気合の塊の流通量を増やす」という副次的な目的は達せられた。
    名将Pでの気合の塊購入者が増えたし。何故だ。
    たぶん、気合の塊強化が依存性がある作りになっているので(文字の色とか演出が)、
    「上がんねえなこれ」と思いながら強化してくれているのではと思っています。
    私もなんかピンクの「成功」が見たいです。はよ+3にしたい。

    この機能はコミュニケーションを増やすのに貢献しただろうか?(真の目的)

    ・・・「この人もプレイしてるんなー」と思う効果はあると思う。
    それ以上にはまだまだです。

  7. バランス調整(速球)
  8. 打高調整をしたら、変化球投手より速球投手が死んだ。
    物理計算上の球の速度を下げ、HR率を下げたものの・・・単純に打たれる。
    もうちょい修正を掛けたい。

    どの育成方針でも選べるようにするを達成したい。

    ただ他は概ね問題なさそう。
    打高にしたが、
    もともと打率高かった勢はあまり打率が上がらず、低かった勢がとても上がった。
    どこのチームにも守備勢が少量入るようになったのは良い。
    練習試合レート上位のチームであるほど、守備に力を入れている傾向にある。
    (脳筋打撃マンも居る。打ち合いがシーソーゲームでとても楽しいのでGood)

成功したかなと思ったもの

  1. UI改良
  2. 新規・既存ユーザの定着率UPに貢献した。
    単純に「触っていて気持ちよくする」だけでいいのだが・・・難しい。
    まだまだ改良点はある。

  3. チュートリアル
  4. チュートリアルもぼちぼち変えているのだが、1つ1つには改善効果があまり見られない。しかし全体を通してみると、以前より定着率がだいぶ良くなっている。
    ただ、すぐに(チュートリアルやってちょっとゲーム内容触って)辞めるユーザを引き留められない。
    このゲームは公式戦がメインだ。そこまでやってみてほしいネー。
    ゲームの在り方を考えたときに「ゲームスピードはこうあるべき」と決めたので変えはしないが。

  5. スキル追加
  6. 選択肢が増えたアップデート。
    (狙ったスキルが出るとは言っていない・・・ソモソモ出ナインデスガ)
    スキル全体のバランス調整もできたし、新規スキルの追加も簡単になったので凄く良い。

    最初に想定していたより右投、右打が多く、
    対右投手〇、対右打者〇が猛威を振るいそうだったので+5→+3に下方修正した。(左も同じくだが)

  7. ユーザーの声でのバグ修正(トークルームの追加)
  8. ユーザーの皆さんいつもコメントありがとうございます!
    一人で見ているので、見切れない部分が多々あります。
    (新要素実装も、何回かプレイして動作に問題がなければアップしてるため…。)
    「変だな」と思ったら「相談窓口」や「問合せ」などで連絡ください!

    トークルームの作成は成功だったと思う。
    コミュニケーション取りやすくなった。・・・そもそもゲーム内でのコミュニケーション取れなかった(^o^)!
    (最初は24文字制限とかでクソofクソだったが)

  9. 練習のバランス調整
  10. Tofuさんが即死ゲーしてるのはわかってる。
    ・・・がそんなにプレイを避けられているわけではないから変更の必要性はないのかもしれない。
    データが取れてきたので再度微調整を行う予定。

  11. シナリオ
  12. 練習試合と半々くらいでプレイしてくれている。
    元々、「公式戦期間中は気力余る問題」の解決のためだったが。
    まだ優勝できてないのはなぜだろうか。強すぎんだよな。(これくらいの感覚でいいが)

    シナリオ書いてくれる人いねえかなあ・・・。それ以外は作る。
    (完全オリジナルでお願いしたい。もちろん著作者の権利は明示します。)
    話を作ることが壊滅的にへたくそなのでもうね・・・。

Meisyo 実施計画書も忘れずに更新していきたいですね。

[Python:Predict Gollira]2枚の画像でどちらがゴリラっぽいかを人間が予想する。

「あーこの人ゴリラっぽい。」と思うことはありませんか?
ゴリラっぽさってどこから来るんだろうかと悩んでいました。

前回、[Python] ディープラーニングのモデル「VGG16」を使って画像認識をし、判断した理由の可視化をする。を行っていた際もその疑問がつきませんでした。

1.

2.

どちらの画像の方がゴリラっぽいかを知りたくありませんか?

今回実装したのは、「ゴリラっぽさ(ゴリラであると予想される確率)をディープラーニングの画像認識システムで認識し、2枚の画像の予測値はどちらが高いのか?を人間が予想する。10組用意して正答率を出す。」です。
名前は「Predict Gollira」。
Golliraのスペルミスを何度したかわからない。(これも合っているかどうかも!)

この技術の応用としては、
「人間の写真を撮って、どっちの方が犬・猫っぽいかを比べるアプリ」
「そもそもあなたは犬?猫?どっち系の人間?」

みたいな女子高校生向け・・・おっさんがやってたら怖いアプリになります。

使い方

  1. 下記のURLからzipファイルをダウンロードして解凍します。
  2. Predict Gollira

  3. app.pyの46行目にあるMySQLの接続設定をしてください。
  4.  データベースは「predict_gollira」になっていますが、別に他の名前でもOKです。

  5. MySQLに下記コードのテーブルを追加してください。
  6. CREATE TABLE image_pred (
    id INT NOT NULL,
    pred double,
    PRIMARY KEY(id)
    ) ENGINE = INNODB character set utf8mb4;
    
    CREATE TABLE list (
    no INT NOT NULL AUTO_INCREMENT,
    comp_array VARCHAR(2000),
    PRIMARY KEY(no)
    ) ENGINE = INNODB character set utf8mb4;
    
  7. ターミナルで下記コマンドを実施してください。遊べます。
  8. python app.py
    

※必要に応じてモジュールをインストールしてください。
※Pythonの環境構築はAnacondaでやれば5分もかからない。おすすめだ。

構成

ディープラーニングモデル:VGG16
Python:Keras+Flask+MySQL
HTML5とCSS、JavaScriptもちょっぴり使ってたりする。
※FlaskとMySQLdbはほぼ初見なので、「動けばいい」との考えで作っています。
※MySQLなしでも良い。ただ、画像の予測に時間がかかるので、予測値をMySQLに入れて1画像1回切りの計算にとどめている。あらかじめ全ての予測値を計算しておくのも良いかと思ったが、今回はコンペごとに分散させた。

遊び方

知人と同じ番号のコンペで正答率を競ったり、
毎日の日課として、自分のゴリラの判別精度を高めたり、
画像を追加(static/imgフォルダ)して、写真(例:人間)のゴリラっぽさを試したり・・・。

例

初見で頑張ったら6割でした。ランダムで選ぶよりマシだ。

んー0.4%低いですねー。(わかるのか・・・?)


影や日の光が強いと見えにくくなるから、これだ!と判定されにくくなる…。
これは機械学習の大きな問題~。って言っても人間もだけど。


これ右チンパンジーの親子だね。かわいいね。

まとめ

疑問だったゴリラっぽさを学ぶ環境ができました。
ただ、モデルによってゴリラっぽさの基準が違うようです。(今回はVGG16だが、他にもたくさんある。)
もしかしたら複数のモデルの平均を取ったほうが良いかもしれない。それとも多数決か。
なんにせよまだまだ発展は可能だ。発展させる人がいるかどうかは別だが。

ゴリラ画像を集めるときにはpixabayがすべての役割を担った。感謝します。

[Python] ディープラーニングのモデル「VGG16」を使って画像認識をし、判断した理由の可視化をする。

今日はデータ分析から趣向を変えて画像認識を行います。

やることは簡単。

1.撮った写真を使って画像認識させ、何が写っているか判断させる。
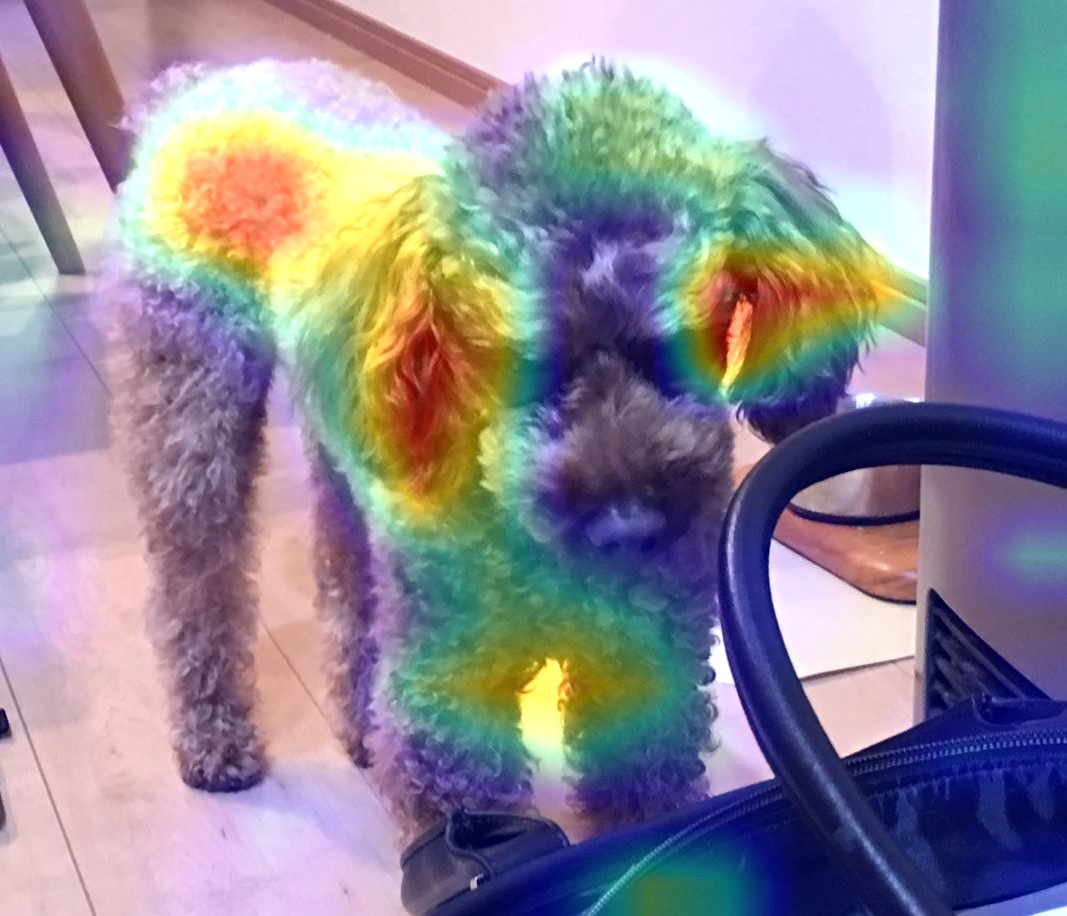
2.何が写っているかを判断した理由(位置)を可視化する。

以上です。

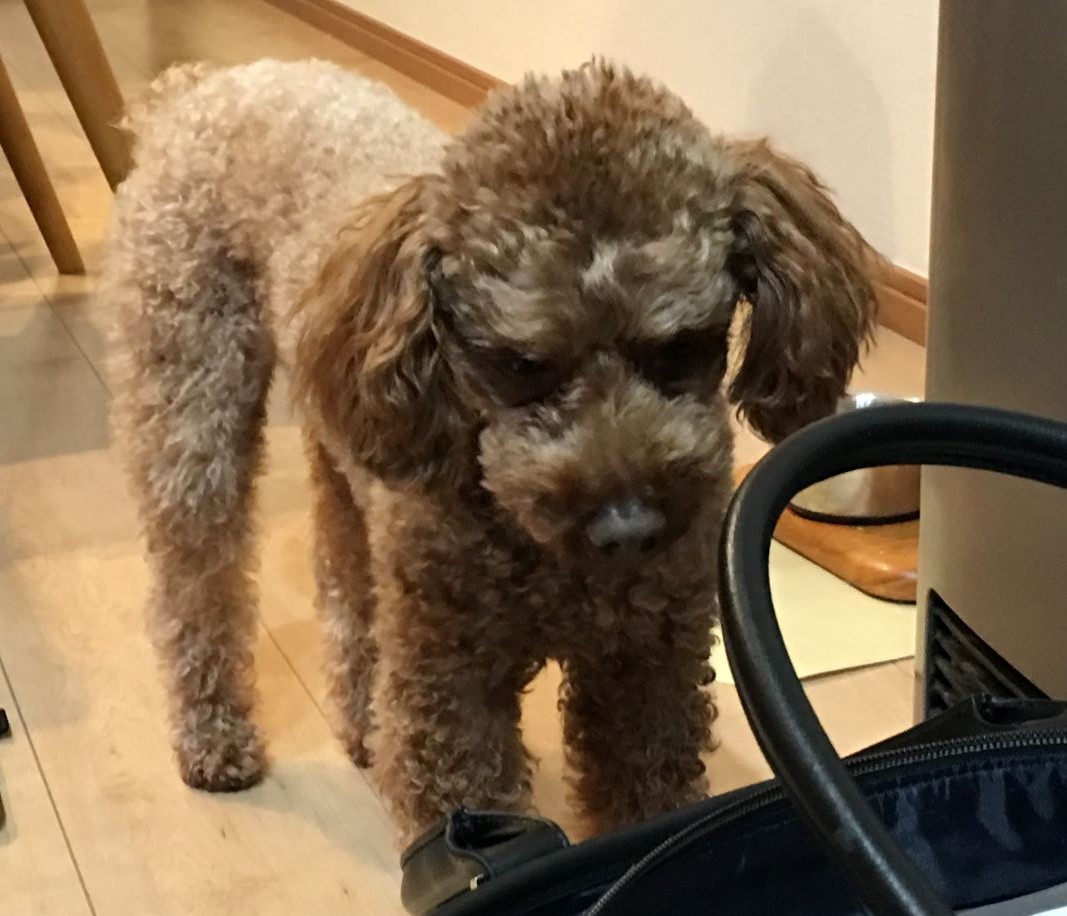
今回使う画像はこちら↓

うちの犬です。
トイプードルですが、トイプードルと判定されない子です。

KerasとOpenCVを使っています。
OpenCVのインストールはターミナルから以下のコマンドを~。

pip install opencv-python

では始めます。
まず手始めに、VGG16という学習済みのディープラーニングのモデルをインポートします。
学習が不要なのでノートPCでも簡単に予測ができます。

最新ではないですが、かなり簡単な構造をしているので理解しやすいモデルです。
構造はmodel.summary()で出力できます。

コーディングに使うのでおすすめはJupyter NotebookかGoogle colab.です。
ミスってもやり直しが効くのでとてもやりやすいです。

# VGG1616を読み込み
from keras.applications.vgg16 import VGG16
model = VGG16(weights = 'imagenet')

# 必要なモノをインポート
from keras.preprocessing import image
from keras.applications.vgg16 import preprocess_input, decode_predictions
import numpy as np

次に画像を読み込みます。
224×224にサイズを変更するのは、VGG16の受け入れ可能な画像サイズが224×224だからです。
縦長や横長の画像はちょっと伸び縮みさせて無理やり突っ込まれます。

# 画像パス(必要に応じて変更してください)
img_path = '/Users/saito/Desktop/dog190720_1.jpeg'
# 画像を読み込む
img = image.load_img(img_path, target_size=(224, 224))
# 画像の確認
img

あとはVGG16に合わせて前処理を行います。
写真はRGBで読み込まれるので(224, 224, 3)の形式になりますが、
VGG16は(写真No., X, Y, 次元数)の形式で読み込まれるのでそれに合わせます。

# np配列に変換
x = image.img_to_array(img)
# VGG16に合わせるため次元追加
x = np.expand_dims(x, axis=0)
# バッチの前処理
x = preprocess_input(x)

予測させます。

preds = model.predict(x)
print('Predicted:', decode_predictions(preds, top=3)[0])
# miniature_poodleの番号を取得
np.argmax(preds[0])
preds[0][266]

↑の写真を使っていると、miniature_poodleの予測値が最大になります。
miniature_poodleの番号は266なので、それを下記で使います。

写真にどこで判定をしたのか書き込みます。

from keras import backend as K

# 最後の畳み込み層の出力マップを出力
last_conv_layer = model.get_layer('block5_conv3')

# その層でプードルのクラスの勾配を確認
poodle_output = model.output[:, 266]
grads = K.gradients(poodle_output, last_conv_layer.output)[0]

# 平均勾配
pooled_grads = K.mean(grads, axis=(0, 1, 2))

# 出力関数を規定
iterate = K.function([model.input], [pooled_grads, last_conv_layer.output[0]])

# 2つの値をnumpy配列として取得
pooled_grads_value, conv_layer_output_value = iterate([x])

# 重要度を記入する
for i in range(512):
    conv_layer_output_value[:, :, i] *= pooled_grads_value[i]

# ヒートマップ化する
heatmap = np.mean(conv_layer_output_value, axis=-1)

# ヒートマップの後処理(正規化0~1)
heatmap = np.maximum(heatmap, 0)
heatmap /= np.max(heatmap)
plt.matshow(heatmap)

OpenCVの登場です。
今回は写真の上から重要だった部分を書くことに使います。

# OpenCVスーパーインポーズ用
import cv2

# cv2で画像を読み込む
img = cv2.imread(img_path)
# サイズを戻す
heatmap = cv2.resize(heatmap, (img.shape[1], img.shape[0]))
# RGBに変換
heatmap = np.uint8(255 * heatmap)
# 元の画像に適用
heatmap = cv2.applyColorMap(heatmap, cv2.COLORMAP_JET)

superimposed_img = heatmap * 0.4 + img

# 保存先を指定
img_path2 = '/Users/saito/Desktop/dog190720_1H.jpeg'
cv2.imwrite(img_path2, superimposed_img)

# 画像を読み込む
img2 = image.load_img(img_path2, target_size=(224, 224))
img2

非常に簡単に処理が終わりました。
出来た画像は以下の通りです。

miniature_poodleと判定したのは、耳や胴体が特徴的であったことがわかります。
このようにディープラーニングも判断内容が可視化でき、完全にブラックボックスではないことがわかります。

ちなみに、自分で撮ったどんな写真でも判定可能です。
img_pathとimg_path2の設定フォルダ(デスクトップ)を間違えなければ誰でも可能!

ちょっとやってみたいなーと思ったら、Google colab.へ。
ファイルの読み込み方法が少し違い、下記のコードを使う必要があります。

from google.colab import files
uploaded = files.upload()
uploaded_file_name = next(iter(uploaded_file))
img_path = uploaded_file_name

非常に簡単ですね~(^^)。

特訓の追加について

練習に特訓を追加しました。

特訓の実装目的は、
1. 選手発掘の迅速化
2. 特定の選手の育成
です。

meisyoはステータスが絶対的ではないので、(なんとなく)良い選手を発掘することが重要です。
※良い選手=なぜかよく打つ、投げる選手
今までは1日1回の練習試合でしか良い選手の発掘(データ取り)ができませんでした。

そのため、今回のアップデートで選手の打撃・投球データが取れる「特訓」を追加しました。1日最大3回データ収集を行えます。

特訓では打撃特訓と投球特訓の2つが存在します。

打撃特訓は一人の打者を選び、その打者は9回(27アウト)分打撃練習を行います。
投球特訓は一人の投手を選び、その投手は9回(27アウト)分投球練習を行います。

特訓は自チーム内での限られた練習となるので、ここで活躍する選手が必ずしも練習試合や公式戦で活躍するとは限りませんが、ある程度良い選手を発掘することができるようになりました。

経験値は練習の基本経験値が得られます。
選択された選手は300%、その他の選手は100%となります。そのため、練習の方が少し効率が良いかもしれません。
特定の選手育成+データを取るか、少しの経験値を取るかですね。

特訓を追加することで、これまで埋もれていた選手たちが日の目を見ればいいなと思います。
メンバー固定にならず、選択肢が多くある状況が理想的です。そうなるように調整していきます。

以上です!