【教材紹介】入門統計的因果推論

因果を推定することはビジネスにとってもインパクトがあります。
今回は、UCLAで教えられている因果推論の講義をまとめた、因果推論を使うための前知識として非常に重要な1冊を紹介します。

名称


入門統計的因果推論

著者

Judea Pearl, Madelyn Glymour, Nicholas P. Jewell

概要

UCLA(カリフォルニア大学ロサンゼルス校)大学院、因果推論の講義をまとめた本書。

統計的因果推論の応用(傾向スコア、差分の差分法等)の理解に必要なグラフィカルモデルや介入・媒介等用語の基礎知識を得ることができます。その他の書籍では当たり前に使われている、本当はよく分かっていないかもしれない統計学・社会学の知識が明記されているため、学び直しには最適です。

必要知識

数式に驚かない心(内容はよく読めば簡単なことをしている)
難解な文書の読解力(数式の説明(Why?)が読み解けない可能性あり)

得られるスキル

確率と統計の基礎, グラフ, 因果構造モデル, d分離性
介入, 調整, 媒介, バックドア基準, フロントドア基準, IPW, 反事実

その他の教材紹介ページはこちら → Skill Stacks

【教材紹介】深層学習 2020年度春学期 · ニューヨーク大学データ・サイエンス・センター

米国大学のコンピューターサイエンスの講義を無料で、かつ日本語で公開されている教材がありましたので共有いたします。

名称

深層学習 DS-GA 1008 · 2020年度春学期 · ニューヨーク大学データ・サイエンス・センター

主催

ニュー欲大学データ・サイエンス・センター
Yann LeCun & Alfredo Canziani

概要

深層学習の最新技術(基礎・応用)について無料で学ぶことができる。
応用技術のベースとして、教師あり・教師なし深層学習、ベクトル埋め込みや距離学習の方法、画像認識で重要な畳み込みニューラルネットワーク(CNN)、時系列処理で重要な再帰型ニューラルネットワーク(RNN)、近年の自然言語処理の躍進を支えてきたAttentionなどを学ぶ。応用技術として、画像認識、BERTをはじめとした自然言語処理、グラフ構造ネットワークを予測するGCNなどを、理論だけではなくPythonのコードも記載されているため、動かしながら学ぶことができる。

必要知識

基礎的な機械学習及び数学の知識
・機械学習の流れが分かっていればOK
目的設定 → データ準備 → モデル設定 → 学習 → 検証
・大学教養課程の線形代数や微分
特に偏微分がふんだんに使われる

得られるスキル

深層学習, CNN, RNN, GCN, EBM, Attention, BERT, Auto Encoder

その他の教材紹介ページはこちら → Skill Stacks

【教材紹介】Python機械学習プログラミング(第3版)* 文量多め

今回の書籍は内容理解する難易度が高めですが、機械学習の基礎(用語・位置付け・アルゴリズム)が網羅できる、Pythonでの機械学習を学ぶためのおすすめ教材を紹介します。

正式名(ISBNコード)


[第3版]Python機械学習プログラミング 達人データサイエンティストによる理論と実践(ISBN978-4-295-01007-4)

内容量

648ページ

評価

総合評価

データサイエンティストになりたい方向けです。教材としては、機械学習の初歩からすべてを網羅的に説明している本です。網羅的であるため、内容量が圧倒的に多くなっています。プログラミングをしてみるだけではなくアルゴリズムの説明があるため、理解難易度は高くなりがちです。

注意したいことは、次の方は本書全てを読むことはおすすめしません。たとえば、専門分野や自分の仕事が確定していて、データサイエンスをビジネス活用したい人。
ただ、数学的な理論は読み飛ばすのであれば、ビジネス活用するための全般的な前提知識を得ることに適しているかと思います。つまり、コンサル会社や自社内のデータサイエンティストに仕事を委託するものの、中身はある程度分かっていたい方にもおすすめです。

評価:初学者

★☆☆☆☆
はっきり言って数学的な前提知識が多く、データサイエンティストになりたい人以外は難解な内容です。

評価:中級者

★★★★★
数学の基礎知識がある方には本書をお勧めします。その他の方では、機械学習に全体的に触れたあと、現場の知識をベースに理論で理解したい人におすすめです。

理解難易度

★★★☆☆
アルゴリズムの理解には行列、偏微分などの数学(線形代数)の知識が必要です。

必要知識

線形代数

行列(用語や基礎的な内容のみ)
偏微分
共分散

獲得可能スキル

技術

内容および獲得可能スキル

1.「データから学習する能力」をコンピューターに与える

基礎, 教師あり学習, 教師なし学習, 強化学習
基礎, 教師あり学習, 回帰, 分類
基礎, 分類, 二値分類, 多クラス分類
基礎, 回帰, 線形回帰
基礎, 強化学習
基礎, 教師なし学習, クラスタリング, 次元削減

2.分類問題-単純な機械学習アルゴリズムの訓練

人工ニューロン, パーセプトロン, アルゴリズム, 学習規則
線形代数, ドット積, 行列, 行列の転置, ベクトルの角度
Python, オブジェクト指向, Numpy, pandas, matplotlib
Irisデータセット
ADALINE, 勾配降下法, 偏微分, 標準化, バッチ勾配降下法, 確率的勾配降下法, オンライン学習

3.分類問題-機械学習ライブラリscikit-learnの活用

Python, scikit-learn, パーセプトロン, 正解率, 過学習, 決定領域
ロジスティック回帰, アルゴリズム, シグモイド関数, 尤度, 勾配上昇法
過学習, 正則化, バリアンス, バイアス, 共線性, L2正則化
サポートベクトルマシン, SVM, マージン, アルゴリズム, スラック変数, カーネルSVM
決定木, ランダムフォレスト
k最近傍法, 次元の呪い

4.データ前処理-よりよいトレーニングセットの構築

欠測値, CSV, pandas, DataFrame, dropna, 欠測値補完, 順序特徴量, 名義特徴量, one-hotエンコーディング,
データセット分割, 訓練データセット, テストデータセット, 標準化, 正規化, L1, L2
逐次特徴量選択アルゴリズム, 次元削減, knn, ランダムフォレスト, 特徴量の重要度

5.次元削減でデータを圧縮する

特徴量抽出, 主成分分析, 線形判別分析, カーネル主成分分析
主成分分析, アルゴリズム, 共分散,
線形判別分析, Linear Discriminant Analysis, LDA, scikit-learn
カーネル主成分分析, カーネル行列, カーネルトリック, SciPy, 射影

6.モデルの評価とハイパーパラメータのチューニングのベストプラクティス

ホールドアウト法, k分割交差検証, 復元抽出, 非復元抽出
層化k分割交差検証, バイアス, バリアンス, 学習曲線, 検証曲線
グリッドサーチ, 入れ子式の交差検証, 適合率, 再現率, F1スコア
混同行列, 真陽性, 真陰性, 偽陽性, 偽陰性, 誤分類率, 正解率
ROC曲線, 曲面下面積, 適合率-再現率曲線
マクロ平均法, マイクロ平均法, 一対全分類, クラスの不均衡

7.アンサンブル学習ー異なるモデルの組み合わせ

アンサンブル法, クラス分類, 多数決, 相対多数決
重み付け, Python, argmax, bincount
バギング, ブートストラップ標本
ブースティング, アダブースト, scikit-learn, 勾配ブースティング, XGBoost

8.機械学習の適用1-感情分析

自然言語処理, 感情分析, 極性, 書き手の意見, 意見マイニング
Bag-of-Words, BOW, TF-IDF
正規表現, トークン化, 英語, ワードステミング, NLTK, ストップワード
アウトオブコア学習, リカレントニューラルネットワーク, CountVectorizer, TfidfVectorizer, HashingVectorizer, Word2Vec
トピックモデル, Latent Dirichlet Allocation, LDA, Expectation-Maximization, EMアルゴリズム

9.機械学習の適用2-Webアプリケーション

SQLite, Flask, sqlite3, HTML, WTForms
モデル永続化, pickle
デプロイ, PythonAnywhere

10.回帰分析-連続値をとる目的変数の予測

回帰分析, 単線形回帰, 重線形回帰, 相関行列, 多項式回帰
リッジ回帰, ラッソ回帰, Elastic Net(L1+L2)
決定木回帰, 情報利得, ランダムフォレスト回帰

11.クラスタ分析-ラベルなしデータの分析

教師なし学習
k-means, k-means++
ハードクラスタリング, ソフトクラスタリング
エルボー法, シルエット分析
階層的クラスタリング, 凝集型, 分割型, 単連結法, 完全連結法
DBSCAN

12.多層人工ニューラルネットワークを一から実装

多層人工ニューラルネットワーク, バックプロパゲーション, フィードフォワード, アルゴリズム

13.ニューラルネットワークの訓練をTensorFlowで並列化する

TensorFlow, CUDA, OpenCL, テンソル
シグモイド関数, 双曲線正接関数, ソフトマックス関数, ReLU活性化関数

14.TensorFlowのメカニズム

計算グラフ, TensorFlow 1.X, TensorFlow 2.X, Keras
自動微分, 連鎖律, 損失関数
決定木ブースティング

15.画像の分類-ディープ畳み込みニューラルネットワーク

畳み込みニューラルネットワーク, CNN, サブサンプリング層, ドロップアウト
オプティマイザ, Adam

16.系列データのモデル化-リカレントニューラルネットワーク

リカレントニューラルネットワーク, T-BPTT, 系列データ, 再帰, LSTM
Transformer, Self-Attention, Multi-Head Attention

17.新しいデータの合成-敵対的生成ネットワーク

オートエンコーダー, AE, VAE, エンコーダ, デコーダ
GAN, 価値関数, バッチ正規化
全変動, KL情報量, JS情報量, EM距離, 勾配ペナルティ, DCGAN, モード崩壊

18.複雑な環境での意思決定-強化学習

強化学習, 環境, エージェント, 報酬, マルコフ決定過程, モデルフリー, モデルベース
動的計画法, モンテカルロ法, TD学習
グリッドワールド

補足

この本は文量が多すぎたため、他の教材では1分で読める文量にしています。

その他の教材紹介ページはこちら → Skill Stacks

Windows(64bit)環境でgccコマンドを使うためのMinGW-W64インストール

Windows10(64bit)環境でgccコマンドを使いたいということで、MinGWのインストールを行います。MinGWはコンパイラ(解読機)であり、プログラム言語であるC言語やC++の開発にも使用することができます。

今回はコマンドライン上でgccコマンドを使うためにMinGWをインストールをしますので、
・インストール
・コマンドラインへのgccコマンドの導入
・動作確認
の流れでインストールを進めます。

日付:2021/12/28
OS:Windows 10(64bit)
ブラウザ:Google Chrome

目次

  1. MinGWの入手
  2. MinGWのインストール
  3. パソコンの環境設定
  4. MinGWの動作確認
  5. まとめ

MinGWの入手

MinGW公式サイト ダウンロードページのMingW-W64-buildsから、ダウンロードを行います。


少しわかりづらい位置にありますので、ご注意ください。

別サイトのSource Forgeに移動した後、自動的にインストールが開始されます。

MinGWのインストール

ダウンロード完了後、ダウンロードしたexeファイルをクリックし、インストールを開始します。

設定は1か所のみ変更が必要です。

この画面のArchitectureを「x86_64」に変更しインストールを行います。

※i686だと32bit対応になります。

インストールを実行します。

Finishボタンを押し、完了させます。

パソコンの環境設定

MinGWのインストールは終了したものの、コマンドライン上ではまだgccコマンドが使えません。
gccコマンドを使えるように、パソコンにパスを通すことを(コマンドライン上で実行可能に)します。

まず、コントロールパネルからシステムに移動し、システムの詳細設定をクリックします。

続いて、環境変数をクリックします。

環境変数Pathを選択し、編集をクリックします。

最後に、新しくパスを通すMinGWのディレクトリ名を入力します。実行した例では、下記の通りです。
C:\Program Files\mingw-w64\x86_64-8.1.0-posix-seh-rt_v6-rev0\mingw64\bin

ただし、インストールしたバージョンなどによってパスが変更される場合があります。
下記の流れでパスの確認を進めてください。

MinGWのディレクトリ(フォルダ)名を確認するには、WindowsメニューからMinGW-W64 ProjectのRun terminalをクリックします。

そうすると、ターミナルの一番上にMinGWのディレクトリ名が表示されます。これをコピーします。

コピーしたディレクトリ名が、
C:\Program Files\mingw-w64\x86_64-8.1.0-posix-seh-rt_v6-rev0\
とすると、
C:\Program Files\mingw-w64\x86_64-8.1.0-posix-seh-rt_v6-rev0\mingw64\bin
を環境パスに入力してください。

これでパソコンの環境設定が完了します。

MinGWの動作確認

コマンドライン上でgcc -Vコマンドを実行してください。
下記のように表示されます。

これにて完了です!お疲れ様でした~(^^ノ

まとめ

今回はWindows10の64bit環境のコマンドライン上で、gccコマンドを使うためにMinGWをインストールしました。
C言語やC++のコンパイルの実行については、Windows10(32bit)でのC言語およびC++のコンパイラ「MinGW」のインストールとテストをご覧ください。

Meisyo+とMeisyoのアクティブ人口比較

野球ゲームMeisyo+リリースから3か月目に入りました。


アクティブ人数(日ごとのログイン人数:DAU)を比較したところMeisyoを超えました。
IP等を見た限り、並行で遊んでいただいている方が多く、順調と思われます。

その原因としては、どうやら「ユーザーの知人紹介」で増えたようです。
※チャットにコメントが来てました。ありがとうございます。

認知度が限りなく低いので、少しずつ見えるところに置いていきたい・・・と思い色々試行錯誤中です。
チャネルを増やすってことですね。

より多くのユーザーの方に楽しんでいただけるよう更新を行っていきますので、コメント等もよろしくお願いします!

Flask-Babelを使って、Pythonアプリで多言語対応を行う

Pythonで多言語対応してみたいなーと思っていました。
思っていましたが、実際になかなか使うタイミングがない・・・。
今回自作ゲームでユーザー数の増加がみられ、かつ海外からのアクセスも複数確認できたので追加することにしました。

目的

名将と呼ばれた者達+のアクティブ人口を増やすために、少しアクセスがあった中国語と英語に対応する。

バージョン情報

flask-babel==2.0.0

作業

5が一番つらい

1. 翻訳ファイルテンプレート作成
pybabel extract -F babel.cfg -k lazy_gettext -o translations/base.pot .

2. 各言語の翻訳ファイルを定義
pybabel init -i translations/base.pot -d translations -l ja
pybabel init -i translations/base.pot -d translations -l en
pybabel init -i translations/base.pot -d translations -l zh
pybabel init -i translations/base.pot -d translations -l ko
# 日本語, 英語, 中国語, 韓国語に対応

3. テンプレートを翻訳ファイルに定義
pybabel update -i translations/base.pot -d translations

4. view, functions, templatesのファイルを書き換える
・view, functions
from flask_babel import gettext
gettext(”)

・templates
{{ gettext(”) }}

5. 各言語の.poファイルを書き換える
gettext(‘文字列’)内の文字列がリストアップされて、自分で翻訳文を書く。自動翻訳ではない。つらい。

6. .poファイルをバイナリ.moファイルに書き換える
pybabel compile -d translations

Flaskの構成


Flaskの詳細な構成については、VPSでつくるPythonでのWebアプリ運用環境(連載記事)をご覧ください。基本的な設計思考は同じです。

下記をapp.pyのreturn app前に定義してください。

    # 多言語対応
    babel = Babel(app)
    @babel.localeselector
    def get_locale():
        return request.accept_languages.best_match(['ja', 'ja_JP', 'en', 'zh', 'ko'])

※ja_JPがないとバグが起こる可能性もあるようなので追加しています
※ko(韓国語)は記載例。他の言語も同様に追加可能です。

どれだけ変わるの?

メイン画面で比較してみました。

日本語

英語


各ボタンのpossible要らないねえ…

中国語


ガバ翻訳すぎた

注意することは何?

コードの書き方です。
コードの書き方如何で作業量がかなり変動します…。

さいごに

今回はFlask-Babelで多言語対応を行いました。
目的はあくまでアクティブ人数の増加、それを目指すためのアクセス数の増加です。
そちらの続報については1~2か月後に記事を書きます。

Meisyo作者がサービスを作るにあたっての考え方

私は、以下の考え方に違和感を覚えている。

いかにそのサービスに、ゲームに集中、執着させるか。
ゲームであれば、毎日何時間も時間を使わせて、注目させて、お金を支払うように仕向けるべきである。
無課金ユーザーの注目も広告業者に売ることができる。

・・・といったものである。
その環境下で、大量の頭のいい人が、「いかに広告をクリックさせるか?」に今も従事している。
例えるなら、Facebookやツイッター、ソーシャルゲームだ。

果たして、それで本当に良いのだろうか?と私は考えている。
胸を張って、「私がこれを作りました」「これ、良いでしょ?」と言えるのだろうかと。

私はサービスを作る、仕事では分析する、コンサルティングするにあたって、その点で一つ大事にしていることがある。
今考えうる中で、人に悪影響を与えない方法であるか?である。
だから、上記の懸念がある広告業界はあまり受け持っていない。

私は、執着させないサービス作りをしている。

本業や人とのリアルの付き合いなど、大切なことにいかに集中してもらうか。
それがあることが前提で、副次的に楽しんでもらうゲーム、または大切なことのサポートとなるようなサービス
を作っている。

もちろん、その考え方には製作者側にメリットがある。
名将と呼ばれた者達という野球ゲームでは、有名スマホゲームのプロ野球スピリッツのようにコンテンツは多くない。
当たり前だが、企業(集団)で作ったゲームに比べ、コンテンツ量が圧倒的に足りない。

そこで、1日に費やすことのできる時間を制限することで、コンテンツ不足を感じさせにくいようにできる。
だから、継続していただいてる方は相当な長期間ゲームとして遊べるつくりになっている。
結果的に、一ユーザーが長期間プレイしてくれることが、その人自身がゲームの一コンテンツとなる状況を作っている。

ユーザーに負荷をかけさせない方法で、だ。

Facebookのようないいねの魔術によるものでもない、
大量のコンテンツにより、ずっとプレイしていないと人権がないモノでもなく、
ただ、そこに限られた量を少しずつ楽しめるようにしているだけだ。

経済的に成功してようが、ユーザーに直接的、または間接的に不利益を被らせているようであれば、悪徳な情報商材と全く変わらない。

テクノロジーがあまりにも進歩しすぎたため、人が追い付いていない。
テクノロジーに無意識に人生をコントロールされている人が何人いるのだろうか?
それは、あなたや、親しい人ではないのだろうか?
運よくそこから外れたとして、人に合わせてテクノロジーを使うべきではないだろうか?

その考え方は、サービスしかり、ゲームしかり、そして、今後の人工知能しかりに適用すべきだろうか。
あなたは、どう考える?

ゲームのつくり方

何で書こうとしたの?

ゲーム制作者が自由な記事を作る Advent Calendar 2021があったのでつい…
昔からゲーム開発の方法論を簡単にまとめたいと思っていましたが、いいきっかけだと思って書いてます。

ゲームを作る、サービスを作るってかなりハードルが高そうですよね?
無論・・・高いです。
1機能をサクッと遊べるものならいいのですが、少しリッチになると20時間以上かかります。

とはいえ、作れるのは作れます。
作ったらわかりますが、手戻りが何にしても多いです。
必要だと思わなかった機能やデータベースが足りなくて動かねえ・・・なんてのはよくあります。

そのため、ゲームのつくり方を夢物語ではなく、現実味のある整理した方法論を提示したいと思います。
僕でもできるかも?と思って、行動いただければ嬉しい限りです。

著者は何をしている人なの?

仕事は、データ分析のコンサルタントです。
例えば、ソーシャルゲームおよびコンシューマーゲーム開発・運営での必要なデータ分析を行っていました。
得意な所は要件定義ですが、基礎集計からAI開発まで手広くしています。
今は社外の教育研修や品質担保のためのレビューをしてます。
もちろん他業種のコンサルティングも行っていますが、会社の主要顧客はゲーム業界です。

趣味は、個人でのゲーム開発(戦略シミュレーションゲーム)をしています。
名将と呼ばれた者達(Meisyo)では登録者2,500名程度、PV数は月3万程度です。
名将と呼ばれた者達+(Meisyo+)では登録者50名程度、PV数は月2万程度です。

収益は月で+1万円程度になってきました。

仕事で行っているゲーム開発やサービス開発も、以下で紹介する流れと同じです
むしろ自分が独自に行っていた方法論を企業が取っていて驚きました。

それでは手順を説明します。

ゲームのつくり方

開発方法名は知り合い駆動開発です。
知り合いを巻き込んでプレイユーザーを確保しながら、開発のモチベを維持する方法です。

  1. アイデア構築
  2. 知り合いに知らせる
  3. 概要設計
  4. 機能・データベース設計
  5. 基礎UI/UX設計
  6. プロトタイプ作成
  7. 作成 & PDCA
  8. サービス終了

大事なことは、まず作り始めるのではなく、まず概要を決めます。
著者自身が戦略系ゲーム好きなので、触った感触等々よりゲームバランスがどうしても重要になります。

適当に作ってみると、結局これ以上作る気がしないモノができます。残念ですね。
というわけで、具体的に手順を見ていきましょう。

1. アイデア構築

何を楽しんで欲しいか?を考えます。

何でも構いません。
例えば、モンスターストライクであればはじく楽しさが一番大きいでしょう。

自作の野球ゲームMeisyoでは、考える野球を楽しもうという少しマニアックな楽しさを基本としています。
PJ_Meisyo+の設計書も作りました。

このように、何を作りたいか?を先に決めるのが重要です。
そうしないと何が困るのでしょうか?

アイデアは思い付きであることが多いので、何を楽しいで欲しいか?具体的にどう楽しめるのか?を考えないと作っている途中で忘れてしまう・・・というちょっと間抜けな内容でした。

2. 知り合いに知らせる

次に、それが好きそうな人または一番知り合いに知らせましょう。

人は、他人に宣言すると実現せざるを得なくなります。
辞めると宣言するのにもエネルギーを使います。

そのように、心理的なバイアスを使います。
加えて、初めてのユーザーを獲得するというステップをクリアするには、この方法が一番簡単だからです。

3. 概要設計

何を楽しんで欲しいかから始め、何をできるべきか要素を考えます。

考える野球とは何か?を考えます。
プレイさせる?できない?
野球の対象は?高校?社会人?
監督と選手の関係は?指示命令?仲間?

のように・・・アイデアを具体化していきます。

基本的に僕はアイデアを紙に書きます。


マインドマップ
と呼ばれるモノですね。

この方法を取ることで、機能やデータの持ち方(データベース)をあらかじめざっくりと作成できます。

4. 機能・データベース設計

概要設計をしたものを利用し、要素ごとに機能やデータベースを作成します。
ここから、Excelなどで管理していくことになります。

とはいえ、1シートで作り終えるレベルの内容で良いです。
あくまで、忘れず完遂するためのモノであって、やる気をそぐためにしているわけではないからです。

ただ、何も考えずに作ると、左のように(悲報)何を入れていたデータベースか忘れる等に見舞われます…。

5. 基礎UI/UX設計

最初に、どんなふうに楽しんで欲しいかをイメージしていたと思います。

それを実際の画面に落とし込んでみます。
スマホならスマホ、WebならWebの大きさがあるので、紙に絵を書いてみましょう。

イメージ図があるなら、それをどこかに保存しておきます。
Meisyoなら、

や、

です。

6. プロトタイプ作成

ここまで出来たら作り始めます。
こうすることで、形にできないアイデアを元に作って、結局完成できない・・・なんてことをなくします。

ただし、色々な表示機能を実装するには検索スキルが必要なので意外と難しいです。

思ったよりズレたりする。

7. 作成 & PDCA

作ったからには多くの人に遊んでほしい・・・当たり前の感情だと思います。
まずは、累計プレイ人数〇人や新規登録人数〇人という目標を立てて、PDCAを回してみましょう。

そこで、ユーザー心理をステップに分けてどこが上手くいっていないか、
Webの場合はGoogle Analyticsなどで分析して作り込んでいきます。

例:
初回アクセス
↓
「楽しそう、登録してみよう」
↓
新規登録
↓
「どんなゲームかな?」
↓
一回目プレイ
↓
「この動き楽しいな。」
↓
二回目プレイ
↓
・・・

さて、あなたのゲームはどんな楽しみ方になるでしょうか?

上記の内容を難しく言うとカスタマージャーニーです。

本格的に分析するのであれば、
カスタマージャーニーマップ
や、
サンキーダイアグラム

など、様々な方法があり、基本的にユーザーの離脱しているポイントを洗い出して、問題点を解決していく手法となります。

Meisyoは2,500名以上登録があります

数字が見えているからこそ、モチベーションの維持が簡単になります。

8. サービス終了

サービス終了を最初から頭に置いてサービス運営を開始します。

なぜなら、時間は有限です。
どうしても使う人が居ないサービスに時間を使っても仕方がないので、サービス終了を行います。

私の場合、これまでで少なくとも20サービス以上終了させています。

最近では、野球ゲームMeisyoの前身もサービス終了*1しましたし、タスク管理ツールのWork It!もサービス終了*2しました。

*1 汎用的に強い選手カード(イチロー、王等)を出し、その選手以外必要がなくなった。

*2 タスク管理ツールもどきで、何をしたいのかわからなくなった。

終了まで考えてサービスを作りましょう。
お金も、時間も掛かりますので。

最後に

3行でまとめまると、
・記録して
・目標を立てて
・楽しんで作ろう

というように、ゲームを楽しんで作るために、ちょっとしたコツを書きました。

それではまた!

[Meisyo+] データ分析その1 能力値ベースの打率予測

監督視点の野球ゲーム Meisyo+でデータが貯まってきたので、打率の予測をしてみました。

打率は高ければ高いほどいいですが、実際のところどの能力値を重要視していいかわかりません。
そのため、今回はどの能力値を重要視すれば、打率の向上によさそうかの判断基準を作りたいと思います。

使用データについては、ゲーム内の機能の分析室にデータ出力機能がありますので、そちらのデータと下記のコードを使うことで自分のチームの傾向を分析できるようにしています。

実験方法

コードの詳細については、Github:meisyo_analysis/ver1をご覧ください

使用データ

・選手の属性
・選手の能力値
・選手の打撃結果(集計値)

使用データの前提

野球は投手vs打者で打撃結果(打率含む)が決定しており、打者と投手の相性は少なからず存在します。(ように作ってます)
ただ今回は、選手の打撃結果が集計値のため、投手起因の値は丸め込まれていて予測できません。
つまり、野球でよく言われる「いい投手に対してかなりの打席数があったので、この打者の打率は低かった」や「この投手のカーブにこの打者は弱い」、「2ストライクになるとミートが下がるので打率が下がる」などは無視されています。
下記の結果は全体の傾向でしかない点にご注意ください。

使用データの対象

いつ?

2021/10/24現在の情報

どのチーム?

集計対象チームは、管理者(れい)のチームとNPCチームのみ。

どの球場?

全球場。
グランドの大きさ・フェンスの高さに違いがあるので、球場別に分析した方がいい気がする…。

何のデータをもとに?

選手の打撃に関わる属性値、能力値(合計値)

何を予測?

打率(回帰分析)
各種打撃結果の集計値はあるので、他の指標(OPSやWARなど)の分析は可能です。
※変数名が分からない場合はコメントください。テーブル定義書を作成します。

結果

示唆1:全体傾向

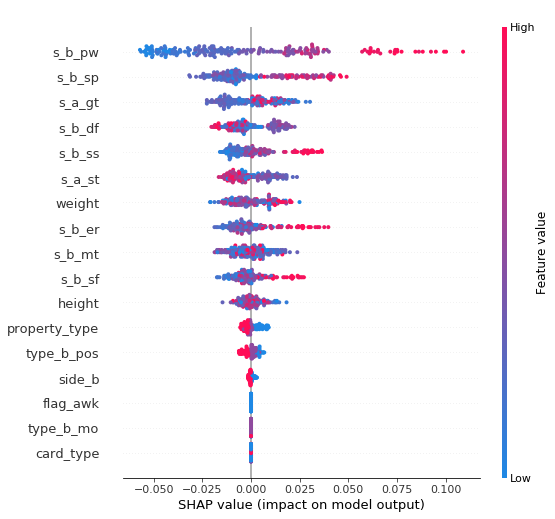
SHAPを利用して分析しています。

図の見方は、赤くなるほど打率が高く(青くなるほど低く)、右に行くほど変数の値も大きいです。
そのため、各説明変数がどのように目的変数に寄与しているか確認することができます。

効果がありそう:
パワー(b_pw)、走力(b_sp)、反応(b_ss)、エラー回避(b_er)
→ 当たり前の結果。
属性(property_type)、打席位置(type_b_pos)、打席(side_b)
→ 意味のある数字が出ているように見えるが、よくわからないので個別に確認する。

マイナスの効果がありそう:
体力(a_st)、守備(b_df)、
→ このステータスを重視すると、選手ごとの能力値の合計を一定にしているため、打率の向上に効果があるステータスが低下するためだと考えられる。

効果がなさそう:
根性(a_gt)、体重(weight)、身長(height)、肩力(b_sf)
→ 直接関係するところではない。
ミート(b_mt)
→ 驚くところかもしれないが、ゲームの進捗として変化量が多い投手が少ないのでまだ出番ではない。

変動なし:
覚醒有無(flag_awk)、打撃モーション(type_b_mo)、選手タイプ(card_type)
→ 打撃モーションは設定しているものの、未実装のため。

示唆2:個別傾向

詳細は上記Githubの分析コードファイルでご覧ください。

属性(property_type):
心(H)技(T)体(B)のうち、なぜか体が有利。
投手に有利属性の心(H)が多いからか?(データはない)

打席(side_b):
左打席の方が一塁に近いため、ほんのちょっと出塁しやすい。

打席位置(type_b_pos):
前(F)中央(C)後ろ(R)のうち、なぜかCが有利。
後ろは速球に対して反応しやすいが、変化球に弱くなりがち。→速球投手が居ないので、今のところ出番がない。
前は速球に弱いが、変化途中を打つので大きな変化球に対応しやすい。→大きな変化球を持つ投手がほぼいない。
なるほど・・・その結果、中庸の中央が強いのか。

身長・体重:
まだ試合に反映していません・・・。

まとめ

意外や意外、打率にはミートがほとんど寄与していない傾向にあることがわかりました。
今のところパワー is 力になっていますが、投手が育ってくると速球・変化球のどちらか、またはどちらもに対応する必要が出てくるため、ミート(変化球)と反応(速球)が必要になってきます。

ただし、打撃ばかりに注力していると守備特化や走塁特化にボロボロにされる現象が出てきます…。
NPC早波高校が良い例だと思います。あいつらは強い。
どちらかというと現状は守備を優遇した計算にしているつもりですが、バランスが悪い場合はバランス調整が入る可能性があります。

それでは、また~(^^ノ

Appendix

Light GBM sample_weightの有効性確認

有効性があると考えられる結果となりました。
詳細は上記Githubの分析コードファイルでご覧ください。

コードの記法

    # btr_pa(打数:重み)を取得する
    X_train_weight = X_train['btr_pa']
    X_train = X_train.drop(columns=['btr_pa'], axis=1)
    X_valid = X_valid.drop(labels=['btr_pa']) # X_validがSeriesのため、dropの記法が独特

    # lgb
    lgb_train = lgb.Dataset(X_train, y_train, weight=X_train_weight)
    lgb_valid = lgb.Dataset(X_valid, y_valid)

    # model
    model = lgb.train(params, lgb_train, num_boost_round=num_round)

weight=X_train_weightだけでいいのか・・・うせやろ・・・。
logistic_regression等にもsample_weightは実装されています。他のモデルでも使える普遍的な考え方ということですね。

結果

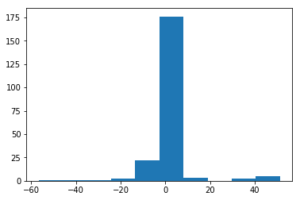
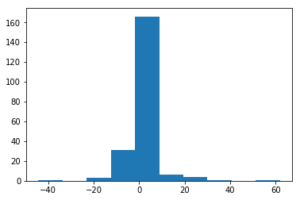
dw = diff(打率と予測打率の誤差) * weight(打数)として重み付けをした誤差で、どちらのモデルの方が予測精度が良い(=誤差が小さい)のか判定した。

sample_weightなし

図は各サンプルの誤差の分布を示しています。

MEAN: 0.6766849656317994
MAE: 4.013002739923537
STD: 10.142118959652125

sample_weightあり

図は各サンプルの誤差の分布を示しています。

MEAN: 0.614371189810878
MAE: 3.328403506460046
STD: 7.6495407120552015

補足1

理想的にはdwは0になるといい。
ただし、そんなことはあり得ないので打数で重み付けして、打数が多い場合の誤差に罰則を大きくしている。

補足2

sample_weightの重要性は最近下記の本で目覚め、
お仕事(DX人材教育(ライフサイエンス系))で、この疾病の予測で重要視すべき患者はどの人か?などの回答に使えると思っています。使い方としてはアンダーサンプリングしない不均衡データ予測、計算方法はIPWなどとよく似ている…?似てないか。

その他のお仕事でもsample_weightを導入することで、予測精度の改善に寄与することを確認しました。

補足3

sample_weightの考え方は重要度が増してくると思うので、再度調べて記事を書きたいと思います~。
どうすれば上手く使えるかなあ。

[Meisyo+] リリース前準備完了

名将と呼ばれた者達+の機能があらかた実装できました。
現在はゲームバランス調整のために、試合や練習などの状況を確認している最中です。

β版リリース日を8/28目安にしています。
よろしくお願いいたします。

※注意点
ベータ版はデータリセット前提のテストプレイ用プログラムです。
ベータ版に参加していただいた方には、Meisyoのアカウントと、Meisyo+本実装の際にささやかですがアイテムをプレゼントいたします。
なお、Meisyoとはデータの互換性がないため、データ移行は予定していません。

スクリーンショット

練習(手動 or 自動)

UIや処理体系が見直され、分かりやすくなっている。(予定)

試合

見た目は同じ感じですが、内部ロジックが大きく変わっています。
表示するログの種類・量も増やすことができたので、分析が捗ります。

(旧)特訓や探索も見直しています。

リアル志向に寄っていて、「データを取ること」に重きを置いています。
結果を集約して分析する機能はまだできていませんが。

調整の未完了機能

・試合
 バグがまだある状況なので、リリースできません。

さいごに

ある程度、バグが少ない状態でリリースできるかなという状況です。
「まずはリリースしてみてから」というのはあるのですが、
あまりにもLvが上がりやすかったりすると、テストプレイにならないというか、何というかゲームとしてどうなの(呆れ)・・・なので調整しています。