[社内コンペ] 間取り予測

これは何?

某社で行われている社内コンペのメモです。私の備忘録でもあります。

結果:3位
精度:60.7%

今回は学習データが12,000件ほどあり、ある程度多いデータ量での学習ができました。
学習データは評価データと分布が同じとされていましたが、それはちょっと怪しかったかなと思います。

今回の目的変数

「その部屋が何の間取りに種別されるか」のテーブルデータの多値分類問題です。

回答は、
・3LDK
・2K
・1K
などとよくある形です。目的変数の種類が多い(最大38個)ことを除けば。

今回の評価指標・ベースレート

Accuracy(精度)です。

出題者によると、お試しの意味も込めてAccuracyだそうです。
普通なら複合指標による評価が妥当とされています。
Precision(適合率:真の陽性をいかに漏れなく見分けられたか)やAUC(認識性能の高低を表す)、MAP(Mean Average Precision、Precisionの応用)などなど。

ベースレートはAccuracy50%でした。

僕は、検証の際はAccuracyを用いていました。
今回は別の目的があり、全く工夫をしませんでした。

今回の説明変数の特徴

テーブルデータ

訓練に使用できるのは12,000データ

同じような目的変数がある

 3LDK、3DK、3K・・・違いが判らん!
 それらのデータの特徴量も似たようなものでした。
 つまり、ルールベースで分けたほうが精度が上がる目的変数のグループも存在しました。
 ルールベースで分けること自体はKaggleやSIGNATEではあまり言及されませんが、現場ではよく使われる手法です。実データはデータ量が足りない場合も多く、環境が整っていないからその手法採用されているだけで、本来のデータが潤沢にある状況であれば予測すべきです。

説明変数の作成が手入力(で雑)

 家探ししているとよく見かけるのですが、敷金、礼金は家賃の〇か月分ってありますよね?
 その値が手入力のようで、一致している場合もあればしていない場合もありました。

 例を挙げると以下のようになっていました。
 ・家賃:8万
 ・敷金(家賃の〇か月):2
 ・敷金額:12万円 ← What’s?????

今回の目標

特徴量生成のみで乗り切る。
(一応3位なんで乗り切れたと思いたい。)

今回行った特徴量生成の方法

データの適正化

手入力が多かったので上記のようなことが起こっていました。

グループ平均との差分を取り、標準偏差で表す

例えば、「その地域の家賃平均から高ければ高いほど、大きな部屋である可能性が高い」を数値化しました。

グループ内での順位を取る

上記と同じ考え方です。

業者の電話番号は業者ごとに存在すると考え、ラベルエンコーディングで特徴量化しました

建設業者はそれぞれの得意な分野(大きさ、形、場所)があり、棲み分けがされているようでした。
施設管理・施設設計をしていた経験からそう判断しています。施設の発注代がとても高かった記憶があります。(‘A`)

UMAPでの次元削減

t-SNEと同様でしたが、計算速度が速い・・・ハズ。
ただ、計算リソースが少ないPCだと結構エラーが出るので面倒でした。
Kaggleであった同様のコンペでは効果があったようですが、今回はあまり意味がなかったです。

K-Meansクラスタリングで教師なし学習結果を特徴量化

大分類で8クラスに分かれることが分かったので、それぞれの確率を特徴量としました。
あまり意味がなかったorz

その他の情報

モデル:XGB+LGBM(23:1)アンサンブルモデル
バリデーション方法:層別K-Fold(9:1)
パラメータチューニング:Optuna、Optuna LGB

その他の解法

パラメータチューニング

Kaggleで勝つデータ分析の技術P.318-320に載っているパラメータチューニング方法を、XGBにそのまま使うと大分上手くいったようです。

Optunaはベイズ最適化なのである程度は上手くいきますが、より精度を高めるのであれば手動をお勧めします。
それをしないと無理な境地がありそうです。
Deep Learningを含めて全部できるのはスゴイと思う。計算速度の良いPCが必要だ・・・お金足りないよ。
Optuna LGBは初めて使いましたが、Optunaに比べコードがかなり簡略化されており、初心者にも扱えそうで便利でした。

※個人的に、Kaggleはデータ分析というよりデータモデリングが主だと思っている。

スタッキング

よく使われるようになった手法。
ただし、今回はあまり効果がなかったようです。

※私は使ったことはない。

最後に

間取り予測して何に使うんですか?
目的がわかってない、分析では最悪なパターンです。

コンペに参加する目的が最近の手法の大枠を捉えなおすことなので、ボチボチ更新できたかなと思う程度でした。
日本語のはある程度読みましたが、海外の資料や論文は10も読まなかったかな。
この考え、動き方を社内でできる人を増やす方向で動いているので、あまり時間を割きたくないという理由もある。

やってみたではなく、何を考えたか、なぜそう考えたかを包括的に書いた記事が少ないので、少しずつですがアップしていこうと思います。
その他コードやデータサイエンス関連の質問はR:Twitterまでお願いします。

[Meisyo] 雑記20200731

今考えていること

ユーザー数増加は続けたい

ここ2週間の施策でDAUが20%くらい増加しました。
コメントいただいた方、ありがとうございます。
Twitterでコメントを頂くこともありました。

一時期、新規ユーザーが完全に離脱することになっていたので、とても低迷していました。
戻ってきていただいている方もいて、ありがたい限りです。

アイテム獲得量の増加

今後、特訓はミニゲーム付き or なしを選べる状況にしようと思ってます。
1. なしは報酬固定&ランダムアイテム獲得、
2. ミニゲーム付きはゲーム自体はランダム選択ですが、難易度を選択できます。クリア難易度が高ければ高いほど良いアイテムが出る可能性を上げたいと思います。
(その分、探索もアイテム量増加を検討中です)

強化周りの半自動化

強化の試行回数が多いため、模擬戦のような半自動化を検討しています。
必要アイテム量は変えない予定ではあります。

表示系の改良

外野へのヒットがゴロまたはフライかひと目で確認できるようにする。

データ周りの追加

打撃・投球データに対戦選手のIDを追加します。
どの選手に対して有利か不利かを判断できるようにする予定。

試合の守備アルゴリズム周りの調整

まずは適正化。
次に、今は投手・打撃ゲーになっているので、守備を強くする予定です。
どのパラメータを選んでも勝てるようにしたい。
あとはこのパラメータはこれが苦手、みたいな形にできるとなお良いが…。

個人的な感想

ホントに勝てない相手が出てきたので、色々と試行錯誤するのだけど勝てない…
上位陣が本当に選抜された投手と野手の組み合わせが強すぎる。
(運ゲーだと思ってました。すみません。)

過去に活躍した選手も、監督リセット+選手リセット複数を使って第一線に復帰させることができた。
ただ、やはり元々のステータスを生かさないともったいないな…。
守備固めにしていた選手が、意外とベースの打撃能力が高いなということで再利用してます。
いつの間にか育てたい選手のLvを上げれるようになるのが楽。犠牲はつきものですが。

その分オリジナル選手(投手)の育成が遅れてますorz
速球S120超え行けそうな逸材なんやが…ゲーム内ポイントが足りない。
だいたい意図した内容にはなっているものの、作者にも把握しきれない共変量が多すぎて難しい(楽しい)です!

今後のストーリーはどちらかというと「高校野球」に疑問符を投げかける内容になりそうです。
お楽しみに。

[Meisyo] 表示系の改善

なぜやったか

新規登録ユーザーの短期継続率が低い

問題点

新規登録ユーザーの導入部分がわかりにくい

変えたこと

・チュートリアル変更
・メインページ変更
・各ページUI変更

詳細の理由

以前から、新規登録ユーザーの継続率が低いことがわかっていた。
ただし、いろいろなチュートリアル改善の施策を打つも全く上がらないことがわかった。

今回、ある方々に協力していただいてUI改善に取り組んだ。
なぜなら、「自分で問題点がわかっているのなら改善できているはずである」ということである。
そうなっていないということは、他人に頼らなければわからないであろうと思い、実施した。
(謝辞:いつもコメントありがとうございます。)

UIはゲーム構造が分かってからの利便性は高くなっており、長期継続するユーザーは1年近く継続していただいている。
そのため、まずは理解をしやすい文字列に落としこみ、触っていただける範囲を増やそうとした。
UIはその分、見てくれが変になっている可能性がある。

あとはチュートリアルを、ユーザーがまず一番触りたいであろう試合中心ではなかったので試合中心にし、ストーリーを変更した。
ストーリー自体は大きく変わっていないが、見せ方を変えた。

結果

1か月後に報告する。

未経験がエンジニアを目指すことって、それって意味あんの?

未経験のエンジニア転職についての広告が多い。
つまり、それだけ広告を出しても利益が上がる状況にあると言えよう。

ただよく考えてほしい。

給料はそんなに高くないし、コードを書いているだけなら給与は上がらない。
設計や方針設定、人のマネジメントに携わらないと、新卒やオフショアとの価格競争に巻き込まれる。

かつ、とてつもない速度の技術更新についていく必要があって、他の職種より積み上げが難しい。

そこであなたは生き残れるのだろうか?
分が悪いのではないだろうか。

記憶力は一般的に若いほうが高いし、ライフステージとして若いほうが学習時間が取れる。
果たして勝てるのだろうか?

その状況の中で、現在のあなたの業務知識を活かす転職をしたほうが結局幸せではないだろうか?

私の話をすると、研究員からコンサルタントに転職し、1年2ヶ月で課長クラス(年収600万前後)まで昇進するほどある程度の成果を挙げている。
エンジニアとは少し違うが、知識を更新していき、説明する必要があるという意味では、エンジニアよりハードかもしれない。

そこには他人には努力に見えるようなことがあった。
1・関係する技術の論文が読めるレベルの学習
 大学学部で学ぶレベルは全て目を通し、自分の言葉で話せるようにした。

2・社内でのつながりを作る
 ある程度意識的に意思疎通を行い、誰が何を知っているのかを知る。
 そこで人に頼り、関係を作っておく。
 積極的な飲みニケーションはしない。基本無駄になる。

3・納期は確実に守る。
 寝る時間以外は作業することは2回あった。
 信頼はいつもの業務が完遂されるかにかかってくる。
 信頼されなければ仕事は任されない。ゆえに自分が思った通りの仕事のシステムが作れないため、楽に仕事ができない。

4・仕事はシステム化する
 繰り返し作業は自動化する or 誰かに任せる、で基本自分はやらない。そこに付加価値はない。

そのような何らかの工夫があってこそ、結果も安定して出せる。
そのことは研究員時代、はては大学・大学院の時代からわかっていた。

ちなみに努力に見えるが私本人としては努力をしているつもりはない。
それが当たり前だからだ。

そのような工夫がない限り、一般的なエンジニアにとどまるしかない。
その給与は500万に行くかどうかでしかない。

作りたいものが作れる?
ふざけるな。お金の流れを考えてみろ。

誰かがシステムが欲しいからこそ会社に依頼が来て、そこでエンジニアに割り振られる。

作りたいものは個人で作れ。それか会社を創って作れ。
そこで儲けられるかはあなたの手腕にかかってくる。
そんな甘い世界ではないし、上手くいく人には理由がある。

私はエンジニアとしては、作りたいものを作るタイプなので上手く行かないことはわかっている。
しかも、「(興味のない)技術更新はめんどくせえな」なタイプである。
かつ、大学・大学院で専門に学んできた分野は化学・生化学であり、コンピューター科学ではない。知識で勝てるわけがない。

ならば、戦う場所はある程度制約がかかるのは理解できるだろう。

あなたはあなたの積み上げてきたものと行動パターンを考えて、エンジニアを目指そうとしているのだろうか?

個人での戦略を立てなければ、一般に埋没してしまう。
結果、今の給料とそう変わらないが、学習する時間は取られ続けるコスパの悪い職種となる。

「自分で考えられる」と思っている人のほとんどがパターン認識であるし、
なんとなく前例があるから判断をしている場面は多くないだろうか。

考えるを言語化したことがあるのだろうか?

あなたはその現実から逃げても、夢は現実でしかない。
広告は良いことしか言わないし、エージェントは基本あなたの人生なんか考えちゃいない。
あなたはノルマ処理の一環でしかない。
クソみたいな仕事も間違いなく存在するし、それを粛々とやっても価値は出ない。
その現実にぶつかる日はいつか必ず来る。

あなたはそれで良いのだろうか?

[Meisyo] アップデート方針2020.06

いろいろと更新していましたが、こちらに記載を忘れていました。
今後のアップデート方針を記載します。

今後の方針

1・新規向け:新規登録後の継続者を増やす
 1・データ分析
  基盤ができているので、まずは離脱ポイントがないかか確認する。
  確認後施策を行う。たぶんルート改修かアイテム増強になる。

2・既存の方向け:できることを増やす
 1・ストーリーモード追加
 2・シナリオ追加
 3・試合のパラメータリバランス
  速球が強いかもしれない。ただし、反応Aあれば対応可能なのでどうするかは不明。
  守備が相対的に地位が低いので上げるかもしれない。

「前と変わらない」というのは間違いないですが…。
認知度をもう少し上げて、プレイ人口を増やしたいですね。
広告も高くはないのでぼちぼちやってますが、自然流入を増やしたいところ。

4月~今までやったこと

方針

・新規登録後の継続者を増やす
・試合の選択肢を増やす

詳細

・ストーリーモードの追加
 勘違いから始まるストーリー。
 彼はいったい何者だろうか?

・チュートリアル変更
 ストーリーモードにつなげるために変更。

・挑戦NPCの追加
 新規登録向けの追加。

・シナリオの追加
 奈良を追加

・選手調整追加
 投球・打席を変更可能に。
 選択肢がなかったので。(ただしCPは高い)

・選手の三属性追加

・オリジナル選手の追加
 「自分はこの選手を育てたい」というものを作りたい。
 ただある程度育ててから芽が出た人に愛着を持つので・・・どうしたものか。
 最初にある程度強化資材を渡してみるか?分析次第。
 使用CPは安めだが、なかなか出ない。

・模擬戦の自動実行
 これもデータ分析による。チケットがかなり余っていたので。
 その他にもいろいろと自動化した気がする。

・試合のパラメータリバランス
 速球ー、制球+。
 走力+。守備+。

意外とアップデートをしていました。
ゲームバランスは大きく変わらないものの、違いはわかるかなと・・・

それではまた。

[Meisyo] ver 0.32 リリース情報と2020年4月以降の開発予定について

名将と呼ばれた者達をver 0.32にアップデートします。

更新概要

1・探索の追加
2・探索の追加に伴うゲームバランスの再調整

更新詳細

探索の追加

アイテムを発掘できる動的なゲームシステムを追加しました。
探索機能の詳細は[Meisyo] 探索をご覧ください。

監督・選手経験値獲得はできませんが、その分アイテムの獲得量を増やしています。

探索の追加に伴うゲームバランスの再調整

アイテム獲得量が探索によって増えることが想定されるため、各種アイテムの獲得量を再調整しました。
こちらは適宜変更していく予定です。

2020年4月以降の開発予定について

メインの方針としては、プレイ人口を増やすことに注力していきます。
そのため、基本的なゲーム動線の整備を再度行いたいと考えています。

大きくは、ストーリーや機能の説明を、それぞれのページで自動的に表示されるようにします。
ゲームとして色々な機能はあるものの、それぞれの機能の意味付けがわからないことが多いためです。
※データ分析から見えてきた課題です。この動線がゲームプレイの基本となり、ゲーム体験向上のためのデータ分析の基盤構築の基礎を作る前座となります。

新規実装

  1. ・探索
  2. VS NPC・ボスNPC

  3. ・挑戦
  4. 新NPC追加

  5. ・シナリオ
  6. 低難易度・中報酬のシナリオを追加予定
     春の甲子園がなくなったので地域オリジナル(初回は私の地元の奈良の予定)で作成します。

作者の現状認識

公式戦で優勝することを主体に、練習試合、連盟戦で他チームのユーザーといろいろ試行錯誤しながら、ゲームを進めていくことが楽しいと思っています。
あまり人と関わらなくてもいいし、関わってもいいゲーム体験です。基本はソロゲーですが。

ただし初心者に厳しい点が複数・・・、例えばシナリオの難易度が高すぎる点、特訓の内容(特訓、挑戦、探索)をどれを選んでいいかわからない点、UIや機能の説明がない点などがあります。
そのため、初心者から長く続けてプレイしていただくことが非常に難しいようになっています。

それぞれの機能の位置づけがわかれば、1年くらいは毎日プレイしても頭打ち感を感じにくい(何をしても強くなり、上手くいく)状態になるので、そこを目指したくなるようなゲームの見せ方に変えていきます。
見え方が違うだけで、サービスの体験が変わるのは本業でも経験しておりますので・・・。

あと、私事ではありますが、本業(コンサルタント:エンタメ業界担当)がマネジメント層に昇格した他に、副業(方針設定・アドバイザー?他雑務担当兼エンジニア:生物情報科学系)も始めたので、少々Meisyoの開発が遅くなる可能性があります。
申し訳ありませんが、末永くよろしくお願いいたします。

[Meisyo] 探索

これは何?

名将と呼ばれた者達の1機能である探索(2020年4月実装)について書いた記事です。

実装目的

1・別目的の追加練習を追加したい
 これまでは選手の獲得・育成をメインにした追加練習しかなかったためです。
 探索は、アイテムの獲得およびNPC戦(実装予定)が主な目的で、ある程度選手が育った中級者以上向けのコンテンツです。

2・動的なプレイ体験をしてもらいたい
 限られた時間の中で、自分の操作次第で結果が変わりうるコンテンツが少なかったためです。
 探索は、さまざまな地形による影響を受けながら、アイテムをいかに早く・多く集めるか、ボス高校(NPC)を見つけるかが重要になってきます。
 UIはスマートフォン向けで、直観的に扱えるように工夫しています。操作方法はクリックのみです。

遊び方

少しUIが変更されている部分がありますが、基本的に遊び方は同じです。

1. ロードする

2. 探す

操作はクリックのみ。
画面下にある薄黒色のタッチパネルで、キャラクターの移動する向きを決めます。

3. 探す

地形により侵入不可、HP減少加速、滑りやすいなど効果があります。

・ボスNPC戦
 チケット等を使わずにボスNPC(Meisyoオリジナル)と試合を行うことができます。
 1度試合すると24時間独占挑戦権が得られ、他人には挑戦できなくなります。
 勝利すると、覚醒用アイテムなどが獲得可能。
 詳細はこちら
 イベントなどに使う予定です。

4. 手に入れる

気合の塊をはじめ、その他レアアイテムが多数出現します。
誰も探していないエリアはアイテムの宝庫になる調整を行っています。
※NPC戦を行うとその回の追加練習(探索)は終了されます。

[Meisyo] アップデート予定のお知らせ

名将と呼ばれた者達、今回のアップデートではバランス調整をメインに行います。

まずは謝辞として、Meisyo アンケート 2020/02にお答えいただき誠にありがとうございました。また、ゲーム内でバグなどのご連絡いただきありがとうございました。アップデートの参考にさせていただきました。

今回のアップデートもアンケートから採用させていただいた項目が何個もあります。
方針は基本的に、データ野球の楽しさを多くの人に、より深く楽しんでもらえることを目指しています。
(反対に、プレイする野球だとそもそも他ゲーで良くね?となります。)

まとめたもの → 野球ゲームPJ まとめ

アップデート予定概要

・連盟戦の選手自動登録機能追加
 連盟戦で参加した人が自動で選手登録を行う機能を追加します。
 人数不足で何名か参加できていない人が確認できたためです。
 
・選手枠の追加
 50→100に増加。ただし、追加の50枠は休眠扱いで練習等で経験値が入らない。
 そういった制限を採用するのは、単純に枠を増やすとカードを多く持てるチームが育成上有利になるためです。

今後の予定概要

・探索の追加
 選手の体力を使いながら、時間制限のダンジョンで選手経験値とアイテムを探す。
 たまに投手or野手と対戦して、規定以上なら経験値&特別アイテム、ある条件を満たすと選手を獲得できる。

・新シナリオの追加
 春の選抜甲子園大会(3/19~)を再現。

・選手画像の追加・変更
 Meisyo独自の選手アイコンを作成する。
 パワポケなどではなくて、独自IPにしたい。

・選手属性追加
 苦手な選手・得意な選手がわかりやすいよう緑、青、赤の3属性を追加。
 既存の隠しパラメータ(投球モーションや打撃フォーム、調子2など)は表示・変更されない。
 (選手層がある程度厚くないとマイナス補正は厳しいか。)

駆け出しエンジニアは本当にフロントエンドエンジニアを目指すべきなのか

最近、駆け出しエンジニアをTwitter上で数多く見るようになりました。
ただ、揃いも揃って「フロントエンドエンジニア」になりたい(意訳)とプロフィールに書いてあります。

なぜでしょうか。
それは何が問題なのでしょうか。

私が何を問題視しているかというと、フロントエンドエンジニアってそんなにコストパフォーマンス良くないぞ?ということです。
なぜなら、バックエンド等に比べて要求される技術の種類が多くなりがちであるからです。

そこで今回、給与や技術などの視点から、この原因を読み解いてみました。
※すべてのベースとなる情報科学の知識については全く触れていません。

目次

給与
技術
目指してしまう理由
解決策
あとがき

給与


indeedをはじめ、リクナビネクスト、マイナビ転職、Green等のサイトを確認すると、その他のエンジニアに比べ、給与が10~20%程度低めです。

・フロントエンドエンジニア
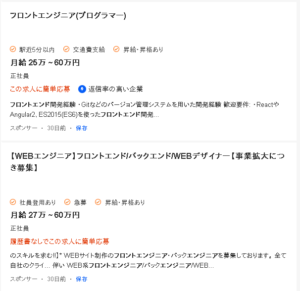
・バックエンドエンジニア
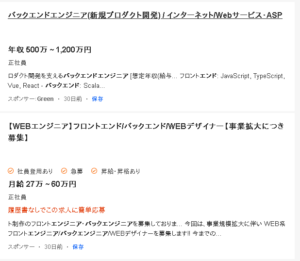
*フロントの20%増しくらいの給与水準でした。
* 同じ待遇にしている会社も確認できました。内部で違っているのかもしれません。

エンジニア職種には数多く存在し、組み込み系やパッケージ系、社内SEもあればインフラ、品質管理等々が存在します。
その中で高いわけでもなく、低めの水準でした。

技術


フロントエンドエンジニアで特に問題なのは、習得すべき技術の種類の多さです。

基本的な技術だけでも大きな差が付きます。

・フロントエンドエンジニア
HTML(表示基礎)
CSS(表示スタイル調整)
JavaScript(動的なページの作成)

・バックエンドエンジニア
PHP(システム基礎:Ruby、Java、JavaScript等も可能)
SQL(データベースとの接続:AWS、BigQuery、RedShift等も可能)

1種類しか違わないのでは?と思いがちですが…、

HTML、CSS、JavaScriptは全く構文が違います。
例示していきます。

HTML

<タグ>~</タグ>を基本とした構成です。

<!DOCTYPE html>
<html lang="en">
<head>
  <meta charset="utf-8">
  <title>タイトル</title>
...

CSS

HTMLで作成したタグやクラス、idごとに表示スタイルの調整を行います。
タグ名 { ~ }です。

/** General Style Info **/
body {
	background: #003d4c;
	color: #fff;
	font-family:'lucida grande',verdana,helvetica,arial,sans-serif;
	font-size:90%;
	margin: 0;
}
a {
	color: #003d4c;
	text-decoration: underline;
	font-weight: bold;
}
...

JavaScript

動的なページを作るために、訪問者の属性ごとなどで条件分岐をさせたり、文字や背景自体を動かしたりできます。
下記はJQueryという過去のライブラリの記法です。

jQuery(document).ready(function( $ ) {

  $('#myTab a').click(function (e) {
    e.preventDefault()
    $(this).tab('show')
  });

  $('.carousel').carousel();
  
  $('#accordion').collapse({toggle: false});
...

PHP

PHPなどは比較的書きやすい言語です。
基本的な書き方はその他の言語(Ruby、Java、Python等)も同じです。
下記はCakePHPというフレームワークの記法です。

    public function LoadCSV($file, array $ycol, array $xcol, $hasHeader=true)
    {
        $xarray = array();
        $yarray = array();
        $handle = fopen($file, "r");

        //if first row has headers.. ignore
        if ($hasHeader)
            $data = fgetcsv($handle);
        //get the data into array
        while (($data = fgetcsv($handle)) !== FALSE)
        {
            $rawData[] = array($data);
        }
        $sampleSize = count($rawData);

        $r = 0;
        while ($r < $sampleSize)
        {
            $xarray[] = $this->GetArray($rawData, $xcol, $r, true);
            $yarray[] = $this->GetArray($rawData, $ycol, $r);   //y always has 1 col!
            $r++;
        }
        $this->x = $xarray;
        $this->y = $yarray;
    }
...

SQL

SQLは最も安定した言語です。
プログラミング言語にしては珍しく、ほぼ改修が入らず学んだことがずっと活かせる言語です。

SELECT
  date,
  COUNT(user_id) AS count_uu
FROM
  action
GROUP BY
  1
ORDER BY
  1

このように、HTML、CSS、JavaScriptは全く構文が違います。
それだけで理解するのが大変だと思います。しかも、実務では構文だけではなく、情報科学のロジックもふんだんに使います。

その他に、より問題だと考えている事柄としては、HTML、CSS、JavaScriptはすべて、技術の移り変わりが激しいことです。

新しい記法や、非推奨とされる記法、さらには動かなくなる記法すら出てきます。
新しいライブラリ、フレームワークと盛りだくさん追加されていきます。

JavaScriptのフレームワークとPHPのフレームワークで種類の数が全く違います。

例:JavaScriptのフレームワーク
AngularJS
Hyperapp
jQuery
React.js
Riot.js
Vue.js

その他にNode.js、Nuxt.js等も・・・それだけ、フロントエンド側で求められていることが多いということですね。よく調べてみると、フロントエンドのフレームワークにも関わらず、バックエンドの知識を当たり前に要求するものがあります。

例:PHPのフレームワーク
Laravel
CakePHP
zend framework
Symfony
FuelPHP

JavaScriptは見る限り、Angular、jQuery、React、Vueは現役です。
PHPもフレームワーク数は同等くらいですが、CakePHPがメインでLaravelが増加してきており、メインで使われるフレームワークは決まっている状況です。

バックエンドエンジニアですと、SQLは安定しているため、学習し続けるべきなのはメイン言語+αで済みます。
フロントエンドエンジニアは、進化し続けるHTML、CSS、JavaScriptをはじめ各種フレームワークの学習が必須です。

ちなみに、フロントエンドエンジニアの宿命として、デザインや触り心地の言語化、直感等も必要になってきます。
サーバーサイドエンジニアはサーバーとの通信速度(アルゴリズムの適正さ)やバグの少なさ、コードを書く速度等で能力は定量化しやすいですが、フロントエンドエンジニアはコードだけではない能力が要求されます。

そこまで頑張って得るものは多くはありません。
確かに自分で0 → 1ができるのは大きな強みですが・・・。

私が言いたいのは、
なぜフロントエンドエンジニアを(メインで)やりたいのか?
その他のエンジニア職種では何がダメなのか?
ということを彼らが理解しているしているのだろうかということです。

現役のエンジニアやIT業界の人に聞けばいいのに、と。

目指してしまう理由

一番目:わかりやすさ

表示側を作るのは素人にもわかりやすいし、今風のカッコいいサイトが作れるようになりそうですよね。(実はそんなに簡単ではないですが・・・)
自慢できる職業だと思います。

二番目:情報発信の多さ

フロントエンドエンジニアは数の多さと認知度の高さから、職業に関する情報発信がされやすい傾向にあります。

組み込みエンジニアの情報発信を見たことありますか?

僕はあまりに見かけない印象です。
情報を必要としている人が少ないですし、目立つ職業ではないので内々の情報交換や技術書での学習が多いです。

QiitaやTeratailなどが人気なのも要因でしょう。
フロントエンド以外の技術は基本的に見ないか、原典(説明書)および論文が仕事への理解として一番早いです。

日本語のやってみた記事は数多くあるのですが、コードだけ(何を考えてこのコードを書いたか説明がない)だったり、理解せずに数式をなんとなく書いてある(使用上の注意点が書いていないことやミスリードしている)記事が散見されます。
* QiitaやTeratailは良いサイトです。使い方を間違えなければ。
* 記事が転職等の実績として利用されつつあることに起因するのかもしれません。

それらの発信を職業にしている人も存在します。
そうです。インフルエンサーです。

オンラインサロン
自社開発
フリーランス

どれもキラキラワードですね。
ただよく考えてほしいのは、元々エンジニアの人たちがなぜそうなっていないのか?ということです。
彼らには本当かどうかを現役のエンジニアやIT業界の人に聞けばいいのに、と思いますね。

知っている方が動画配信をしているので以下をどうぞ。私の認識とほぼ同じです。
エンジニアのキャリアハックを配信「IT人事の毛呂淳一朗」

三番目:日本の現状と転職市場の活性化

日本の平均年収は400万円台です。
ちなみに、平均値は上位の値に引っ張られやすいので実情とは異なります。

例)4人(300万、400万、500万、1000万円)の平均年収
 ⇒ 550万円!??
一人が異常に高ければ、すぐに上がります。
それだと実感と合いませんよね。

実感に近い値としては、中央値で約350万円です。それ以下の人が約50%も居るのですが…。

IT業界は東京に一極集中していることもあり、ジュニア(駆け出し)レベルでも350万~が基本です。

・・・あれ?中央値を超えてない?

超えています。そういうことです。

つまり、低い年収をどうにかしたい人たちの入り口になっています。
それで駆け出しの方が多くなっているのかなと考えました。
(私はこの流れ自体は問題とは思っておらず、正常だと思っています。新しい産業にもっと人が移動すればいいとも思っています。)

ちなみに東京近辺は家賃以外は全然物価は変わらないです。

家賃は東京23区>東京郊外>千葉・さいたま等です。
住所を東京から千葉にすれば、ほぼ条件が同じような場所かつ駅にも近いのにも関わらず3~4万家賃が安かったです。

物価の面でいうと、東京・千葉は地方(例:奈良(実家)、栃木(前職)、熊本(大学・大学院))はほぼ変わりません。
野菜や地域の名産品が安いかな、でもそんなに変わらないかなという状態です。

ただし、東京は外食だけは高い・・・。ランチだと1,000円オーバーが当たり前でちょっと面食いました。
家賃が高いので仕方がないのですが。

解決策


複数の現役のエンジニアやIT業界の人に聞く、つまり一人だけを信頼するなという二点さえ注意すればよいです。

よくあるのは、
・給料が良さそうなので
・まともな労働環境で働きたかった
・友人に勧められて

だから、フロントエンドエンジニア・・・というのは少し安直ではないでしょうか。

なぜフロントエンドエンジニアをやりたいのか?
その他のエンジニア職種では何がダメなのか?
という問いは必ず付きまといますし、転職した後にもついてきます。

あなたが納得した道を選んでほしい。
その思いでこの記事を書きました。

あとがき


著者も29歳で製薬企業研究開発職からIT系職種(データ分析コンサルタント:機械学習や統計を企業の事業・業務方針コンサルティングに活かす)に転職した当人として、今の流れは危険だなーと思い記事を書きました。

もちろん、働いている場所によって定義が少しずつ異なるので、「あれ、これは書いてあったことと違うぞ?」と思うかもしれません。
バックエンドの方は内容によって複数言語を扱うのが基本だったり、サーバー側で突発的かつ大規模なアクセス増加に対応するためのクラウドであるAWSまたはGCPなどの知識が必要だったりと…。
実際はもっと複雑な問題なのですが、理解の簡便化のために問題を切り分けてお伝えしています。

元々趣味でプログラミング・HP作成をやっていたこともあり、フロント(HTML、CSS、JavaScript(JQuery他))もバック(PHP、Python、Perl、C系、MySQL)もインフラ(Linux)もちょっとはできる程度でした。

そういった経歴もあり、フロントエンドエンジニアも少し考えていた時もありましたが、上記懸念(技術更新早すぎやろ)もあり、デザイン系のセンスもないしでやめておきました。
昔は「JavaScriptはクソ」という扱いが基本でした・・・私は使ってましたけど。・・・それくらい大きな変動が10年以内でありました。

あなたは何がしたいですか?

どんなことに興味がありますか?(または、どんなことが許せませんか?)

カッコいいことに引っ張られていませんか?

これは自戒を込めて書きました。
私は今流行りのデータサイエンティストと名乗れます。でも、それは間違っていると思います。
実際の仕事は機械学習、統計解析の手法「も」使いますが、ビジネスサイド寄りです。
職種名はビジネスアナリストが非常に近いです。
エンジニアの方とも、データサイエンティストの方とも、コンサルタントの方とも働いているので、少しは目端が効くようになってきました。

・お客様にいかに現状を認識していただくか
・どこに事業の問題点があるか
・どうすればユーザーの苦しみを解決でき、事業が伸びるか

この3点を一緒に考えて、並走しています。
以前取れなかった(らしい)契約継続もしていただきましたし、満足度も高いのかなと思います。
事業を良くしていくことが非常に面白いですし、誇りに思っています。(給与はまだ安いけどね)

そんな職業に一人でも多くの人が会えるよう祈っています。
ちなみにTwitter > R(あいれい/おいす)で相談していただければいつでも対応します。
プログラミングの基礎をはじめ、統計や機械学習の手法や就活等もなんでも相談してください。
ただ、一人だけを信頼するなは気にかけておいてください。

それでは!

おすすめ記事

この記事を読んだ方には、下記の記事が読まれています。

未経験がエンジニアを目指すことって、それって意味あんの?
決定木分析(Python CHAID)を解釈する

意思決定のために使用される決定木分析

Scikit-learnでの決定木にはCART(指標:giniまたはentropy)他が採用されています。
CARTは下記の2点を含め、さまざまな理由から使われていません。

  1. 2分岐のみのため単純すぎる
  2. 過学習させるアルゴリズムのため、小さすぎる区分が出現するので扱いにくい

コードは以下の通り非常に簡単です。

from sklearn import tree
clf = tree.DecisionTreeClassifier(max_depth=3)

(参考:scikit-learn で決定木分析 (CART 法))

実務では各種BIでのCHAID(指標:カイ二乗値)が使われています。
利点としては、以下の2点が大きいです。

  1. 多分岐
  2. 過学習する前に学習を止める

Pythonには決定木(CHAID)の一般的なライブラリがないので、今回はライブラリCHAIDを紹介します。

概要

下記のツイートにまとめています。
まずはREADMEを読んでCHAIDをインストールしてください。
GraphvizとOrcaのインストールは項目Exporting the treeをご覧ください。

Graphvizインストールできない問題の対策

Windows10の場合、pipではなくcondaで入れるとうまく行きました。

conda install graphviz
conda install python-graphviz

Graphvizのbinとdot.exeまでの環境パスは通しました。

CHAIDテストコードにCSVを読み込ませる方法

下記コードで対応可能です。

df = pd.read_csv('sample.csv')

col_answer = 'flag_keizoku'
ndarr = df.drop(columns=col_answer).values
arr = df[col_answer].values

検証

CHAIDとBIツール(今回はSPSS)との差分を検証しました。

検証方法

実データから決定木を出力してみる。

説明変数

ある2週間(1-14日)にログインしたユーザーの総ログイン日数
*開始日を1日目としてカウント
*値=1~14

目的変数

ユーザーごとの15-28日目の継続有無
*ログインしたかどうかで判別
*値=0 or 1

結果概要

SPSSだとある程度グループ化されるのでしきい値の判断はしやすいが、CHAIDはグループ化されず数値が前後してしまうため解釈が難しい。
解釈のために使っているのに、解釈が難しいとは・・・使えないやんって話です。

結果詳細

SPSS


グループは7個できました。
[1], [2], [3-5], [6-8], [9-11], [12, 13], [14]

CHAID


グループは11個できました。
[1], [2], [3], [4], [5, 7], [6, 8], [9, 10], [11], [12], [13], [14]
*個体数nが描写されない問題。コードでの確認は可能ですが、可視化したグラフとしては使いにくい。

結果解釈

前の2週間のログイン日数が多いほど、次の2週間でいずれかの日にログインしている可能性が高い。

うん、そうだね・・・(当たり前)としか言えないのですが、どれくらいの日数ログインしていないと継続しにくいか?を知るには良い結果となります。

14日ログインしている人のうち、3.8%がログインしてないってまずくない?という感じで解釈していきます。

その他には、時系列で比較することで、継続率の効果検証を行うことができます。

仮説:継続を構成するユーザーのうち、どの層のユーザーの継続率が上がったのか?
→ 全体的に上がったのか?
→ 特定のユーザー層にのみ効果があったのか?

のように細かく調査することができます。

このCHAIDの何が問題か

決定木分析はあくまで、いい感じで区分を作り、その結果を解釈して施策に繋げるために行っているので、グループ化があまりに細かく、理解しにくいモノだと使えません。

SPSSに比べ、CHAIDのカイ二乗値は高いですが、適切なグループ化をしていないので、人が使うためには、このCHAIDはめちゃくちゃわかりにくい。

結局、意思決定のために分析をしているのに、読み取れない…のようなことが起こりえます。

そういった懸念点があっても、このCHAIDは無料ですので、コスト面を考えると使う価値はありますね。SPSSはライセンス料がかなーり高いので、個人で要因分析する分にはCHAIDで問題ないでしょう。