Jupyter NotebookでPandasのDataFrameを表示する際、行数・列数が多すぎると省略されてしまう場合があります。
制限を解除しましょう。
pd.set_option('display.max_rows', None)
pd.set_option('display.max_columns', None)
Noneに設定するだけで、すべての行・列を表示可能です。
ただし、行・列数が多すぎる場合、読み込みに時間がかかる場合がありますのでご注意ください!
Webサービス制作のための技術情報を。データ分析(Python、機械学習コンペ他)や自作野球ゲームMeisyoのこと中心。
Jupyter NotebookでPandasのDataFrameを表示する際、行数・列数が多すぎると省略されてしまう場合があります。
制限を解除しましょう。
pd.set_option('display.max_rows', None)
pd.set_option('display.max_columns', None)
Noneに設定するだけで、すべての行・列を表示可能です。
ただし、行・列数が多すぎる場合、読み込みに時間がかかる場合がありますのでご注意ください!
自然言語処理(BERT、GPT-3)および画像認識(ViT)等で以前のState of The Artモデルを超える精度を発揮したTransformer(元論文:Attention Is All You Need)を元にしたモデルたちが存在します。
その中で、BERT: Pre-training of Deep Bidirectional Transformers for Language Understandingという、2022年現在では自然言語処理ベーシックとなった手法が存在します。
ベーシックになった一端として、MaskedLMと呼ばれる学習方法があると私は考えました。
大規模なデータセットから、モデルを用いて表現学習する際に、教師ラベルを付与する必要がなくても問題がないことを示したからです。
例えば、Deep Learningが注目されるきっかけとなったImageNet Large Scale Visual Recognition Challenge(ILSVRC)は、画像に物体のラベルを1:1で付与したデータセットImageNetを利用しています。
そこで問題となるのは、教師ラベルを付ける工数やその整合性です。
工数は、AIアノテーションの意味とは?タグ付け自動化ツール17選を比較のような製品群ランキングが出てくるように喫緊の課題とされています。
整合性については、現実問題、データ量があまりにも多すぎて検証しようがない状況ですが、近年、AIの専門誌ではないテック系メディアのWiredにAIの基盤となるデータに「ラベル付けの間違い」が蔓延、その影響の深刻度が掲載されるような状態です。
そのように、ラベルを付与する手間や正しさが分からないまま教師あり学習を行うとノイズが含まれる結果となり、ノイズなしのデータと比べてどうしても精度が落ちる(A Chat with Andrew on MLOps: From Model-centric to Data-centric AI)ということが分かっています。
その点、教師なし学習で表現学習ができるMaskedLMは、もともとのデータ(文章)が膨大なメンテナンスコストをかけて整備され続けてきたもの(例:Wikipedia)であれば、ノイズはほぼ含まれていないであろうと考えられます。以前は、教師なし学習でそのような大規模な学習は不可能でした。
そのため、MaskedLMは画期的であろうと私は考えました。しかも、画像処理より難易度の高いと考えられている自然言語処理て、事前の表現学習が可能となりました。
もちろん、画像処理においても、現在ではさまざまな教師なし学習(例:Contrastive Learningの2大手法SimCLR・MoCo、それぞれの進化 (画像の表現学習2020夏特集2))が提案されていることは忘れてはならないかと思います。それは、MaskedLMが提案された後です。
では、実装したコードを示します。
R2002/NLP_MaskedLM
・Pytorchでの実装です。
・利用される場合はrequirements.txtをpipでインストールしてください。
・学習用テキストは太宰治「走れメロス」を利用しています。
学習方法は、マスクしたトークンを周辺のトークンから推測します。
トークンとは、与えられた文を形態素解析し、1つ1つの意味(チャンク)に分けられた後の語のことを示します。
例えば、文をメロスは激怒したとすると、
形態素解析後にメロス/は/激怒/したのように分けられます。
そのうち、メロス、は、激怒、したというそれぞれの語をトークンと呼びます。
MaskedLMは、そのトークンをランダムにマスクし、下記のようなデータを生成します。
説明変数:
メロス は [MASK] した
目的変数:
激怒
そのため、教師データが必要ありません。学習用データを自分自身から作ることができます。
そのため、膨大でかつ品質が担保されたデータがあれば、人に比肩するような精度を持つモデルが作れた理由の一端として、私はMaskedLMが非常に重要なのではないかと考えています。
※正確な説明はBERTによる自然言語処理入門 ―Transformersを使った実践プログラミング―など専門書をご覧ください。
今回はBERTでのMaskedLMの学習方法となぜ重要なのかを確認しました。
BERTの提案は2019年ですので、2022年まででまた大きく技術が進歩したと考えています。
ただ、MaskedLMをはじめとした学習方法が持ち込んだ問題点としては、膨大なデータがあれば、良いモデルは学習できる・・・が学習できる環境は整っているのだろうか?ということです。巨大な計算リソースがなければ大本となるモデルは作れない、つまり、大企業や潤沢な研究資金・資材が得られない環境であれば、新しいことができなくなるのではないかということです。その分、転移学習などで利用は簡単になりましたが・・・。
今回、GitHubで示したコードの条件下(CPU利用)でも、走れメロスのみで30分近くの学習時間がかかりました。計算資源がディープラーニングの制約にのような記事も散見されます。
研究の流れとして、精度がある程度満たされれば計算速度が追及され、計算速度が要求以上になれば精度を求める・・・のような揺り戻しは来ると思います。
機械学習系のコンサルタントとして、今後もBERTを追っていきたいと思います。
以上、れいでした。
私が思うに、MaskedLMの改善手法として下記がありそうだなと考えていました。
1・Mask割合を変動させる
2・復元抽出を行って再度Maskしなおす
今回は、(1)が論文において実証されたようです。
Masked Language Modelingにおいてマスク割合増加は悪影響を及ぼすと信じられていたが,
・デフォルトの15%より40%の方が良いこと
・大きいモデルほど割合を増やした方が良いこと
・MASKトークンのみによる置換でも凝った方法やBERT元論文手法と同等の性能が出ること
を示したhttps://t.co/azJkg81EtL pic.twitter.com/ztxks4OaEJ— ELYZA, Inc. (@ELYZA_inc) February 28, 2022
プログラミング始めてみたい(始めてる)けど、パソコン用意したいなあと思った時、ググってみるといろいろ情報がありすぎて困ったあなた。
PC・プログラミング歴20年以上私が見るに、アフィリエイト(個人で行う企業広告)に毒された記事群が散見されました。困りますよね。。
これ・・・初心者は判断できないのでは?ということでアフィリエイトなしの記事を書きました。
用意したい金額の前提として、下記のように読者を想定しています。
リーズナブルにプログラミングの初歩を学びたいなら。新品価格であれば3万円程度で十分です。
プログラミング楽しいな!プログラミングをより詳しく学びたいという方は、5万円くらいで十分です。10万円程度のPCも紹介していますが、ガッツリやりたい、趣味になってしまった人向けです。
注意点としては、皆が知っているような日系大手メーカーのPCは残念成分(価格、性能、ソフト他)が多分に含まれています。最近の店頭に出ている商品でも、不要なソフトがてんこ盛りなので買う意味を個人的には感じません。
話は少し変わりますが、PCには備品が必要です。なぜなら、備品によって作業効率が段違いになります。備品はソフトとデバイスを紹介します。
ソフトは、私の専門でデータサイエンス(統計・機械学習)で必要なものをピックアップしました。ふつうにプログラミングをする分には不要です。Excel(エクセルやCSVファイルに対応)、PowerPoint(分析では使わないが報告には必要)があればOKです。
デバイスは、作業や学習効率アップのために必要であれば購入ください。
それでは紹介します。
まとめ
・OS:Windows
・大きさ:14型
・性能:要注意
Windowsが実用上良いです。日本のITの現場において、利用環境がWindows準拠が多いからです。
バージョンとしてはWindows10でOKで、Windows11である必要はないです。
本格的なプログラミングをする場合は、MacやUbuntu等になる可能性もありますが、その際は知識がついているので判断が可能になります。
14型かそれ以下がおすすめです。
14型はノートPCとしては個人の感想ですが大きめに感じます。17型は大きすぎる可能性があります。カバンによく入れるなら13型以下にすべきでしょう。
ここは特に、家電量販店で見て触れて決めてほしいところです。
最重要ポイントです。高性能と銘打って売られているPCも実は・・・ということは多くあります。
CPU(処理装置)、メモリ(作業台の大きさ)、HDD(記憶装置)、グラフィックカード(画面描写の速さ)の視点で解説します。
インテルの第10世代i5で十分です。インテルHPに記載があれば問題ありません。比較サイトもありますので、よさそうなPCまたはCPUがあれば自分で調べてみてください。
最低8GBは欲しいです。16GBはそこまで必要に感じません。ただし、4GBだとWindowsの動作だけでカクカクになる場合があります。
最低250GB欲しいです。Windowsの場合、OSち基礎ソフトで150GBくらいは使います。
より読み込み・書き込みが高速な種類(SSD)もあり、立ち上げが早いなどのメリットがあります。ただ、プログラミング初心者がそこまでこだわる必要あるか?とは感じますね。筆者はこだわっているのでSSDですが。
ノートPCで一般的に採用されているオンボード型で問題ありません。
動画編集、深層学習のモデル作成、ゲームをしないのであればGPUは不要です。
64,130円
上記に書いてある条件はほぼすべて満たしています。
詳しくは、レノボのHPをご覧ください。
96,580円
ちょっとハイエンドよりでプログラミングをガッツリする人向け。これ以上ははっきり言って不要です。よりローエンドのPCもあります。
詳しくは、ドスパラのHPをご覧ください。
より見た目重視なら、下記がおすすめです。ただ、値段が高いですね・・・。
Microsoft Surface
Huawei matebook X Pro
基本的にMicrosoft Officeで良いですが、PCによって同梱品が変わります。基準価格を知ってお得に購入したいですね。
買い切り:38,284円
高い・・・。Word、Excel、PowerPointが含まれています。
サブスク:1,284円/月(12,840円/年)
Word、Excel、PowerPointが含まれています。
高いなあと思う方は、下記ソフトをお勧めします。
買い切り:5,690円
Word、Excel、PowerPointの代用アプリ。操作性は少し違いますが、機能は十分です。
はっきり言ってお勧めしません。
Officeと(互換性があると言っているが)互換性がなく使いづらい。エクセルやパワポをOffice純正からOpenOfficeに変換すると元に戻せないことも・・・。
デュアルモニタに利用します。作業効率UPならこれが一番です。作業机における大きさで安いモノで十分OK。
ノートPCにもあった方が良いです。キーボードのコマンドで高速に操作できる人はごくわずかです。
不要です。気に入ったキーボードがついてるノートPCを買うべし。
こだわるならデスクトップPCにした方が安上がりかもしれません。
PCのスペックはいろいろあって困りますよね。今回は最低限、プログラミングができる内容で設定しました。
最後は、店頭に行き、フィーリングが合ったものを買うといいと思います。長い時間使うので、「おすすめと言われていたから」では続かない可能性が高いです。ストレスも減りますし。
それでは皆様、良いプログラミングライフを!
「プログラミング、興味はあるけどどう始めたらいいのかわからない。」というあなた!まずは、丁寧な説明と図、問題集までついたこの1冊(無料PDFあり)で入門してみませんか?
内容を確認しましたが、ここまで丁寧にわかりやすく、網羅的に説明した書籍はなかなかないと思います。自社の未経験者の教科書にしてもいいくらいです。
気に入ったら本の購入をお勧めします。
三谷純
なし
Pythonの基礎的知識
プログラミングの基礎
その他の教材紹介ページはこちら → Skill Stacks
筆者は仕事柄Pythonのコードレビューをすることが多いのですが、まれにPandasに行を追加する最適な方法で相談されることがあるので、今回書きました。
まず言えることは、Pandasの標準的なappendは使わない方がいいです。
では、何を使えばいいのか?ということで、今回主要な方法で実験してみました。
2カラム(どちらもランダムな数値)を追加していく。
1万回繰り返した時に、どの方法が一番早いか平均値で比較する。
比較した7つの方法のうち、比較的早い3つの方法をピックアップして処理時間の統計情報(n=1000)を取得しました。


統計的に判断した結果、最速はPandas from_dict key=’columns’でした。
次点はList Appendで、3位はPandas from_dict key=’index’でした。
各々、使いどころが違うのでご注意ください。
記法が他と比べ少々独特で、列思考でプログラミングする場合はこちらが良いでしょう。実行時間のばらつきも少なく、処理が他に比べて安定して早いです。
dict_col = {'input_a': [], 'input_b': []}
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    dict_col['input_a'].append(a)
    dict_col['input_b'].append(b)

df = pd.DataFrame.from_dict(dict_col, orient='columns')
ただし、実務において列思考でプログラミングすることはあまりなく、コード1行で1列を指定しなければならない面倒さはあります。書く量が増えることによってバグの温床になりえるので注意が必要です。
何度も繰り返し、今後変更がない部分であれば導入してよいと思われます。
一番シンプルで書きやすく、変更しやすいです。筆者も実務でのPoC(概念検証)や、MVP(最低限の機能を実装したプロダクト)作成の際にはこちらを使っています。
list_temp = []
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    list_temp.append([a, b])

df = pd.DataFrame(list_temp, columns=['input_a', 'input_b'])
ただ、計算時間が1位に比べ20%増加するため、PoC以降で採用し続けるかどうかは不明です。
こちらもシンプルな記法です。
dict_idx = {}
for i in range(iter_num):
    a = random.randint(50, 100)
    b = random.randint(50, 100)
    dict_idx[i] = [a, b]

df = pd.DataFrame.from_dict(dict_idx, orient='index', columns=['input_a', 'input_b'])
ただし、index(コード中i)を定義できない場合は使用できません。データにIDが割り振れる場合は、データの意図しない複製が出ないことは評価できるポイントです。
結果詳細はhttps://github.com/R2002/Pandas-Appendをご覧ください。
0.028s
0.063s
「Numpyは早い」というのは行列計算が早い。Appendは遅め。
5.349s
純正のAppendは使うのをやめときたいですね。
3.368s
Concatの方がAppendより早いの何でだろう。
7.459s
Locで行指定すると一番遅いのね。
0.026s
0.023s
いろいろな手法がある中で、今回の実験条件での最速はPandas from_dict key=’columns’でした。ただし、おまけで比較した結果、カラム数が増えるとList Appendが最速です。
このように、実験して比較すること(実験計画法の利用)で、さまざまな条件下での結論を出すことが可能となります。いろいろ試してみてください!
カラムを増やして比較たが、結果的に傾向は変わらず。
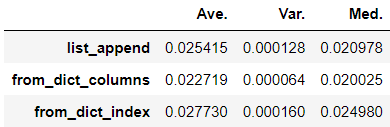
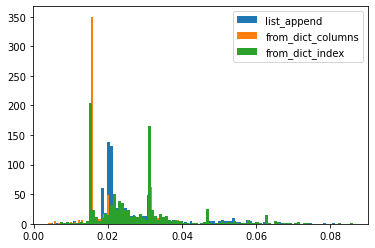
「今回は行を増やす方法を比較したが、列が増えると極端に遅くなる手法があるのではないか」という仮説でしたが、そんなに大きく変わらない可能性がありますね。
※結果は、https://github.com/R2002/Pandas-Append/blob/main/AppendTest(AddColums).ipynbを参照してください。利用環境によっても変化する可能性があります。
追加で、ループ数を1万から100に変更した。
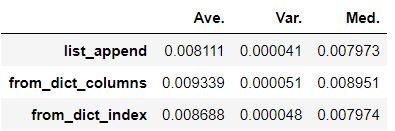
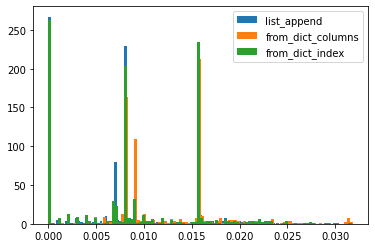
List Appendが処理速度1位になりました。つまり、ある程度カラム数が少ない場合は、Pandas from_dict key=’columns’が最速で、カラム数が多くなるとList Appendが最速になります。
※結果は、https://github.com/R2002/Pandas-Append/blob/main/AppendTest(AddColums2).ipynbを参照してください。利用環境によっても変化する可能性があります。
近年目覚ましい発展を遂げた機械学習、ディープラーニング。その概要と技術の使い方を体系的に学ぶにはどの本がいいでしょうか?
私はこの本をお勧めします。
なぜなら、ディープラーニングについて、最先端の研究をリードする日本で数少ないユニコーン企業、Preferred NetworksのCOO(2022年2月現在)である岡野原さんが書いており、非常にわかりやすく、網羅的に書かれた本だからです。ある程度実務経験を積んだ私でさえ、学びなおしに最適なほど網羅性があります。
では紹介します。
岡野原大輔
ディープラーニングを支える周辺技術について、人工知能の歴史を紐解き、基礎~発展まで網羅的に説明します。
もちろん、機械学習の基礎についても触れます。
そこで重要な役割を果たした人や技術について、絵をふんだんに使った本です。数式もたまに出てきます。
これを読むことで、ディープラーニングでどのようなことができそうなのかなど、新規サービスについても考察を深めることができます。
高校レベルの数学の知識
基礎知識, 機械学習, ディープラーニング, 表現学習, 画像認識, 音声認識, 自然言語処理, 正規化層, スキップ接続, 注意機構(Attention)
その他の教材紹介ページはこちら → Skill Stacks
「音声合成やってみたいけど難しそうだなあ」
私もそう思っていました。
私が使おうとしたきっかけは、大量の青空文庫の書籍を機械に朗読させたいと思ったからです。
そこで、調べてみるとできるということが分かりました。
WindowsのノートPCでも時間を掛ければできるし、これはスゴイ!
ただ、実際のコードを追ってみると技術(言語特徴量抽出、音響特徴量予測、音声波形形成)の複合体なので実装はツラい。orz
さらに調べてみると、Pythonにttslearnというライブラリがあり、なんと6行程度で実装が可能・・・!
これはスゴイ。
それでは、今回は成果物を交えて音声合成の技術書を紹介します。
「日本語音声合成のデモです。」という短い文の音声を作成しました。
数秒
https://r9y9.github.io/ttslearn/latest/notebooks/ch06_Recipe-DNNTTS.html
聞いたことある感じやな~
03:54(PC1+GPU使用あり)
06:04(PC2+GPU使用なし)
https://r9y9.github.io/ttslearn/latest/notebooks/ch08_Recipe-WaveNet.html
「です」がちょっと違和感あるなあ。。
計算時間もかかるし、これはDNNの方がいいかな?
03:07(PC1+GPU使用あり)
04:51(PC2+GPU使用なし)
https://r9y9.github.io/ttslearn/latest/notebooks/ch10_Recipe-Tacotron.html
えっ・・・?すごくないコレ…?
めっちゃ自然やねんけど。
ttslearnで利用されているモデルは非商用で使うことが可能です。ライセンスなどの詳細は公式サイトをご覧ください。
今回は3つのモデルのみ紹介しましたが、これが音声合成のすべてではありません。そのため、公式サイトに目を通してから利用されることを推奨します。
※過去からの積み重ねがあるので、そちらを読んでいただきたく。
※本を通読しましたが、数式に圧倒されるかもしれません。
Windows環境ではttslearnをインポートできない可能性があります。
そのため、その回避方法を下記に書いておきます。
pyopenjtalkからダウンロードします。
※バージョンが上がるとディレクトリ構成が違っているため、対応が難しいかもしれません。
mecab/src/config.hを3点編集します。
/* #undef HAVE_WINDOWS_H */
を
#define HAVE_WINDOWS_H 1
/* #undef VERSION */
を
#define VERSION "1.10"
#define HAVE_DIRENT_H 1
を
// #define HAVE_DIRENT_H 1
openjtalkの(setup.pyがある)メインディレクトリで、下記コマンドを実行します。
pip install -e .
ttslearnがインストールできるはず!
https://github.com/r9y9/pyopenjtalk/issues/10
https://twitter.com/yamori81/status/1426918620676853769
GALLERIA ZG Core i9 9900K/RTX2080/メモリ16GB K/08430-10a
ゲーム用タワーPC。一昔前のものだが、まだ現役で使えそう。
THIRDWAVE DX-T7
ノートPC。意外と計算速度が速かった。
青空文庫関連の競合サービスは意外と少なく、文学作品を読める、人の朗読、Androidでの朗読・・・と色々あるものの、本を読む(聞く)間にある、さまざまな意思決定を円滑にする技術(文、音声、要約、検索、しおり、、etc)がどのサービスも所々抜けていて、中年層~ご老人に向けて刺さるような包括的なサービスになっていないので勿体ないなと。
しかもアクセス解析サイトで見てみると1サイトで月100万PV超えているものが複数。コレはびっくり…(@@;
移動時間でも、仕事前でも、就寝前でも、病院でも読める(聞ける)ようなサービスとなるとデバイスを問わないWebが一番楽ですかね。
ちょっと作ってみよう。
今回は音声合成を試してみました。
Tacotron2のなめらかさには驚かれたかと思います。
それではまた~(^^ノ
今日では、さまざまなデータが収集され、判断の自動化や数値予測の高度化が行われています。
そのAIの判断、どう説明すればいいかわかりますか?
エクセルのようなテーブルデータだけでなく、画像やテキストに対しての判断基準の説明は、意思決定に必須でしょう。
本書はそれらの技術を網羅的に確認します。
大坪直樹ら
さまざまな機械学習を説明するXAI技術の研究が進んでいます。
私たちは幅広い実務でAIを利用し、成果を上げるために何ができるでしょうか?
そこには、現場の利用者に納得してもらってこそ、常に使われるモノになります。
今回の書籍は、その納得を引き出すための技術の解説書です。
XAIのさきがけとなったLIMEや、画像でのXAIであるGrad-CAM、テーブルデータで必須のSHAPなどが説明されています。
どんなデータが来ても、ある程度対応できるようになるので、ぜひ読んでみてください。
機械学習の基礎的な知識
高校数学レベルの数式を読む力
Python
テーブルデータ・テキストデータ・画像データなどに対するXAI理論
LIME、SHAP、Permutation Importance、Partial Dependence Plot、Tree Surrogate、CAM/Grad-CAM、各種ライブラリの使い方。
こちらは、【教材紹介】機械学習を解釈する技術に比べ、データの種別ごとのXAIなど大局的な説明が多いです。
その他の教材紹介ページはこちら → Skill Stacks
多くの企業で導入されるようになってきた機械学習。
その機械の判断基準、本当にわかっていますか?
今回は、実務に利用するために最低限の技術として、変数(特徴量)の重要度や変数と予測値の関係性を求める方法を解説した書籍を紹介します。
森下光之助
地味な表紙をしている本書。
ただ、内容は今後とても重要だと考えられます。
なぜなら、新聞でよく出てくるようなAIの解釈性を担っているのは、ほとんどがこれらの技術だと言って過言ではありません。
特徴量の重要性、変数と予測値の関係性、個別サンプルの予測説明。
そして、それらをまとめて確認できるSHAP(SHapley Additive exPlanations)。
テーブルデータに利用するそれらの方法を、ライブラリと簡単な数式で読み解きます!
機械学習の基礎的な知識
高校数学レベルの数式を読む力
テーブルデータに対するXAI理論
Python、機械学習の解釈性の定義、線形会期モデル、Permutation Feature Importance、Partial Dependence、Individual Conditional Expectation、SHAP(SHapley Additive exPlanations)
こちらは、テーブルデータを重点的に説明した書籍です。いろいろなデータの大局的な説明が必要な場合は、【教材紹介】XAI(説明可能なAI)をご覧ください。
その他の教材紹介ページはこちら → Skill Stacks
予測のためのデータ前処理(加工)にはさまざまな手法があります。本書では、非構造化データを中心に「予測するために」データ分析を進めていきます。前処理と銘打たれていますが、どちらかというとデータ加工のテクニックを記述した本です。
足立悠
構造化データ、非構造化データにはデータの前処理(加工)という難題があります。非常に手間暇がかかり、かつ分析モデルの精度に大きく関わってきます。今回の書籍では、非構造化データを中心にデータ加工から予測モデルの構築まで、分析フレームワークCRISP-DMをベースに話を進めます。
この書籍は前処理というより、加工の本だと思われる。下記の定義の前処理なら、必要知識にある前処理大全がおすすめ。
データ分析の用語、加工と前処理で定義されていない気がする
前処理:データソースからデータマート等を構築するために必要な処理。
↓
加工:データマートから、より重要な特徴量を作成するための処理。
↓
モデル作成みたいな
— R@データ分析&ゲーム制作 (@Rei_Farms) January 17, 2022
Python, 欠損値補完, 不均衡データの均衡化, 正規化, クラスタリング, 次元削減
画像データの加工, 時系列データの加工, 自然言語データの加工
その他の教材紹介ページはこちら → Skill Stacks